Voodoo Dynamic Quant开源:用梯度下降优化模型量化
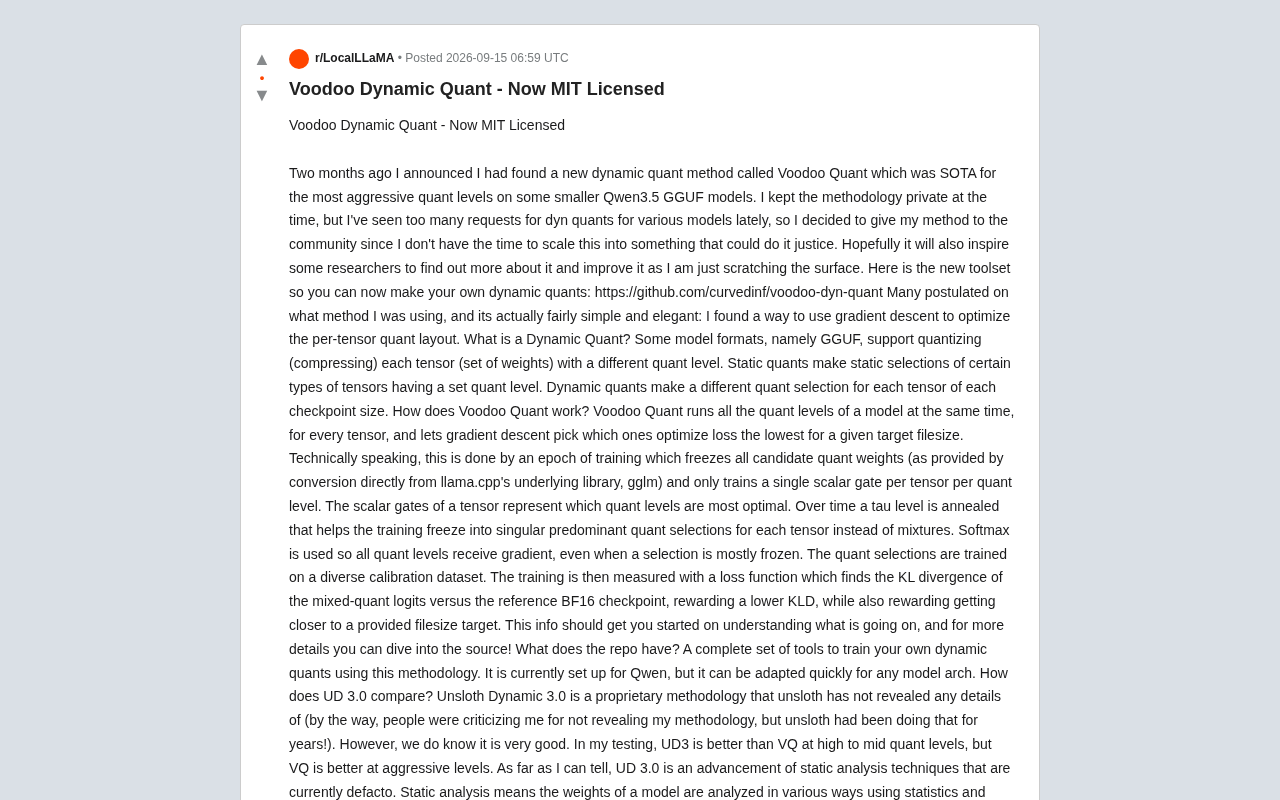
Voodoo Dynamic Quant 开源:首个用梯度下降为每个张量自动选择最优量化精度的动态量化工具。
开发者 curvedinf 将其动态量化方法 Voodoo Dynamic Quant(VQ)以 MIT 协议开源。VQ 的核心创新在于用梯度下降优化逐张量的量化布局:为每个张量的每个候选量化档位训练一个标量门控,结合退火机制最终收敛到单一最优档位。损失函数同时考量量化模型与原始 BF16 模型的 KL 散度,以及目标文件大小约束,让用户可直接指定压缩体积。在激进低比特量化档位上,VQ 优于业界知名的 Unsloth Dynamic 3.0,中高档位则后者更强。目前该项目属研究级别,仅在 Qwen 系小型模型上验证,作者期待社区将其扩展至更大规模场景。
开发者 curvedinf 宣布将其此前保密的动态量化方法 Voodoo Dynamic Quant(Voodoo Quant,简称 VQ) 以 MIT 协议开源。这套工具此前在 Qwen3.5 系列小型 GGUF 模型的极端量化压缩场景中被证明达到 SOTA 水平,如今其完整实现已在 GitHub 上开放(voodoo-dyn-quant),供社区自行制作动态量化模型。
对本地部署大模型、尤其是受限于低显存设备的用户而言,这是一个值得关注的进展——因为开源的动态量化项目本就寥寥无几。
什么是动态量化
要理解 Voodoo Quant 的价值,先要弄清「动态量化」与「静态量化」的区别。
量化的本质是压缩:把模型权重从高精度(如 BF16)降到更低比特,从而缩小体积、降低显存占用。GGUF 等格式支持对模型中的每一个张量(tensor,即一组权重)单独设定量化等级。
静态量化会对某些类型的张量做固定的量化等级选择——即预先规定「哪一类张量用什么精度」。而动态量化则为每个检查点尺寸下的每一个张量做差异化选择,理论上能在相同文件体积下保留更多有效信息。
差异看似细微,但在最激进(即压缩最狠、比特数最低)的量化档位下,逐张量的精细化选择会显著影响模型的输出质量。这正是 Voodoo Quant 主打的优势区间。
GGUF(GPT-Generated Unified Format)是由 llama.cpp 项目主导的模型存储格式,专为本地推理场景设计。它支持将模型中不同层的张量分别存储为不同精度,例如注意力层用 Q4_K,而嵌入层用 Q8_0。常见量化档位从 Q2_K(最激进,约 2 比特/权重)到 Q8_0(接近全精度),文件体积差异可达数倍。正是这种逐张量的精度可配置性,使得「用哪些层保留更高精度」成为一个有优化价值的决策问题——静态量化用人工规则回答这个问题,动态量化则试图用数据驱动的方式回答。
用梯度下降选择量化布局
此前社区对作者所用方法有诸多猜测,而真相「简单而优雅」:用梯度下降(gradient descent)来优化逐张量的量化布局。
据作者描述,VQ 的核心流程如下:
- 并行运行所有量化档位:对每个张量,同时准备好各个候选量化等级的权重(直接由 llama.cpp 底层库 ggml 转换而来),并将这些候选权重全部冻结。
- 只训练一个标量门控(scalar gate):为每个张量的每个量化档位设置一个可训练的标量门控,通过一个 epoch 的训练来决定哪些量化等级最优。
- 退火机制:训练中逐步退火一个 tau 参数,帮助模型从「多档位混合」逐渐收敛到「单一主导档位」的清晰选择。
- Softmax 保证梯度流动:即使某个张量的选择已基本冻结,Softmax 也能确保所有量化档位持续接收梯度。
换句话说,VQ 把「选哪个精度」这件事变成了一个可微分的优化问题,让模型在多样化的校准数据集上自行学习最优的量化配置。
标量门控(scalar gate)结合 Softmax 的设计,本质上是一种可微分的「硬注意力」机制。对于每个张量,假设有 N 个候选量化等级,则对应 N 个可训练标量 $g_1, g_2, \ldots, g_N$,经 Softmax 归一化后得到权重分布,前向传播时将各档位权重按此分布加权求和。训练初期 tau 参数较大,Softmax 输出接近均匀分布(多档位混合),随着退火 tau 不断缩小,Softmax 趋于 one-hot,最终「选定」某一档位。这种退火策略在离散选择优化中常见,与 Gumbel-Softmax 技巧属同一思路,核心目标都是用连续松弛(continuous relaxation)绕过不可微的离散选择,使梯度能够反向传播。
损失函数:KL 散度 + 文件大小目标
Voodoo Quant 的训练目标由两部分构成:
- KL 散度(KLD):衡量混合量化后的 logits 与参考 BF16 检查点之间的差异,KLD 越低奖励越高,意味着量化模型输出越接近原始全精度模型。
- 文件大小目标:奖励模型逼近用户给定的目标文件体积。
这种设计让用户可以直接指定「我要压到多大」,然后由梯度下降在该约束下自动寻找质量最优的逐张量量化方案。相比反复手动跑基准测试的静态分析,这种方式在优化效率上更高——因为它等效于比对了远超人工可行数量的基准迭代。
KL 散度(Kullback-Leibler Divergence)衡量两个概率分布之间的「信息损失」,在知识蒸馏和量化感知训练中被广泛用作质量代理指标。具体到 VQ 的场景:将量化模型的 logits 经 Softmax 转为概率分布 Q,将参考 BF16 模型的 logits 转为分布 P,KLD = Σ P(x) log(P(x)/Q(x))。KLD 为零意味着两个模型在该输入上输出完全一致。相比单纯对比权重数值误差,用 logits 层面的 KLD 作为目标更直接反映「模型对外行为是否一致」,因而是量化质量评估的主流选择之一。文件大小目标则通过对各张量选定档位的比特数求加权和来近似估算,使整体约束可微。
与 Unsloth Dynamic 3.0 的对比
作者也直言不讳地拿自己的方法与业界知名的 Unsloth Dynamic 3.0(UD3) 做了对比,并顺带调侃:此前有人批评他不公开方法论,「但 Unsloth 多年来一直没公开自己的方法」。
从测试结果看,两者各有胜场:
- 中高量化档位:UD3 表现更好。
- 激进(低比特)量化档位:VQ 更优。
作者判断,UD 3.0 是当前主流静态分析技术的进阶版本——即通过统计与静态函数分析权重,辅以反复的 KLD 等指标基准调优。而 Voodoo Quant 据其所知是首个使用反向传播与梯度下降来选择逐张量量化等级的方法。
代价是:用梯度下降优化量化布局需要比静态分析强大得多的算力系统,但换来的是更充分的性能挖掘。
Unsloth 是本地大模型生态中知名度较高的量化与微调工具,其 Dynamic 系列通过静态分析每层权重的数值分布特征(如峰度、异常值密度等),结合对 KLD 基准的反复迭代测试,为不同层分配最优量化档位。这类方法的优势在于计算成本低、可在 CPU 上完成,适合大规模模型;劣势是搜索空间有限,本质上仍是在人工设计的规则框架内做局部调优。VQ 用梯度下降替代人工规则,理论上能探索到静态分析无法覆盖的解空间,但对 GPU 算力的依赖也随之大幅上升——这解释了为何两者在不同量化激进程度下各有胜负:压缩越极端,静态规则越难奏效,基于数据的优化优势越明显。
定位:研究级项目,仍待验证
作者对项目的成熟度保持了克制的诚实态度。他明确指出,这是一个研究级项目,尚未在更大规模的模型上做过研究:
- 在小模型上表现出色,尤其是在最低量化档位——这类档位最能受益于复杂、多样的量化选择。
- 测试采用了研究级的控制标准,但未达到科学层面的有效性证明。
- 关于它究竟能有多好用,仍有大量未知,作者期待更多研究者沿此方向深入。
当前仓库提供了一整套基于该方法训练动态量化模型的工具,默认配置针对 Qwen 架构,但作者称可快速适配到任意模型架构。
为何选择现在开源
作者的理由很朴素:手头同时推进着十几个项目,无暇将 VQ 扩展成配得上它潜力的完整产品,与其让它闲置,不如交给社区。他提到自己做开源已有 20 年,这只是又一次寻常的分享。
对于本地大模型生态而言,一个用梯度下降做逐张量量化的开源方法,为低显存用户和研究者都提供了新的探索空间。无论 VQ 最终能否规模化,它至少为动态量化领域引入了一种此前少见的思路。
相关推荐
微软紧急发布Win11补丁,修复史上最大更新引发的Bug
微软紧急推送Windows 11带外更新,修复其史上最大规模的九月补丁所引发的Bug。该更新曾一次性修复近千个漏洞,却影响了企业、开发者和游戏玩家,尤其是Hyper-V文件夹共享功能。
Perplexity揭秘:支撑AI搜索的嵌入与排序模型服务架构
Perplexity公布AI搜索底层技术研究,揭示支撑嵌入与排序模型的业界领先服务基础设施,解析检索增强生成中检索与排序环节如何决定回答质量与响应速度。
Portable Computer登陆Windows:RTX GPU本地跑A…
Portable Computer登陆Windows:RTX GPU本地跑AI Agent
Portable Computer现已支持搭载NVIDIA RTX GPU的Windows PC,可在本地运行AI harness、agents和模型,无需上传云端即可处理本地文件与连接应用,并在需要时调用前沿云端模型。