QDRAG:查询分解如何提升RAG引用忠实度与泛化能力
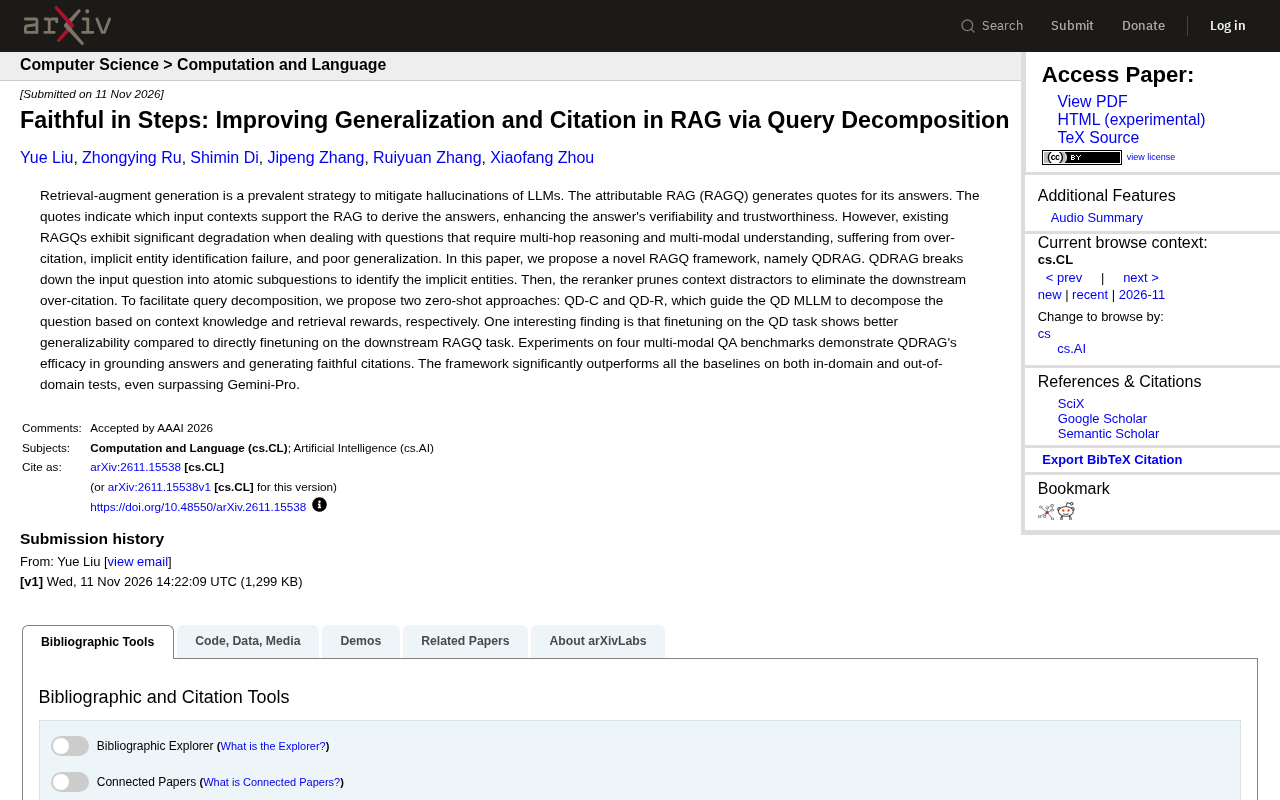
QDRAG通过查询分解与重排序剪枝,提升可归因RAG在多跳多模态问答中的引用精度。
文章围绕可归因检索增强生成(RAGQ)在复杂场景下的性能退化展开,指出传统RAGQ直接将整个问题作为检索与引用单位,导致多跳推理时过度引用、隐式实体识别失败以及域外泛化能力差三大瓶颈。为此,论文提出QDRAG框架,先将问题分解为原子子问题以显式化隐式实体,再通过重排序器剪枝无关上下文以减少冗余引用。分解环节提供QD-C与QD-R两种零样本方法,无需额外训练数据。文章还介绍了一个反直觉发现:在查询分解任务上微调比直接微调下游RAGQ任务具有更强泛化性。实验显示QDRAG在四个多模态QA基准的域内与域外测试中均优于所有基线,包括Gemini-Pro。
检索增强生成(RAG)已成为缓解大语言模型幻觉的常用手段,但传统RAG往往只给出答案,不标注引用来源,降低了答案的可验证性。可归因RAG(RAGQ)通过生成引文来指示哪些输入上下文支持答案,从而提升可信度。然而,现有RAGQ在处理需要多跳推理和多模态理解的问题时表现不佳,面临过度引用、隐式实体识别失败和泛化能力差三大痛点。近期一篇论文提出QDRAG框架,通过查询分解来系统性地解决这些问题。
现有RAGQ的三大瓶颈
论文指出,现有可归因RAG在复杂场景下会出现显著性能退化。具体而言,当问题涉及多跳推理时,模型容易从多个不相关的上下文中过度引用,导致引用冗余且不精确。同时,隐式实体(如代词或省略表达)的识别失败使得检索和引用偏离正确答案。此外,模型在领域外问题上的泛化能力不足,难以适应多样化的多模态问答场景。这些问题的根源在于,RAGQ直接将整个问题作为检索和引用的单位,缺乏对问题内部结构的细粒度建模。
多跳推理(multi-hop reasoning)指回答问题需要串联多个中间事实或推理步骤,而非从单一文档片段直接抽取答案。例如“某导演的哪部电影获得了最佳影片奖”需要先确定导演的作品,再查证奖项归属。传统RAG的检索单位是一整段查询,在多跳场景下容易召回覆盖多个子事实的冗余文档,导致模型在生成引文时把不相关的上下文也一并标注为支持证据,形成过度引用。
隐式实体是指通过代词、省略或指代结构间接出现、本身没有显式名词短语的实体,如“他执导的那部片子”。这类表达需要结合上下文进行指代消解才能转化为可检索的关键词,否则检索会偏离目标实体,引用也随之失效。这也是RAGQ在真实对话式问答中性能下降的重要原因。
QDRAG:先分解,再检索,后引用
QDRAG的核心思想是将输入问题分解为原子子问题,以显式识别隐式实体,并在此基础上进行检索和引用生成。框架包含两个关键步骤:查询分解与重排序剪枝。
查询分解:原子子问题与隐式实体识别
QDRAG首先利用多模态大语言模型(MLLM)将原始问题拆解为若干原子子问题。每个子问题对应一个独立的实体或关系,从而将隐式实体转化为显式查询。例如,对于“他执导的电影获得了什么奖?”这样的问题,分解后会生成“他执导了哪部电影?”和“该电影获得了什么奖?”两个子问题,确保每一步都有明确的检索目标。
为引导MLLM完成分解,论文提出两种零样本方法:QD-C(基于上下文知识)和QD-R(基于检索奖励)。QD-C利用输入上下文中的知识来指导分解,而QD-R则通过检索奖励信号优化分解策略。两种方法均无需额外训练数据,即可在零样本条件下实现有效的查询分解。
重排序(re-ranking) 是信息检索中的两阶段范式:先由召回阶段(如稠密向量检索或BM25)快速取回较大规模的候选文档,再由重排序模型对候选段落与查询的相关性进行精细打分并重新排序。与召回阶段追求高召回率不同,重排序侧重高精度,通常使用交叉编码器等计算量更大的模型逐对评估查询与段落的匹配程度。QDRAG正是利用这一机制对分解后每个子问题的候选上下文做二次筛选,把相关性低的段落剪除,从源头上抑制后续引用生成中的冗余引用。
重排序剪枝:消除过度引用
分解后的子问题会分别检索相关上下文,但检索结果中仍可能包含干扰项。QDRAG引入重排序器对上下文进行剪枝,剔除与子问题无关的段落,从而减少下游引用生成中的过度引用问题。这一步骤确保了最终引用的精确性,使每条引文都能直接支持答案的相应部分。
一个有趣的发现:分解任务微调优于下游任务微调
论文揭示了一个反直觉的结论:在查询分解任务上进行微调,比直接在下游RAGQ任务上微调展现出更好的泛化能力。这意味着,学习“如何拆解问题”这一中间技能,比直接学习“如何生成引用”更能帮助模型适应新领域。作者认为,这是因为查询分解迫使模型理解问题的语义结构,而不是仅仅记忆引用模式,从而获得了更强的迁移性。
零样本(zero-shot) 指模型在未见过目标任务标注数据的情况下直接完成该任务。QDRAG提出的QD-C与QD-R两种分解引导方法均不依赖额外训练数据:QD-C借助输入上下文中已有的知识提示MLLM完成拆解,QD-R则以检索效果作为奖励信号来筛选更优的分解方案。这种设计使框架可以直接套用到新的领域和模态上,无需针对每个数据集重新构造分解标注,从而降低了部署成本,也解释了其在域外测试中保持稳健的原因之一。
实验验证:多模态QA基准上的全面领先
QDRAG在四个多模态问答基准上进行了评估,涵盖域内和域外测试。结果显示,该框架在答案 grounding 和引用忠实度上均显著优于所有基线,甚至超越了Gemini-Pro。实验表明,QDRAG不仅能有效减少过度引用,还能提升隐式实体识别的准确率,并在跨领域场景中保持稳健性能。
对RAG发展的启示
QDRAG的成功提示我们,RAG系统的改进不应仅停留在检索器或生成器的优化上,问题理解层面的结构化分解同样关键。通过将复杂问题拆解为原子子问题,RAGQ可以更精确地定位支持证据,生成更可信的引用。此外,分解任务微调带来的泛化优势,为提升RAG在开放领域的适应性提供了新思路。未来,如何将查询分解与多模态检索更深度地结合,或许是值得探索的方向。
相关推荐

Zed编辑器发布v1.29.2:一次常规版本迭代的观察
Zed编辑器发布v1.29.2补丁版本,由@JosephTLyons完成版本升级,提交经GitHub签名验证。本文梳理该版本的基本信息、补丁版本的含义以及对用户升级的实际建议。

Anthropic IPO遭质疑:Hacker News热议其上市时机
Hacker News出现「Just say no to Anthropic's IPO」帖子,引发对Anthropic上市时机与AI公司资本化的讨论,涉及估值泡沫与使命独立性等议题。

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。