QGIS 全面禁止 AI 代码:一场"良心测试"为何沦为 Level 0 管控
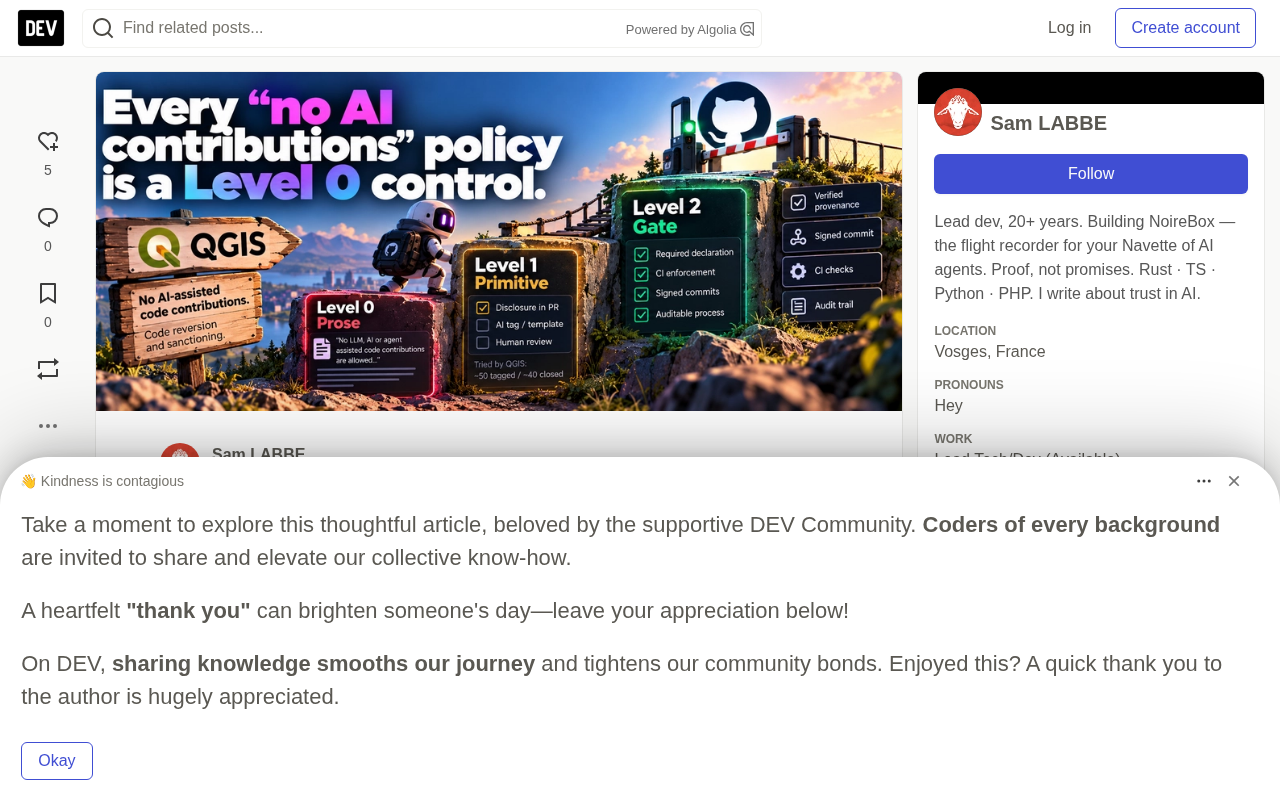
QGIS 全面禁止 AI 贡献却只靠良心执行,本文用三级阶梯框架审计二十个顶级仓库,揭示管控级别与代价
QGIS 社区合并 QEP #387,全面禁止 LLM 与智能体辅助的代码贡献,但被问及如何执行时,核心贡献者的回答是"凭良心判断你是否亲手写了这段代码"。本文据此提出三级阶梯:Level 0 是无人执行的散文式管控,静默失败;Level 1 是 PR 中可见的声明,仅在 CI 检查时有效;Level 2 是宿主关卡拒绝,把流程绑定到签名而非检测。作者审计了 GitHub 上二十个星标最多的仓库,发现十四个完全无 AI 政策,六个有政策但全部止步于关卡之下,零机器执行。Deno、node、PyTorch 在"披露"上趋同,Rust 则公开承认政策条款无法执行,比 QGIS 的隐藏式弱点更诚实。本文主张 Level 2 应依赖来源 trailer、CI 关卡与例外日志,代价是每位贡献者每个 commit 三十秒的"安全带税",而权宜之计应当携带自己的级别标签。
QGIS 社区本周合并了 QEP #387 提案:在 qgis/qgis 仓库中全面禁止 LLM、AI 或智能体辅助的代码贡献。违规者面临"代码回退和贡献者权利制裁"。这项提案取代了此前的人机协同政策,经过投票通过,已在 master 分支生效。Hacker News 上的讨论帖已累计三百余条评论,观点分裂为"限制注意力是合理的"与"这政策会像牛奶一样变质"两派。
真正终结这场辩论的那句话,来自项目自己在提案讨论中的回答。当被问及合规如何执行时,一位核心贡献者说:凭良心,你自己是不是亲手写的这段代码。
这不是执行机制。这是一场附带回退条款的良心测试。用本系列一直在构建的分类法来衡量,QEP #387 是一个教科书式的 Level 0 管控:一段没人执行的英文文字,静默失败,偏移不可见。项目方心知肚明——那句执行说明就是诚实的证词。这场辩论缺失的是"阶梯"——以及登上第二级台阶需要付出的代价。
先给禁令一个公道:它是理性的
在评级之前必须承认:维护者的工作量压力是真实的,他们没有在臆想。提案的理由——"巨大且难以承受的压力"、AI 提交量超出"人类审查者能认真对待的范围"——与各个领域的维护者报告完全吻合。这也不是 QGIS 第一次尝试管控:更早的 AI 辅助 PR 标记流程曾被尝试,然后悄无声息地死掉了,大约五十个 PR 被标记,四十个被关闭。他们试过更轻量的管控,没撑住。Nyall Dawson 提出的"先关上大门"、再有选择地开放,是一位投票者亲口承认的权宜之计:"这个婴儿可能无法存活。"
全面禁令回答的是"这个季度怎么活下来"。本文要问的是下一个问题:这项政策是由什么材料构成的,以及这种材料要付出什么代价。
三级阶梯:逐个应用
每个管控措施都位于三级台阶中的某一级,按"由什么来执行"来定级。
Level 0——散文式管控。 "禁止 AI 贡献"写在没人执行的文档里,静默失败:偏移不可见,因为触发条件——这段代码是否是 AI 辅助的?——除了良心之外,没有任何东西能评估。QGIS 讨论帖中的定义漏洞不是起草事故,而是触发条件不可评估的证明。自动补全算吗?翻译算吗?一个重排你 import 顺序的排序模型算吗?一个范围不可判定的规则,无法被任何低于人类诚实记忆的东西执行——而项目方已经说了,这就是他们的机制。
Level 1——上下文中的原语。 贡献者做出声明,在 PR 中可见:模板字段、trailer 行、能存活到 commit 中的复选框。它可见地失败——但前提是有人看。QGIS 试过这一级:标记流程。它因为一个无聊的原因失败了——整个历史中大约只有五十个标记,这不是执行,这是装饰。Level 1 在 CI 检查它时才有效,而 QGIS 的 CI 没有。
Level 2——宿主拒绝。 管控存在于一个不信任任何人记忆的关卡中。这是辩论一直跳过的一级,因为人们混淆了两个不同的问题:检测 AI 代码(对抗性的,永远赢不了——简单代码就是无法检测,将来也一样)与将流程绑定到签名(无聊的,能赢的,这正是"收据"存在的意义)。
本系列遵循的收据 schema 将这一区分落实到代码中。每个裁决必须携带 judged_by——必填,无默认值;schema 会直接抛错,而不是封装一个未标注的裁决。对于 LLM 评判的检查,spec_hash 是强制的:定义判断的 prompt 会被哈希,因此评分标准和它的改写会产生不同的 id。这两个字段都不声称能检测谎言。它们让一个未标注的声明无法被封存——谎言如果来了,必须是带着签名的。
可证伪性(falsifiability) 是本文评级框架的隐含判据。一个管控措施被称为"可证伪",是指政策自身公开声明了执行到何种程度、在哪里失效——读者可以据此核对政策是否被兑现。Level 0 的散文式管控之所以最危险,不是因为它弱,而是因为它把弱点藏起来:文字声称禁止,却不写由谁、在哪一步执行,于是"政策存在"与"政策生效"之间的落差永远不会被任何人观察到。Rust 的 AI 政策在引言里写下"我们意识到本政策中许多条款无法执行",等于主动把自己的失效边界交给公众检验;读者若发现条款确实没被执行,那不算丑闻,因为政策早就承认了。QGIS 的 QEP #387 则把同样无法执行的良心测试包装成带回退与制裁的强硬措辞,使政策表面看起来处在更高的执行台阶上。差别不在严格程度,而在一个可被证伪、一个只能被信任。
实测部分:二十个仓库,六份政策,零执行
没有数据的分类学只是布道。于是我审计了 GitHub 上二十个星标最多的仓库——那些政策塑造了成千上万贡献者"正常认知"的项目。方法公开:拉取每个仓库的贡献文档和 AI 政策文件,完整阅读找到的每份政策,按阶梯评级,并检查仓库的 GitHub workflow 名称中是否有任何引用 AI、LLM 或披露的自动化。
二十个仓库中有十四个在贡献文档中完全没有 AI 政策——包括几个接收到上百个 AI 生成 PR 的仓库。六个有政策。我完整阅读了全部六份,每一份按阶梯评级,都止步于关卡之下:
| 仓库 | 政策原文 | 级别 | 机器执行 |
|---|---|---|---|
| denoland/deno | AI 辅助贡献:"你必须披露"于 PR 描述中;"若有未披露 AI 使用的嫌疑,PR 将被拒绝" | 1 | 无 |
| pytorch/pytorch | AI 内容"必须清晰披露并隔离"在标注的 PR 模板区域中,附带人类评论 | 1 | 无 |
| nodejs/node | 贡献者"应当披露"所用工具"以及贡献者为亲自验证生成输出做了什么";DCO 仍然适用 | 1 | 无 |
| home-assistant/core | 未经审查的 AI 内容"将不被接受";自主智能体被禁止,基于"相信"关闭 PR | 1 | 无 |
| flutter/flutter | 行为政策——"关注行为而非工具",违规通过行为渠道处理 | 0–1 | 无 |
| rust-lang/rust | 有条件允许——且自我标注:"我们意识到本政策中许多条款无法执行" | 0–1,已标注 | 无 |
| qgis/QGIS | 禁令:回退 + 制裁,触发条件 = 良心 | 0 | 无 |
"机器执行"这一列是缺失性发现:我检查了每个仓库的 workflow 名称中是否有任何引用 AI、披露或贡献标签的内容——什么都没有。更深层的 CI 内容审计可能藏着一个例外;名称层面的扫描没有发现任何东西。
按趣味性递增排列的三个发现。Deno、node 和 PyTorch 在"披露"上趋同——生态系统的共识级别是"大声说出来",而 PyTorch 走得最远:AI 内容必须隔离在标注的 PR 模板区域中,附带人类评论。这是所有人发布的最接近结构化的东西——模板让这个区域默认存在;一个空的区域至少是可见的。Home Assistant 基于"相信"关闭 PR——"我们相信它们是自主创建的"——这是样本中最强的触发条件,由最弱的工具执行。而 Rust 在我之前就写好了本文的论点:"我们意识到本政策中许多条款无法执行。我们的目标不是抓住每一次违规……我们的目标是消除合理的推诿:迫使人们在遵守政策和故意违反之间做出选择。"
Rust 是阶梯公平性的证明。它的政策是散文——按触发条件划分是 Level 0——而它大声说出来,写在自己的引言里。QGIS 从同一级台阶上以回退和制裁相威胁,却没有这个标签。同样的材料,相反的诚实:一个在应该写执行机制的地方写了"这些条款无法执行";另一个把良心测试包装在回退威胁里。它们之间的区别不是严格程度,而是政策自身的级别是否可证伪。
为什么这个审计只扫描 workflow 名称而不深入 CI 内容,值得说明。GitHub Actions 的 workflow 文件可以包含任意复杂的条件逻辑,且可以在运行时拉取外部脚本或调用 reusable workflow,穷尽审计需要逐仓库读取全部 YAML 与其引用的脚本,这在二十个活跃仓库上不可行。名称扫描是一种上界估计:如果连 workflow 的命名都没有提到 AI、披露或贡献标签,那么至少那些为专门目的创建的检查不存在——真实项目通常会为专门检查起一个能自解释的名字。这种方法会漏掉藏在通用命名(如 ci.yml、lint.yml)里的检查,从而低估执行程度。作者公开这一粗糙度,是为了让结论的边界清晰:"零执行"的含义是"在名称层面没有证据",而非"经穷尽审计确认没有任何 CI 检查"。任何更强的主张都需要逐个仓库深读,那是另一项研究的规模。
Level 2 的 AI 贡献政策长什么样
不是检测。是流程,是签名:
- 每个 commit 上的来源 trailer,形状与
Signed-off-by相同:Authored-by: human或Authored-by: human, assisted-by: <tool>。不声称 LLM 检测——一个声明,由 CI 要求,缺失时在关卡处拒绝。Hacker News 上被赞许引用的 Linux 内核方案——"允许 LLM 使用,但你对它产生的代码完全负责"——就是这一级:责任绑定到签名,而非检测启发式。 - 带日志理由的回退。 QGIS 已经威胁的"代码回退和制裁",在回退携带收据的那天变得可执行:哪个 commit、哪条规则、哪位审查者。活在私密对话中的制裁不是管控。
- 公开发布例外日志。 Dawson 的"关门、逐案开放"(自动补全替换、翻译)形状是对的——但一个没有公开日志的逐案通道,会悄无声息地变成一条走廊。例外台账就是政策的审计轨迹。
- 可选,且仅在维护者需要时:文档蜜罐。 在贡献文档中植入一个诱饵指令,看谁 commit 了它——这个故意失败的探针已被证明对评测智能体有用。便宜、不完美、诚实承认自己是绊线而非法官。
- 把级别写进政策。 Rust 的 LLM 政策在自己的概述中就做了——"我们意识到本政策中许多条款无法执行"——这句话就是没人能指责 Rust 假装的原因。一个被标注的弱点胜过一个不可见的弱点,宪法如此,代码亦然。
这些都不检测 AI 代码。检测是对手的游戏,对手正在赢。收据制度声称的东西更窄也更真实:当贡献违反规则时,违反行为是可证明的、可归因的、有记录的——而不是靠感觉去发现(如果能发现的话)。
来源 trailer(provenance trailer) 借用了 Git 社区既有的 DCO(Developer Certificate of Origin)机制。DCO 要求每个 commit 携带 Signed-off-by: 行,声明贡献者有权提交这段代码并接受开源许可;它是行的语义而非技术隔离——CI 只能检查这一行在不在,不能验证其内容是否真实。本文提出的 Authored-by: human, assisted-by: <tool> 遵循完全相同的形状:它是贡献者对作者身份的一份声明,而非对代码来源的检测。这一点在工程上至关重要,因为 trailer 一旦进入 commit,就随 git 历史被永久封存,改历史会改变 commit hash,从而破坏引用链。于是"未标注的声明"在技术上变得困难:想隐瞒 AI 参与,贡献者必须主动删除或伪造 trailer 行,而这本身就是一个可被追溯的、有签名痕迹的动作。CI 关卡在这一层只需做一件事——缺 trailer 就拒绝,把对抗留给人类审查者去用常识判断。
代价,直说
安全带税。一个来源 trailer 是每个 commit 三十秒,永远如此,适用于每一位贡献者——包括那百分之九十九永远不会钻空子的人。Level 0 零成本,也抓不到任何东西;Level 2 让所有人付出代价,抓的是流程违规,不是作者身份。没有哪一级台阶是免费的。一位说"我的贡献者不会接受摩擦"的维护者,已经选择了 Level 0,而在本周的数据之后——压力是真实的——这是一个站得住脚的选择。它应该是一个被标注的选择。
安全带税这个比喻直指一类公共治理困境:少数违规者造成的外部性,由全体参与者共同承担防御成本。交通领域的研究早已发现,强制系安全带并没有显著改变驾驶者的风险偏好,反而让司机开得更快——防御措施的收益被行为调整部分抵消。本文借用这个框架,是想说明来源 trailer 的成本结构:它对那百分之九十九永远不使用 AI 的贡献者完全无用,纯粹是摩擦;对那一小撮想隐瞒的人,它不构成技术障碍,只增加一步主动伪造的成本。因此 Level 2 的收益不是"抓住更多人",而是把"违规"从一个模糊的、可辩解的灰色地带,转化成一个有明确签名的动作。反对者可以合理地说这种转化不值得每位贡献者每个 commit 三十秒——这正是维护者的正当选择权。争点不在要不要安全带,而在这个选择有没有被政策明确标注出来。
两个诚实的局限
调查是有公开粗糙度的快照。 二十个仓库按知名度选择,贡献文档和政策文件作为政策表面,workflow 名称作为执行表面——更深层的 CI 内容审计,或存在于这些文件之外的政策,会被遗漏。六份政策中有五份来自完整阅读(Rust 的从 Rust Forge 获取),一份(QGIS)来自其合并提案和核心团队的评论。政策作者是否接受我的级别划分,是他们的争议权利——级别是从他们自己的文本中引用的,所以争议可以是精确的。
QGIS 在这个季度选择生存而非可验证性,并没有错。 五十个标记和四十个关闭的 PR 是一次有真实数字的真实尝试;"难以承受的压力"不是表演。本文主张的是:权宜之计应该携带自己的标签——Level 0、基于诚实、修订待续——就像本系列标注自己承认的每一个弱点,就像 Rust 标注自己的条款。一个把管控级别写进政策的项目,并没有解决执行问题。它让执行的缺失变得可证伪。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。