嵌入式工程师如何转型边缘AI?一线从业者这样说

嵌入式工程师转型边缘AI:补齐部署工具链与系统级思维是关键。
文章回应一位嵌入式工程师转向边缘AI的困惑,指出该领域日常工作以模型压缩、量化、硬件适配和部署调试为主,而非算法训练。嵌入式背景者的C/C++、RTOS和内存管理能力是差异化优势,但需补齐ONNX Runtime、TensorRT、TFLite Micro等推理框架与量化工具链,并建立硬件感知的模型设计意识。求职层面建议构建从训练到量化再到目标硬件部署的闭环项目,量化精度、延迟和内存指标,简历突出交叉能力,并借助开源贡献提升面试优先级。此外,系统级思维、硬件协同设计和性能建模等隐性差距常被忽视。
引言:一个嵌入式工程师的转型困惑
一位在印度从事汽车嵌入式软件开发的工程师,拥有约一年经验,技术栈覆盖 C/C++、Python、嵌入式系统、ARM、RTOS 和 Linux 基础。他正在学习机器学习和深度学习基础,并计划围绕 ASR/TTS、模型部署、ONNX、量化以及边缘硬件推理构建实战项目。他向 Edge AI / On-Device AI 领域的从业者提出了几个问题:日常实际工作内容是什么?哪些技能和工具最重要?嵌入式背景如何瞄准相关岗位并获得面试?强项目和部署经验是否足够,还是存在其他差距?
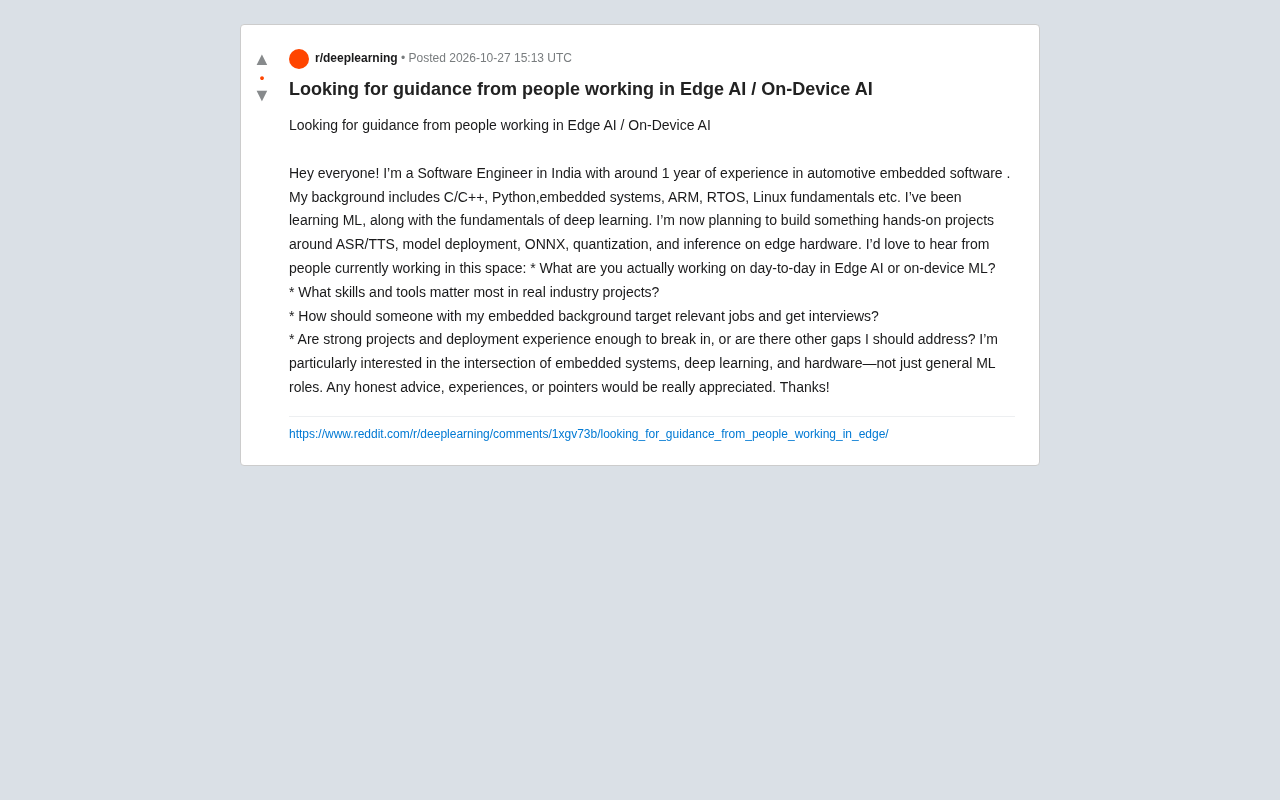
这些问题触及了边缘 AI 人才转型的核心痛点。本文结合社区讨论和行业实践,尝试给出有深度的回答。
边缘AI从业者日常在做什么?
边缘 AI 的工作并非单纯训练模型,而是围绕“让模型在资源受限设备上跑起来且跑得好”展开。典型任务包括:模型压缩与量化(将 FP32 模型转为 INT8 甚至更低精度)、算子融合与图优化、针对特定硬件(如 ARM CPU、NPU、DSP)的推理引擎适配、内存与功耗预算管理、端到端流水线搭建(从传感器输入到推理输出)。
据多位从业者分享,日常大量时间花在调试部署问题而非算法创新上。例如,一个在 ARM Cortex-M 上部署关键词识别的工程师提到,量化后精度下降几个百分点可能需要数周迭代来补偿;另一个做智能摄像头的工程师则表示,热设计约束常常比模型精度更早成为瓶颈。
哪些技能和工具最关键?
嵌入式功底是差异化优势
对于有嵌入式背景的转型者,C/C++ 能力、对内存层次和中断处理的理解、RTOS 调度经验都是稀缺资产。许多纯 ML 背景的候选人不具备这些,导致在边缘侧优化时无从下手。
部署工具链比训练框架更重要
在真实项目中,ONNX Runtime、TensorRT、TFLite Micro、OpenVINO 等推理框架的使用频率远高于 PyTorch 训练代码。熟悉量化工具(如 ONNX 量化工具包、TFLite 转换器)、性能分析工具(如 ARM Streamline、perf)是加分项。
ONNX(Open Neural Network Exchange)是一种开放的模型表示格式,旨在让不同训练框架(如 PyTorch、TensorFlow)导出的模型能被多种推理引擎加载。ONNX Runtime 是微软主导的跨平台推理引擎,支持 CPU、GPU 及多种加速器后端,在边缘设备上常用于替代训练框架自带的推理路径。TensorRT 是 NVIDIA 针对自家 GPU 的推理优化库,通过层融合、精度校准和内核自动调优显著降低延迟,但仅限 NVIDIA 硬件。TFLite Micro 是 TensorFlow Lite 的微控制器版本,专为 KB 级内存的 MCU 设计,不含动态内存分配。OpenVINO 则是 Intel 面向其 CPU、集成 GPU 和 VPU 的推理工具套件。理解这些框架的适用边界(硬件绑定、算子覆盖、量化支持程度)是选型的前提。
硬件感知的模型设计
了解目标硬件的算力特性(如 MAC 阵列规模、是否支持 Winograd 卷积、内存带宽限制)能指导模型结构选择。有从业者指出,为 NPU 编写高效算子或做算子替换,往往比调参更能提升端到端性能。
Winograd 卷积是一种快速卷积算法,通过变换将标准卷积的乘法次数减少约 2.25 倍(3×3 卷积场景),许多 NPU 和 DSP 对其有专门硬件支持;若模型结构或算子实现无法利用该加速路径,实际性能会远低于理论峰值。MAC 阵列(乘加阵列)是 NPU/TPU 的核心计算单元,其规模(如 64×64)决定了单周期的乘加吞吐上限,模型每层的通道数和空间尺寸需与之匹配才能打满利用率。内存带宽常是边缘推理的真正瓶颈:即便算力充足,权重和激活值的搬运耗时也可能主导端到端延迟,这解释了为何减少内存访问的算子融合往往比单纯减少 FLOPs 更有效。
如何瞄准岗位并拿到面试?
项目要体现“部署闭环”
单纯在笔记本上跑通模型推理远远不够。建议构建从模型训练→量化→目标硬件部署→性能剖析的完整项目,并记录量化前后的精度、延迟、内存占用对比。例如,在树莓派或 ESP32 上部署一个语音唤醒词识别模型,并给出端到端延迟和功耗数据。
训练后量化(Post-Training Quantization, PTQ)是最常用的低门槛方案:用少量校准数据统计激活值分布,将 FP32 权重和激活映射到 INT8,无需重新训练,但精度损失可能较大。量化感知训练(Quantization-Aware Training, QAT)在训练前向图中插入伪量化节点,让模型在训练阶段就适应量化误差,通常能挽回大部分精度损失,代价是需要训练资源和标注数据。选择 PTQ 还是 QAT,取决于精度容忍度、数据可得性和迭代周期,这也是部署闭环项目中值得明确记录的决策点。
简历突出交叉能力
将嵌入式经历与 ML 项目结合叙述,例如“在 RTOS 环境下实现传感器数据采集与预处理,并集成量化后的推理引擎,将单次推理延迟控制在可接受范围”。避免堆砌“熟悉深度学习”这类空泛描述。
社区与开源贡献
参与边缘 AI 相关的开源项目(如 TFLite Micro、ONNX Runtime 的硬件后端)能有效证明能力。有从业者提到,招聘时看到候选人对推理框架提交过 PR,会显著提升面试优先级。
强项目和部署经验够吗?还有哪些差距?
项目经验是敲门砖,但并非全部。据讨论,以下差距常被忽视:
- 系统级思维:边缘 AI 涉及传感器、通信、功耗管理、安全等多子系统协同,仅关注模型本身不够。
- 硬件协同设计意识:理解硬件加速器的工作原理,能与硬件团队有效沟通。
- 性能建模能力:能在设计早期估算模型在目标硬件上的延迟和内存需求,而非等到部署后才发现不可行。
- 领域知识:汽车、医疗、工业等场景有各自的实时性、功能安全要求,嵌入式背景者应主动补充目标行业的标准与约束。
性能建模指在模型尚未部署前,基于目标硬件的算力、内存带宽和算子支持情况,用解析模型或 roofline 分析估算延迟与内存占用。常用手段包括统计模型的 MAC 数和参数量、按层估算访存量、对照硬件规格推算理论上限,再与实测值对比定位瓶颈。掌握这一能力可以在架构选型阶段就排除不可行的方案,避免“训练完才发现跑不动”的返工,也是资深边缘 AI 工程师与初级部署者的重要分水岭。
结语
边缘 AI 是一个交叉领域,嵌入式工程师的底层功底是天然优势,但需要主动补齐部署工具链、硬件感知设计和系统级思维。以部署闭环项目为切入点,结合开源贡献和清晰的交叉能力叙事,是切入该领域的可行路径。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。