前YouTube工程师45分钟用AI重建YouTube:不写一行代码的全流程拆解

前YouTube工程师用AI Agent工具45分钟重建YouTube雏形,展示当下AI辅助开发的能力边界与最佳实践。
曾参与打造YouTube的资深工程师Mike,用不到45分钟、零手写代码,借助Cursor、Codex等AI Agent工具重建了一个可运行的YouTube雏形"CatTube"。工具栈涵盖Next.js、Supabase+Postgres、Cloudflare CDN、Vercel部署,核心原则是"能用托管服务就不自建"。界面通过GPT image生成截图再喂给Agent实现,搜索与推荐借助多模态Embedding和pgvector扩展在Postgres内完成,无需引入专用向量数据库。Agent还承担了Git配置、部署报错调试等运维事务,"复制报错→交给Agent→审PR→合并"成为日常工作流。案例的核心启示是:在托管服务兜底、产品清晰拆解、人担任技术负责人把关的前提下,个人开发者可以实现数量级效率提升;而哪些自建、哪些外包的复杂度取舍判断,仍是人不可被替代的价值所在。
三年工程 vs. 45分钟AI复刻
曾在Alphabet任职、参与打造YouTube.com的资深工程师Mike,在一段演示中做了一件挑衅性的事:用不到45分钟、不手写一行代码,借助AI编程工具重新搭建了一个YouTube的可运行雏形。他直言当年在Alphabet作为Staff软件工程师打造现代版YouTube花了三年多,而如今借助Agent工具,普通人也能在极短时间内还原核心体验。
这个案例的价值不在于"复刻YouTube"本身——毕竟视频转码、大规模推荐系统这些真正的硬骨头被巧妙绕开了——而在于它清晰展示了当下AI辅助开发的能力边界与协作范式。Mike把自己定位为"产品经理+技术负责人",负责下达明确指令,具体实现交给Agent完成。这恰恰是今天AI编程最现实的使用姿势。
他也坦率地划定了边界:让Agent端到端"造产品、填数据、部署、拉用户、投广告"的完全自动化,仍然还有一两年的距离。目前能做的,是把复杂产品拆成小块,逐一交给Agent实现。
工具栈选型:从Cursor到Postgres的务实组合
整个演示用到的工具栈值得单独梳理,因为它反映了一位资深工程师在当下会做的技术选择:
- Agent编程工具:Cursor 与 OpenAI Codex 交替使用,Cursor偏IDE形态、Codex用于生成界面
- 前端框架:Next.js(TypeScript + React),而非当年YouTube用的Polymer和Web Components——Mike直言这些技术"没有经受住时间考验"
- 数据库:Postgres(通过Supabase托管),ORM选用Drizzle
- 图片与视频托管:Cloudflare的CDN与视频播放器
- 内容生成:Fal.ai聚合多模型,用GPT image 2.5生成缩略图、用H3 Max Turbo生成短视频
- 认证:Better Auth
- 部署:Vercel(Next.js母公司出品)
这套组合的核心思路是"能用托管服务就不自建"。视频转码、流媒体分发这类YouTube后端的"巨型机器",被直接外包给Cloudflare,从而把项目复杂度压到一个人可控的范围。
从截图到代码:界面还原的三种策略
Mike重建首页和观看页的方法很有代表性。他先用GPT image 2.5生成一张"CatTube"(猫咪版YouTube)的界面图,再把图片交给Agent实现。关于"图像转代码",他给出了三条路径并做了对比:
- Figma:真实企业中设计师与工程师协作的主流工具
- Penpot(pen.dev):可连接自有LLM的Figma本地替代
- 直接把图片喂给Agent:绕过所有外部服务,在YouTube这种知名产品上效果极佳
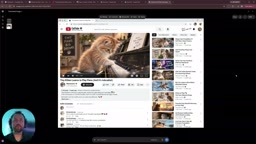
他最终选择第三种——因为所有大模型都"知道YouTube长什么样",甚至一句文字描述就足够。实测中,Codex一分钟就产出了结构合理、配色接近真实YouTube的首页;Cursor实现代码后不仅完成桌面布局,还自动适配了移动端。观看页因为可复用大量首页组件,实现速度明显更快,侧边栏默认隐藏、视频播放器等元素都一次到位。
让静态网站"活起来":数据库与内容生成流水线
光有静态页面还不够。Mike接下来把静态数据迁移进Postgres,并让Agent自动生成了一个可编辑的后台管理界面。他特别演示了Agent的"计划模式(Plan Mode)":面对涉及Schema设计、数据迁移、后台构建等大量环节的复杂任务,先让Agent输出完整方案供人审阅,再执行。
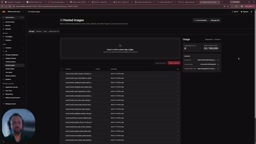
真正有意思的是内容生成流水线。他用三步造出以假乱真的猫咪视频:LLM生成视频标题、创意和元数据 → 图像模型据此生成缩略图 → 再用缩略图驱动H3 Max视频模型生成5至15秒的短视频,全部上传Cloudflare。之所以先做缩略图,是因为"缩略图本来就需要,还能对成片有更多控制"。视频生成虽仍昂贵,但通过H3的Turbo版本可以做到又快又便宜。
文中提到的Drizzle ORM是近年在TypeScript生态中快速崛起的数据库查询工具。ORM(对象关系映射)的作用是让开发者用编程语言的对象和类型来描述数据库结构,而无需手写SQL。Drizzle的特点是"类型优先"——Schema定义即TypeScript类型,查询结果自动推断类型,与Next.js这类TypeScript项目天然契合。相比老牌的Prisma,Drizzle生成的SQL更贴近原生、运行时开销更小,因此在注重性能的全栈项目中颇受青睐。Supabase则是在Postgres之上构建的开源后端即服务(BaaS)平台,除托管数据库外还提供认证、实时订阅、文件存储等功能,是当下个人开发者和初创团队快速启动项目的热门选择。两者结合,使得本案例的数据层几乎不需要自己运维任何服务器。
搜索与推荐:用Embedding"作弊"实现
面对YouTube最核心也最难的两个功能——搜索和相关视频推荐,Mike直言"我们靠作弊来实现",因为真实服务背后是庞大团队在支撑。他的方案基于多模态Embedding(向量嵌入):
把每个视频用文本和缩略图两部分表示,用多模态模型将文本和图像映射到同一向量空间。这样"cat"这个词就能和狮子、老虎的图片在空间中彼此靠近。通过**余弦相似度(cosine similarity)**计算向量夹角,就能判断内容是否相似并排序。
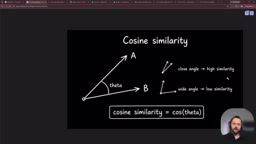
关键的一点是存储。Mike提到,过去因为传统数据库难以高效做相似度查询,大家不得不引入Pinecone、Weaviate等专用向量数据库。而如今Postgres凭借pgvector扩展已经补齐了这块能力,于是又回到了"一个Postgres搞定一切"的简洁架构。实测中,打开一个超级英雄猫视频,最相关推荐正是另一个超级英雄视频;搜索"noir"返回一批黑白风格画面,效果相当可用。
多模态Embedding的核心思想是将不同类型的数据(文字、图像、音频)统一映射到同一个高维数字向量空间中,使得语义相近的内容在空间中的距离也相近。这类模型的代表是OpenAI的CLIP(Contrastive Language-Image Pre-training):它在训练时同时"看"图片和对应的文字描述,通过对比学习让"一只猫的照片"和"cat"这个词的向量尽可能靠近,而与"汽车"的向量保持距离。余弦相似度则是衡量两个向量方向夹角的数学指标,取值在-1到1之间,1表示完全同向(即内容极为相似),0表示正交(无关),-1表示相反。相比欧氏距离,余弦相似度对向量的长度不敏感,更适合文本和图像特征的比较,因此成为向量检索任务的标配度量方式。pgvector是Postgres的开源扩展,为数据库原生添加了向量数据类型和ANN(近似最近邻)索引,让开发者无需引入独立的向量数据库即可完成相似度查询,显著降低了架构复杂度。
认证、暗色模式与上线:Agent不只是写代码
收尾阶段,Mike用Better Auth加上了简单的登录认证,管理后台从此需要身份验证才能访问。随后一句提示词就让Agent实现了完整的暗色模式——他感慨当年为了让YouTube在暗色模式下好看花了好几个月,如今"五分钟搞定"。

部署环节最能说明"Agent不只是用来写代码"这一点。由于本地项目从未初始化Git,而Mike自认"不是很擅长Git",他干脆让Agent处理向GitHub推送代码、连接多账号环境等一堆繁琐配置——原本可能要读几小时文档的活儿,Agent五到七分钟完成。
通过Vercel部署时还遇到了真实的坑:因使用onnxruntime生成clip embedding,Vercel运行环境找不到该模块导致100%报错。Mike直接把错误日志复制给Agent,附上"这是Vercel部署"的上下文,Agent便提交了一个PR修复;审阅、合并后重新部署即告成功。这套"复制报错→交给Agent→审PR→合并"的调试闭环,正是当下AI编程最日常的工作流。
文中遇到的onnxruntime是微软开源的机器学习模型推理引擎,支持运行以ONNX(Open Neural Network Exchange)格式导出的模型。CLIP等Embedding模型通常会以ONNX格式分发,以便在不依赖Python/PyTorch完整环境的情况下运行推理。然而Vercel的Serverless Functions运行环境对原生二进制依赖有严格限制,onnxruntime包含平台相关的C++动态库,在Vercel的沙盒环境中无法正常加载,因此触发了部署报错。这类"本地跑通、云端报错"的问题在Serverless部署中相当常见,根本原因是Serverless平台为了冷启动速度和安全性,对文件系统、原生模块做了诸多约束。Agent能够通过错误日志中的关键词(如模块未找到、平台架构不匹配)快速定位问题并提交修复,体现了其在处理此类有明确错误信息的调试任务上的实用价值。
这个案例真正告诉我们什么
45分钟的"CatTube"当然不是YouTube——没有真实视频上传、没有大规模推荐、没有真实用户。但它精准展示了AI编程的现实能力:在有成熟托管服务兜底、有清晰产品拆解、有人扮演技术负责人把关的前提下,个人开发者能以数量级更高的效率完成从零到上线的全流程。
更值得琢磨的是Mike对复杂度的处理智慧:哪些自建(前端、数据模型、搜索逻辑),哪些外包(视频转码、CDN、部署)。这种取舍判断,恰恰是Agent目前还替代不了、也是资深工程师价值所在的地方。工具在变,但"想清楚要什么"依然需要人来完成。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。