强化学习优化神经算子PDE求解:在有限预算下学会何时精修

强化学习指导神经算子PDE求解中有限修正预算的最优时空分配
本文提出了一套用于神经算子自回归PDE求解的自适应修正框架,核心问题是:在固定的局部修正预算下,如何决定在演化轨迹的何处、何时施加纠偏以最小化长程误差?系统由全局FNO推进器、局部残差算子、集合感知选择器和宏观调度策略四层构成。关键方法论贡献是RV-PI(Rollout验证的策略改进):通过让已学习的求解器实际跑完后续轨迹来评估修正的真实下游价值,并以held-out验证轨迹误差改善作为接受门槛,以保守更新换取稳定性。在浅水方程和Brusselator两个基准上,RV-PI均稳定优于即时策略改进和随机宏观策略,验证了"局部修正的价值取决于其对整条自回归轨迹的下游效应"这一核心洞察,为算力受限的科学计算场景提供了新思路。
神经算子求解PDE的瓶颈:误差不均与有限修正
神经算子(Neural Operator)近年成为求解时变偏微分方程(PDE)的高效替代方案,它能以远快于传统数值方法的速度推进整个物理场的演化。但当这类模型以自回归方式部署——即用前一步的预测作为下一步输入时——会累积一个棘手的问题:预测误差在空间和时间上分布极不均匀,而实际可用于局部修正的次数却十分有限。
换句话说,你不能对每一个时刻、每一处区域都做精细修正,只能在一条演化轨迹上committed有限数量的局部纠偏。这就构成了一个典型的资源分配难题:有限的修正预算,应该花在哪里、花在何时?
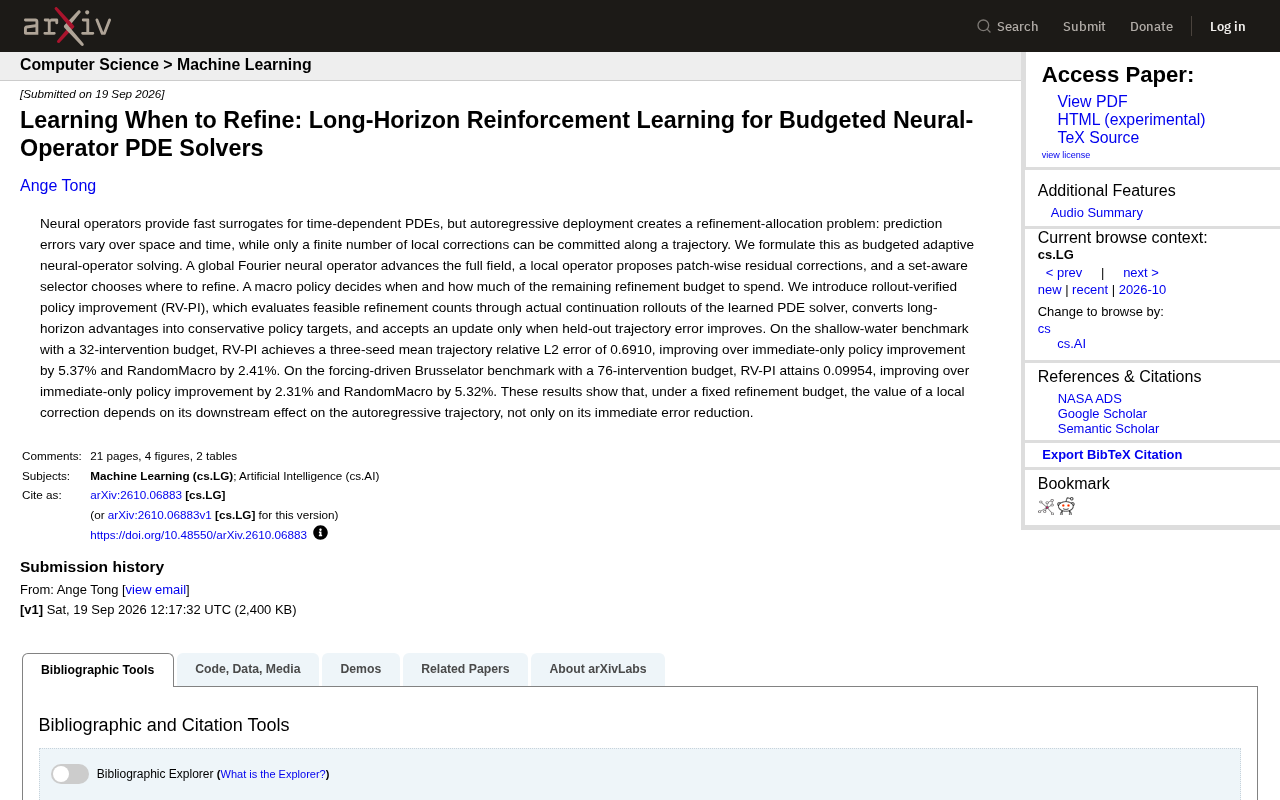
这篇arXiv新论文将该问题形式化为"带预算的自适应神经算子求解"(budgeted adaptive neural-operator solving),并给出了一套基于长程强化学习的解决框架。
四层架构:从全局推进到局部精修
论文提出的系统由四个协同模块组成,层次分明:
全局算子负责整体推进
系统底层是一个全局傅里叶神经算子(Fourier Neural Operator, FNO),负责推进整个物理场的演化。这是粗粒度的、快速的主干预测。
傅里叶神经算子(FNO)由Zongyi Li等人于2020年提出,是神经算子家族中最具代表性的方法之一。其核心思想是在频域而非空间域中学习算子映射:通过快速傅里叶变换(FFT)将输入函数转换到频率空间,在低频分量上施加可学习的线性变换,再通过逆FFT转回空间域,叠加跳跃连接完成一层"傅里叶层"的计算。这种设计的优势在于,频域中的卷积等价于空间域中的全局卷积,使FNO天然具备捕获长程依赖的能力,同时参数量远少于直接在空间域操作的等效模型。更重要的是,FNO具有分辨率不变性——训练时使用低分辨率网格,推理时可直接迁移到更精细的网格,这对计算流体力学等实际场景极具价值。在自回归部署中,FNO充当"骨干预测器",以极低的单步计算成本推进整个场的演化,但也因此积累截断误差。
局部算子提出残差修正
在全局预测基础上,一个局部算子(local operator)针对特定patch(局部区块)提出残差修正建议。这相当于在误差较大的区域打"补丁"。
选择器决定"在哪里精修"
一个具备集合感知能力的选择器(set-aware selector)负责判断应该在哪些位置施加修正。它要在众多候选区块中挑出最值得投入预算的那些。
宏观策略决定"何时、花多少"
最上层是一个宏观策略(macro policy),决定在轨迹的某个节点是否动用剩余预算、动用多少。这一层是整个系统的"调度大脑",直接关系到预算的全局效率。
这种分工把"推进—提议—选位—调度"解耦,使得每一层都能专注于自己的子问题。
核心方法:Rollout验证的策略改进(RV-PI)
论文最关键的贡献是提出了rollout-verified policy improvement(RV-PI,Rollout验证的策略改进)。它的核心洞察在于:一次局部修正的真正价值,不在于它当下减少了多少误差,而在于它对后续整条自回归轨迹的下游影响。
RV-PI的工作流程可以拆解为三步:
- 通过真实延续rollout评估可行的修正次数:不是用近似估计,而是让已学习的PDE求解器实际跑完后续轨迹,看不同修正方案的真实效果。
- 将长程优势转化为保守的策略目标:把这些长时间跨度上累积的收益(long-horizon advantages)折算成相对保守的更新目标,避免策略激进震荡。
- 只有在留出轨迹误差改善时才接受更新:采用held-out验证轨迹作为门槛,误差没有改善就拒绝这次更新。
这种"先验证、后更新"的保守机制,正是为了对抗自回归系统中误差累积带来的不稳定性。相比只看眼前误差的"即时策略改进"(immediate-only policy improvement),RV-PI把视野拉长到了整条轨迹。
RV-PI所解决的问题在强化学习中被称为**信用分配(credit assignment)**问题:当一个动作的奖励信号在数十步之后才显现时,如何将最终的成败"归因"到早期的决策上。在稀疏或延迟奖励环境中,经典的策略梯度方法(如REINFORCE)通常用折扣累积回报来估计每个动作的优势函数,但这种估计在长轨迹上方差极大,容易导致策略更新不稳定。RV-PI的不同之处在于放弃了价值网络的估计,而是直接用已学习的PDE求解器"过一遍"真实的后续轨迹来获得真实优势信号——代价是额外的前向传播计算,收益是低方差的梯度估计。结合"held-out验证轨迹"的保守接受门槛,这一机制在精神上类似近端策略优化(PPO)的裁剪机制,但将安全性判据从参数空间的KL散度换成了任务空间的轨迹误差,更直接地面向PDE求解的最终目标。
实验结果:两个基准上的一致提升
论文在两个PDE基准任务上验证了方法效果,结果颇具说服力。
浅水方程(shallow-water)基准,32次干预预算:RV-PI取得三随机种子平均的轨迹相对L2误差为0.6910,相比即时策略改进提升5.37%,相比随机宏观策略(RandomMacro)提升2.41%。
受迫驱动的Brusselator基准,76次干预预算:RV-PI达到0.09954的相对L2误差,相比即时策略改进提升2.31%,相比RandomMacro提升5.32%。
两组实验呈现出一个值得玩味的互补现象:在浅水方程上,RV-PI相对即时策略的优势更明显(5.37%);而在Brusselator上,它相对随机策略的优势更突出(5.32%)。这说明不同PDE系统的误差传播特性不同,长程视角带来的增益也随之变化,但RV-PI在两类基准上都稳定优于两个对照方法。
浅水方程(Shallow-Water Equations, SWE)是描述薄层流体在重力和科里奥利力作用下运动的经典PDE组,广泛用于海洋模拟、大气动力学和海啸预报的基准测试;Brusselator则是描述化学振荡反应(布鲁塞尔振子)的反应-扩散方程组,其解在参数空间中会出现复杂的时空斑图(Turing patterns)和混沌行为,是测试模型处理多尺度、非线性演化能力的经典系统。两者代表了PDE的两类典型挑战:SWE以波传播和守恒律为主,误差主要体现为相位漂移;Brusselator以局部反应主导,误差更易在空间上集中爆发。这种互补性使得两者共同作为基准能较全面地评估自适应修正策略的泛化能力,也解释了为何RV-PI在两个任务上相对不同对照方法各有侧重的优势分布。
为什么这项研究值得关注
这篇工作的意义超出了具体数字。它用实验证明了一个在科学计算与机器学习交叉领域逐渐被认识到的原则:
在固定修正预算下,一次局部纠偏的价值取决于它对自回归轨迹的下游效应,而不仅仅是它带来的即时误差削减。
这个结论对任何涉及序列化预测、误差累积和资源受限的系统都有启发意义——无论是气象模拟、流体力学还是其他需要长时间演化的物理建模场景。将强化学习的长程信用分配思想引入神经算子部署,为"算力受限下如何最优使用修正能力"提供了一条新思路。
从方法论角度看,RV-PI的"真实rollout验证"虽然计算成本不低,但它避免了对下游效应的粗糙估计,用保守的接受机制换取了稳定性,这在实际工程部署中往往比理论上的激进优化更有价值。
相关推荐

MCP 实战:在 OpenAI Agents SDK 中接入外部工具
本文基于 YouTube 教程,详解如何在 OpenAI Agents SDK 中使用 MCP(模型上下文协议)接入外部工具:从构建 MCP 服务器、注册工具,到 stdio、streamable HTTP、Hosted MCP 三种连接方式,以及工具过滤的实战技巧。

深入MCP协议:AI Agent工具调用背后的性能陷阱
深入解析MCP(模型上下文协议)如何支撑AI Agent工具调用:JSON-RPC封装的性能开销、SSE多路复用的安全隔离,以及工程团队在生产环境中绕过协议直连数据库的真实权衡。

用 YAML 构建协作式 AI 智能体团队:Docker Agent 实践
Docker Agent 让你用 YAML 声明式配置构建协作式 AI 智能体团队,无需手写智能体代码。支持多智能体自动委派、MCP 工具集成,兼容 OpenAI、Anthropic、Gemini 等多种模型,配置可版本化、可共享。