巧用AI Agent零代码搞定生信分析:从工作站搭建到自动出图

用AI Agent加MCP与Skills,让零代码研究者跑通生信分析全流程。
文章针对生信分析中“ChatGPT只给代码却跑不起来”的痛点,介绍了AI Agent的解决方案。Agent能进入项目目录,创建并运行脚本、检查报错并自动修改,形成执行闭环。其能力由三个概念支撑:Agent负责执行,MCP负责连接PubMed、本地R环境等外部工具,Skills负责封装标准分析流程。文章对比了Claude Code与Codex两款本地Agent工具在易用性、功能和价格上的差异,并给出安装实操要点,包括Git与Node.js前置、环境变量配置以及通过ccswitch接入DeepSeek等国产模型。随后推荐了Scientific Agent Skills、Claude Scientific Writer、BioSkills和Nature Skills四个技能包,覆盖生信分析与论文写作全场景,最终目标是把研究者从环境配置中解放出来。
为什么普通ChatGPT搞不定生信分析?
很多做生信的同学都有过这样的体验:问ChatGPT“帮我写一个转录组差异分析的代码”,它能给你一段像模像样的R脚本;再问“火山图怎么画”,它也能给出ggplot2代码。但问题来了——代码拿到手之后呢?R语言怎么装?包怎么装?报错了怎么办?对于零代码基础的人来说,卡住的地方往往不是“不知道步骤”,而是“知道了也跑不起来”。
B站UP主Jeremy在“巧用Agent零代码完成生信分析”系列课程中一针见血地指出:普通聊天机器人只能告诉你大概步骤,而AI Agent可以真正进入你的项目目录,帮你创建脚本、运行脚本、检查输出结果,并根据报错自动修改。这二者之间的差距,就是从“纸上谈兵”到“真刀真枪干活”的差距。
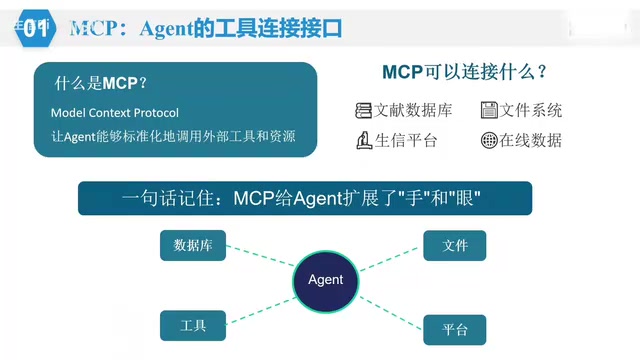
Agent的核心价值在于它是一个“随时待命的分析师”:你告诉它“根据当前文件夹里的表达矩阵和分组信息完成差异分析、KEGG富集和GSEA,结果整理到result文件夹,并生成分析报告”,它就会在你的电脑上一步步执行,而不是丢给你一段需要你自己调试的代码。
Agent背后的三个核心概念:Agent、MCP与Skills
要理解Agent为什么能干活,需要搞清楚三个概念。
Agent是执行者。它本身很聪明,但需要一个“工作场所”——你的项目文件夹。它在其中读取文件、写代码、运行、检查报错、修改,形成闭环。
MCP是Agent连接外部工具的标准化接口。Agent再聪明,也不能凭空变出文献或数据。它需要访问PubMed检索文献、调用本地R环境运行代码、连接专业分析平台。没有MCP时,AI生成的文献引用常常是“虚空编造”的——因为它只有内部记忆,无法真正访问PubMed。通过MCP连接后,检索结果才真实可靠。
Skills是给Agent准备的专业操作手册。转录组分析有一套标准流程:数据读取、质控、差异分析、富集分析、可视化、报告整理。每次都给AI解释一遍流程很麻烦,把标准流程封装成Skill,Agent遇到类似任务就能按SOP自动执行。
三者关系可以概括为:Agent负责执行,MCP负责连接工具,Skills负责规范流程。这套组合让AI不再是“随便乱跑”,而是在项目目录里按照生信分析的标准流程一步步完成任务。
MCP(Model Context Protocol,模型上下文协议) 是Anthropic于2024年底提出并开源的通信标准,旨在统一大语言模型与外部数据源、工具之间的连接方式。在MCP出现之前,每接入一个工具(如数据库、本地文件系统、第三方API)都需要单独编写适配代码,生态封闭且重复劳动严重。MCP采用客户端-服务器架构:Agent作为客户端发起请求,各类工具以MCP Server形式暴露标准化的“资源(Resources)”“工具(Tools)”和“提示(Prompts)”,从而实现一次开发、多端复用。对生信场景而言,这意味着PubMed检索、本地R环境调用、KEGG数据库查询都可以封装成独立的MCP Server,Agent按需调用,既保证了数据来源的真实性,也大幅降低了集成成本。
Skills(技能) 是一种将领域知识显式封装给AI Agent的机制。它通常以Markdown文档加配套脚本、资源文件的形式组织,包含任务描述、操作步骤(SOP)、注意事项和可调用的工具清单。与直接写进系统提示词相比,Skills的优势在于按需加载:Agent只在遇到相关任务时才读取对应技能,避免上下文膨胀,同时便于版本管理和社区共享。一个Skill本质上就是一份“可执行的专家经验”——把资深分析师脑子里的流程规范固化成Agent可以照着做的操作手册,这也是生信分析这类强流程性工作特别适合用Skills封装的原因。
本地Agent工具怎么选:Claude Code vs Codex
课程以两款主流本地Agent工具为例做了对比。
Claude Code是Anthropic基于Claude模型打造的中端AI编程Agent,网友简称CC。它默认使用Claude模型,但可以通过环境配置替换为其他模型,比如国产的DeepSeek广告。Codex则是OpenAI开发的产品,要求GPT Plus以上会员,目前也有教程将其替换为其他模型。
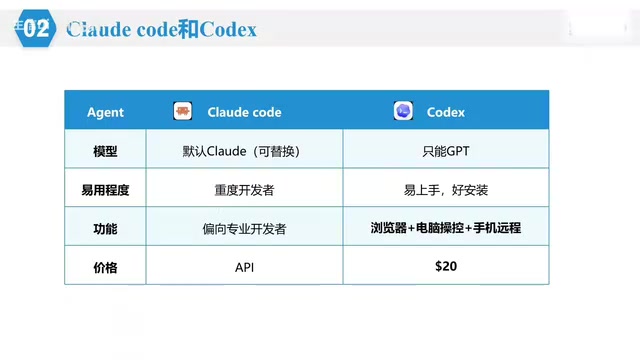
易用性上,Codex是桌面端设计,对新手友好,像微信聊天一样对话;Claude Code主要在终端使用,有一定门槛,但自由度更高。功能上,两者都支持Skills和MCP,Claude Code偏向专业开发者,Codex则支持浏览器访问、内置图像生成模型,还能用手机远程操控。价格方面,Codex基础Plus版本每月20美元对生信分析足够用;Claude Code的订阅风控较严,国内IP容易受限,多数人转而使用API,也有中转站和DeepSeek API等更经济的方案。
对于生信分析小白,Codex上手更快;但两者的核心逻辑一致——打开终端、进入项目文件夹、启动Agent、授权读写、下达任务。学会一个,另一个自然就会。
API(应用程序接口)与中转站 是理解国内使用Agent工具成本结构的关键。Claude Code、Codex这类工具本身只是客户端,真正的推理能力来自背后的大模型服务,调用时按Token(文本计量单位)计费。官方订阅(如Claude Pro、ChatGPT Plus)采用包月制,但存在地区限制和风控;API方式则按实际用量付费,灵活但需要自行管理密钥。所谓“中转站”,是第三方搭建的API代理服务,将请求转发至官方或兼容接口,通常价格更低、国内可直连,但稳定性和数据安全需自行评估。使用DeepSeek等国产模型的兼容API,是当前性价比较高的替代方案,其接口格式与OpenAI API兼容,因此能被多数Agent工具直接调用。
安装实操:环境变量是绕不开的坎
安装Claude Code之前需要两个前置:Git和Node.js。Windows用户通过PowerShell操作,Mac用户自带终端。安装过程中有一个关键细节——安装程序会显示一个路径,必须保存下来并手动添加到系统环境变量中,否则Agent无法被终端识别。
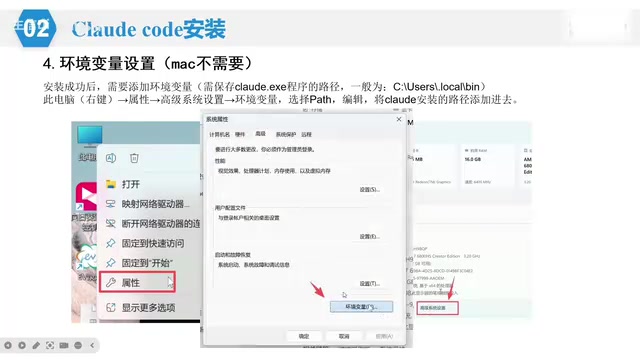
具体操作是:右键“此电脑”→属性→高级系统设置→环境变量→用户变量中找到Path→编辑→新建→粘贴安装路径→保存。完成后在PowerShell输入启动命令,能看到Agent界面就说明成功了。
安装后还需要配置大模型API。由于Claude在国内访问受限,课程推荐使用DeepSeek等国产模型,通过ccswitch这类第三方工具可以图形化切换API,填入API Key和地址,将主模型替换为DeepSeek V4 Pro版本即可。
安装完成后建议先跑简单测试,比如让Agent“在当前文件夹创建一个叫生信分析的文件夹”或“随机生成一组数据绘制条形图并保存为PDF”,确认工作流正常。
四个生信专用Skills,让Agent变成专家团队
Skills是这套工作流真正的价值放大器。课程推荐了四个对生信分析特别有用的技能包。
Scientific Agent Skills是目前最全面的科学技能集合,包含147个技能,覆盖100多个科学数据库,涵盖生物信息学、药物发现、临床研究、机器学习和数据可视化,可连接PubMed、UniProt、KEGG等公开数据库。
Claude Scientific Writer专注科学写作,用于学术论文、文献综述、临床报告等科研文档撰写。它的核心能力是从PubMed等数据库获取真实文献,内置论文质量评估系统,可完成临床病例报告、文献综述、meta分析及科技论文写作,配套同行评审、PDF/Word处理和图表生成功能。
BioSkills是专门针对生信分析的技能包,包含385个生信技能、67个类别,是目前最全面的生信技能库。覆盖FASTQ序列输入输出、NCBI/UniProt/Blast/SRA数据库访问、SAM/BAM文件处理、系统发育树构建、单细胞分析、转录组差异表达、甲基化分析、ChIP-seq等。
Nature Skills针对AI写科研内容“越界瞎写”的风险设计——把普通结果写成“首次揭示”、把未验证机制当成已证明。它内置严格的边界规则和证据校验流程,适用于SCI论文撰写与润色、Nature风格图表绘制、CNS文献解读、审稿意见回复、论文精读翻译和组会PPT生成。
这四个Skills安装后,Agent相当于内置了生信分析专家、论文写作专家和严格审稿专家。安装方式也很“Agent化”——直接在对话框输入“帮我安装某个skills”,Agent会自动完成。
Bulk转录组与单细胞分析 是文中反复出现的两类核心任务,理解其差异有助于判断Skills的适用场景。Bulk RNA-seq将一批细胞混合测序,得到的是样本层面的平均表达量,分析重点在差异表达(如DESeq2、edgeR)、富集分析(GO/KEGG/GSEA)和可视化;单细胞RNA-seq(scRNA-seq)则对每个细胞单独建库测序,数据量高出一个数量级,分析流程涉及质控过滤、降维聚类(PCA/UMAP)、细胞类型注释、拟时序轨迹和细胞通讯等,常用Seurat、Scanpy等工具。两者在数据结构、计算资源和解读逻辑上差别很大,因此BioSkills等技能包会按类别拆分技能,Agent需要根据输入数据特征选择对应的分析路径。
从环境配置到论文雏形的完整路线
课程后续将围绕一个真实生信分析项目全程由AI执行,同时增加手动运行代码验证AI结果的环节,覆盖R语言安装、R包安装、数据库获取、Bulk转录组和单细胞代码运行、结果解读到论文整理的全流程。
这套方法的意义不在于让AI替代分析,而在于把零代码基础的研究者从环境配置和报错调试中解放出来,把精力放在分析思路和结果解读上。Agent负责“手”,研究者负责“脑”——这或许是AI时代生信分析最务实的协作方式。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。