群蜂模式实测:AI编程助手EvoX正确率从26%飙到71%

EvoX Agent通过群蜂并行协作与代码级结果合并,将同一模型的编程正确率从26%提升至71%。
EvoX Agent是EvoMap推出的AI编程助手,其核心创新在于"群蜂模式":将复杂任务拆分为多个独立智能体并行处理,每个智能体拥有干净的上下文窗口,最终用代码而非另一个模型来合并结果。这一设计直接解决了单智能体与主从式子智能体架构共有的痛点——上下文膨胀导致信息丢失。基准测试显示,同一模型在群蜂模式下正确率从26%跃升至71%。此外,自进化技能机制通过"基因-胶囊-事件"体系将成功执行路径本地保存,官方称可降低约31%的token消耗;多模型自动切换则按任务难度匹配经济与强力模型,支持接入本地模型及多种社交平台渠道。对于已在使用Claude Code或Codex的开发者,EvoX更适合作为并行尝试的补充选项。
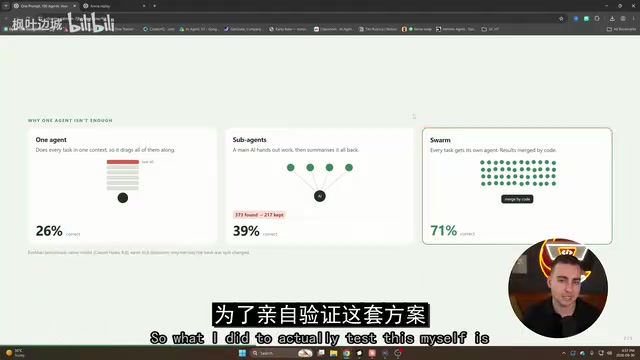
同一个模型,同样的563道题目。单个智能体独自作业只做对了26%,而当一群智能体以"群蜂"(swarm)模式协作时,正确率直接飙升到71%。模型本身没有任何变化,唯一改变的只是任务的拆分方式。这就是AI编程助手EvoX Agent最核心的卖点,也是一位海外博主在实测视频中反复强调的焦点。
本文基于该博主对EvoX Agent的完整实测,从安装设置到群蜂演示,拆解这款来自EvoMap的新型编程与生产力智能体究竟有何不同。
EvoX Agent是什么
EvoX Agent是EvoMap推出的编程与生产力智能体,目前支持Mac和Windows平台。在基础层面,它做的事情和Claude Code、Codex差不多——读取代码库、编写代码、运行命令、修复测试,这些功能都在,表现也符合预期。
真正让它区别于其他工具的,是三个特性:
- 群蜂协作(Swarm Collaboration):也就是那个26%到71%的数据来源。
- 自进化技能(Self-evolving Skills):每完成一个任务,它会把有效的做法保存为可复用的技能,下次遇到类似工作就更快、更省钱。
- 多模型自动切换:简单任务用便宜模型,困难任务用强模型,无需手动逐个挑选切换。
在设置界面的模型策略(Model Strategy)中,用户可以配置按难度切换模型:经济档位选DeepSeek广告这类便宜模型,平衡档位选GPT或Kimi K3等。博主还演示了接入本地模型的能力——通过AI服务页面可以连接LM Studio、Ollama,甚至指向独立设备(如DGX Spark)运行Nemotron、Qwen等模型,这意味着不必一直消耗云端额度。
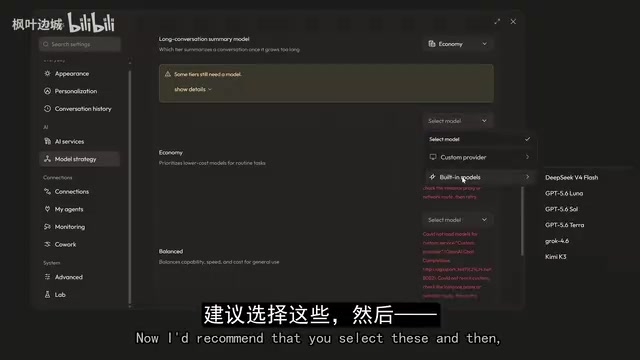
值得一提的是,注册即送1500个免费额度,无需绑卡即可试用,安装时还能一键导入Codex和Claude Code的设置、技能和连接器。
群蜂模式为何能把正确率翻近三倍
要理解群蜂的价值,得先看清单个智能体的问题所在。当一个智能体处理大型任务时,它会一路拖着全部上下文往前走。等到执行到第四个子任务时,它还背负着前三个任务的所有信息,于是"东西开始丢失"。
常见的修复方案是引入子智能体(sub-agents):一个主智能体派发任务、收集结果。这确实有帮助,但有个陷阱。根据EvoMap的基准测试,子智能体实际找到了373个正确答案,但最终只有217个进入了结果——因为负责合并的主智能体本身仍是一个大语言模型,它在归并过程中把正确答案给丢掉了。
群蜂模式的做法不同:它把每个任务隔离成独立的智能体,各自拥有干净的上下文,然后用代码而非模型来合并结果。这样一来,没有任何内容会在"总结"中被丢弃,结果也更一致。这正是71%与26%差距的根源——不是模型变强了,而是工作组织方式变了。
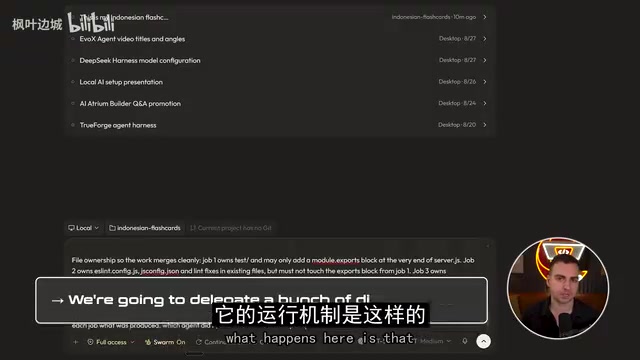
这里提到的"上下文窗口"(context window)是理解整个问题的关键。大语言模型并非拥有持久记忆,它每次只能"看到"一个固定长度的文本窗口——输入的问题、对话历史、代码文件等全部都要挤进这个窗口。当单个智能体处理包含大量子任务的复杂工程时,前几步的推理过程、中间结果、报错信息会不断累积,最终导致窗口被早期内容"占满",模型对后续指令的理解质量急剧下降,这种现象有时被称为"lost in the middle"效应——即便信息理论上仍在窗口内,模型也难以准确提取处于中间位置的内容。群蜂模式的本质是让每个子智能体只承担一个小任务,从一张白纸出发,始终在最高注意力密度的区间工作,从而规避了上下文膨胀带来的精度损耗。
三种工作模式实测
EvoX提供聊天(Chat)、协作(Cowork)、代码(Code)三种模式。
聊天模式适合咨询类问题。博主输入"我运营一个单词闪卡应用,该不该切换到SM-2算法",直接获得了带推荐理由的回答。
协作模式用于构建实际产物。博主拿自己用Claude Code做过的印尼语闪卡应用做测试,让它基于应用数据生成一份PDF进度报告,包含每个盒子的卡片数、各分类的准确率等。手动切换到GPT模型后,约一分钟就生成了完整的单页报告。
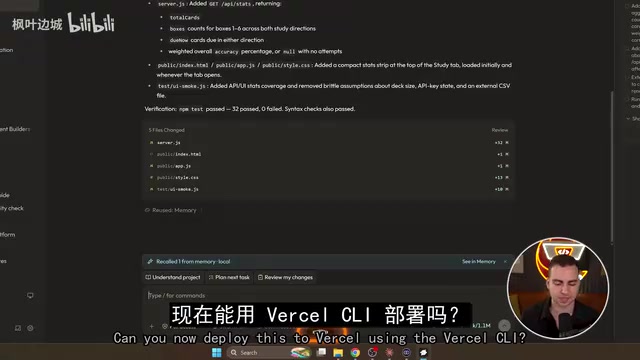
代码模式则直接改代码。博主要求它在study标签页顶部加一条统计条,显示总卡片数、各盒子卡片数和整体准确率,并测试通过。完成后他进一步让智能体用Vercel CLI部署上线,刷新页面后新增的分析信息正常显示。
自进化技能:像科学实验一样积累经验
点击左下角的"self evolution",可以看到一个完整的仪表盘,记录智能体学到的所有东西和构建的技能。它的进化遵循五个步骤:观察(observe)、发现(discover)、复用或改进(reuse/improve)、验证(validate)、固化(solidify)。
其中的核心概念值得拆解:
- 基因(Gene):最小的、经过测试的策略,比如"读取某文件"或"运行SQL查询并处理结果"。它只在智能体成功执行过后才存在,存放在本地库中。
- 胶囊(Capsule):整个任务及其解决方案被打包在一起。智能体解决过一次复杂问题后,整条路径会被保存,下次可以直接回放而非重新摸索。
- 事件(Event):对基因或胶囊的每次变更都会留下不可编辑的日志,用于审计。
EvoMap声称,当它学会代码库或对话中的常见模式后,token消耗可减少约31%。博主坦言无法当场验证这一数据,但基于此前的测试认为效果不错,并评价这套机制"更像科学方式运作,而不是随机生成技能文件"。
此外还有一个可选的"global"全局网络:你可以继承其他智能体学到的高分基因或胶囊,也可以发布自己的成果供他人复用,甚至通过贡献赚取额外额度。博主认为这是"在其他软件里几乎没见过"的特性。
与自进化技能相关的一个重要背景是"提示工程"的局限性。传统的AI编程助手依赖开发者在每次对话中手动提供足够的上下文和指令,一旦换个任务或新开一个会话,之前积累的"使用诀窍"便完全消失。EvoX的基因与胶囊机制本质上是在尝试解决这个无状态问题——将成功的执行路径序列化为可持久存储的结构化对象,而非依赖LLM本身的参数记忆。这与近年兴起的"工具记忆"(tool memory)和"经验回放"(experience replay)研究方向一脉相承。其中"验证"步骤尤其关键:只有经过实际执行验证的策略才会被固化为基因,这在一定程度上避免了模型将错误做法也一并"学习"保存下来。
100个智能体的生存游戏
为了更直观地展示群蜂威力,博主设计了一个名为arena的生存游戏实验,调用约100个智能体,每个负责为游戏设计一个物种(一个文件、一项主任务)。
群蜂把任务拆成100个并行子任务,每个智能体拿到相同规则、编写各自的物种、测试并改进,彼此看不到对方的工作,因为它们各处独立的上下文窗口。全部约20分钟完成,而顺序执行要花好几个小时。
实验跑了两代:第一代各智能体随机摸索策略,博主随后挑出表现最好的,让模型"不要照抄、但基于过去有效的做法"设计新策略。第二代里,模型发现了"保持原地、不过度攻击"这类更优策略,存活物种从第一代的64个(共100个)跃升到99个。
在更贴近真实的token对比中,群蜂处理印尼语应用的任务约用了84,000 token、七八分钟完成;而关掉群蜂、顺序执行同样的任务,耗时约为前者的2.5倍,上下文占用达到129,000 token。即便是相对简单的操作,群蜂也带来了明显的token效率和速度优势。
连接与扩展
在设置的连接(connections)页面,可以把智能体接入Discord、LINE、Messenger、Slack等渠道,还能扫码连接手机,意味着几乎能从任意集成触发。与其他harness一样,它也支持添加插件、技能、应用、子智能体和钩子(hooks),并可从其他智能体导入。
写在最后
这段实测由EvoMap赞助,但博主强调演示内容均可免费试用。抛开赞助因素,群蜂"用代码合并结果而非让模型总结"的思路,确实击中了多智能体系统的一大痛点——上下文膨胀导致的信息丢失。26%到71%的提升虽来自厂商基准,但其底层逻辑清晰可循,而自进化技能和全局网络也提供了与主流编程助手不同的想象空间。对于已经在用Claude Code或Codex的开发者,EvoX更像是一个值得并行尝试的新选项,而非立刻替换的理由。
相关推荐

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。

SageMaker HyperPod:跨团队共享GPU集群的隔离与公平性实践
Amazon SageMaker HyperPod 推出跨团队共享GPU集群的参考架构,通过IAM Identity Center认证、Kubernetes命名空间隔离、Task Governance公平调度和成本分摊,实现算力安全共享与费用透明化。