Qwen 4 Max评测:价格亲民的前沿级模型?
Qwen 4 Max以九分之一价格接近前沿,性价比突出但非顶尖。
阿里巴巴发布Qwen 4 Max,输出定价仅为Fable 5.2的约九分之一,提供100万token上下文与三档思考等级,权重未开源。阿里自选对手的基准表中它3行领先、Opus 5.5赢7行,且未对比最强模型;独立评测智能指数42.9,落后前沿超20分。真实任务中它通过全部59项隐藏测试,上一代则一次未过,但耗时约25分钟、成本高于GPT-6.1 Sol;82语言生成与草图建模拟表现亮眼,却存在速度慢、游戏平衡判断下降、细节不精确等问题。结论是它不以性能击败前沿,而以极低成本贴近前沿,适合高频代理与大规模编码,后续开源小模型可能更具冲击力。
阿里巴巴正式发布了Qwen 4 Max,官方将其定位为“前沿模型”。最引人注目的是价格:输出成本仅为竞品Fable 5.2的九分之一左右。但独立评测数据与真实用户体验却呈现出更复杂的图景——它并非真正的顶尖选手,却可能是最具性价比的实用选择。
发布节点与产品定位
据YouTube频道AI Equator的梳理,Qwen 4 Max于11月16日正式上线,但Qwen 4家族并非凭空出世。早在9月杭州云栖大会上,阿里巴巴就展示了Max、Plus、Flash以及一款27B小模型四个版本,当时仅有名称,没有规格、价格或基准测试。11月11日预览版开放,五天后Max正式可用。
产品规格上,Qwen 4 Max提供100万token上下文窗口,以及低、高、超高三个思考等级(默认高)。API定价为每百万输入token 1.50美元、输出4.50美元;作为对比,Fable 5.2的输入和输出分别为8美元和40美元——这正是“九倍便宜”说法的来源。用户可在QwenChat免费试用,API订阅“Token Plan广告”起价约每月6美元,新用户3美元。
需要留意的是,Max的权重并未开源。阿里巴巴表示后续会有更小的Qwen 4模型以开源权重形式发布,但未给出时间表。至于网络上流传的“2.4万亿参数”,需谨慎对待:2.4万亿是上一代Qwen 3.8 Max已确认的规模,阿里巴巴并未公布Qwen 4 Max的官方参数,目前无人知晓真实数字。
基准测试:有亮点,但对手经过挑选
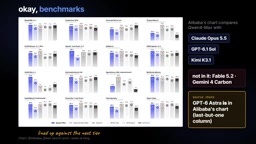
阿里巴巴的对比表格选择Claude Opus 5.5、GPT-6.1 Sol和Kimi K3.1作为对手。仔细观察会发现,Fable 5.2、Gemini 4 Carbon以及GPT-6 Astra均未出现在表中——这意味着阿里并未直接对标最强梯队,而是与次一级模型比较。
即便在这个经过挑选的对比中,结果也是喜忧参半。Qwen 4 Max在DeepSUE编码代理测试中以75.7分胜出;在考察计算机使用的Agent's Last Exam上以46.7分领先;在法律代理基准HLAB上拿到21.3分,而Opus 5.5仅为9.2分,优势明显。但在Terminal Bench 4.0上,Qwen 4 Max的48.5分落后于Opus的59.6和Kimi的67.2;Program Bench上31.5分对Opus的65分,差距超过一倍;Humanity's Last Exam上51.7分对59.8分。总计下来,Qwen 4 Max在3行中领先,Opus 5.5在7行中领先——而且这仍是阿里巴巴自己挑选对手的表格。
独立评测机构的结论更直接。Artificial Analysis给Qwen 4 Max的智能指数为42.9,Opus 5.5在最大努力模式下为59.1,Fable 5.2为64.6,差距超过20分。Val's AI的评测相对接近:Qwen 4 Max得分63.2%,Fable 5.2为71.3%。总体而言,在主要独立排行榜上,Qwen 4 Max明显落后于前沿水平。
理解基准测试结论时,需区分“智能指数”与单一任务基准。Artificial Analysis 的智能指数是一套将多个异构评测(推理、编码、数学、指令遵循等)加权合成的综合分,便于跨模型横向比较,但权重选择会影响排名,不宜当作绝对能力刻度。
Terminal Bench 4.0 考察模型在真实终端环境中完成多步命令行任务的能力,强调工具调用与错误恢复;Program Bench 侧重从自然语言到可执行程序的端到端生成;Humanity's Last Exam 则是高难度跨学科专家题集,用于探测知识上限;Agent's Last Exam 与 HLAB 更贴近代理式操作与法律专业场景。因此“某几行领先、多数行落后”往往反映的是任务类型偏好,而非全面强弱。
此外,模型厂商自建对比表通常会选择有利于己方的对手与任务组合,评估时应优先参考独立第三方在同一提示、同一评分脚本下的复现结果。
真实任务表现:能干活,但慢且需留意细节
排行榜之外,实际使用场景更能说明问题。Atomic Agent团队给Qwen 4 Max安排了一个真实编码任务:一个包含13个植入bug和一个缺失功能的股票库,由59个隐藏测试验证。Qwen 4 Max在三轮运行中全部通过59项测试,而上一代Qwen 3.8 Max一次都未能完成——这是显著的代际进步。
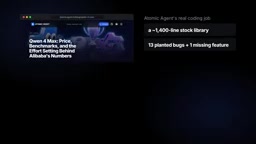
但时间成本不容忽视:Qwen 4 Max耗时约25分钟,Opus 5.5约4分钟,GPT-6.1 Sol不到两分半,而且Sol还更便宜(约29美分对Qwen的65美分)。
Kingie.ai的更大规模测试覆盖10个实用任务、5个模型、各运行2次、共200个评分阶段:GPT-6 Astra以19.8/20居首,Sol为19.6,Opus为19.2,Qwen 4 Max为18.65,Fable 5.2因部分输出失败或截断以17.3垫底。成本方面,Qwen 4 Max约3.60美元,Fable 5.2则高达61美元——质量排第四,成本排第二低。两次明显失误均出现在客户支持任务中,对尚未确定的退款输入了零值。
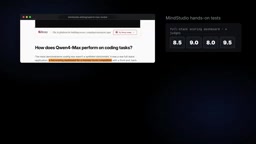
MindStudio的实操测试则展示了亮点:在一个全栈体育计分仪表盘中,Qwen 4 Max无提示地找到了隐藏的<应为<=的bug(该bug导致第四位评委的分数被丢弃),重建应用、重置数据库并验证修复;根据手绘的烤肉架草图,约15分钟构建出可运行的模拟,包含旋转速度、热量、切片厚度和肉色渐变;用82种语言发明运动队名,约4分钟完成且无一遗漏。X平台上一位测试者称,Qwen 4 Max为他的芯片基准自主进行了六轮改进,逐帧视觉检查并反复修复,全程约一天,仅消耗其5美元套餐的一半,并表示这是第一个真正让他惊讶的Qwen模型。
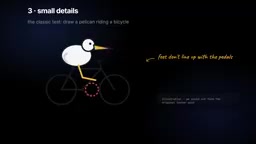
问题同样存在。首先是速度,测试者普遍反映比竞品慢,编码测试也印证了这一点。其次是游戏设计判断力:在考察模型能否判断游戏改动是否平衡的GameFeel测试中,预览版得分10.3,低于旧款Qwen 3.8 Max的12.1,甚至不如早期小尺寸Qwen 4模型。第三是细节:在经典的“骑自行车的鹈鹕”测试中,有测试者发现鹈鹕的脚并未真正对准踏板,看起来完成了,但不够精确。第四,预览版背后的订阅不允许应用后端或自动化脚本,目前构建真实产品仍有不便。
“思考等级”指模型在回答前允许进行多少内部推理步骤。Qwen 4 Max 提供低、高、超高三级并默认高,等级越高,模型越可能进行多轮自我检查与工具调用,质量通常提升,但延迟和 token 消耗也随之增加。这解释了真实测试中“通过率高但耗时长、成本不低”的现象:编码任务中 25 分钟与数分钟的差距,很大程度来自推理预算配置与代理循环次数。
对使用者而言,合理做法是按任务复杂度切换等级——简单改写用低档,复杂调试用高档,并在自动化流水线中设置超时与重试,避免单次调用无限拉长。
结论:不是前沿,但紧随其后
Qwen 4 Max是前沿模型吗?按独立数据,答案是否定的——Artificial Analysis显示它落后Fable 5.2超过20分,即便在阿里自己挑选对手的表格中Opus 5.5也赢下多数行,而最强模型根本没有被邀请参赛。
但关键在于:它并不打算以Fable的价格击败Fable,而是以极低成本接近前沿。在真实工作测试中,它完成了上一代Qwen无法完成的任务,并以远低于Opus的价格保持在同一量级。对于每天运行代理或进行大规模编码任务的用户来说,账单比排行榜更重要。更值得关注的是后续开源权重——如果阿里巴巴发布一款同样出色的更小尺寸Qwen 4模型,其冲击力可能超过Max本身。
“开源权重”与“开放 API”是两种不同的开放程度。权重未开源意味着用户只能通过阿里云接口调用,无法本地部署、微调或审计模型内部;开源权重则允许下载参数自行运行,便于数据合规、离线场景和二次训练,但也对算力提出要求。阿里巴巴表示后续会发布更小的 Qwen 4 开源模型,这类模型若保持相近能力密度,可能以更低部署成本覆盖边缘与私有化场景,因此其生态影响未必小于 Max 本身。
另一个需澄清的数字是参数量:网传“2.4 万亿”实为上一代 Qwen 3.8 Max 的已确认规模,Qwen 4 Max 官方并未公布参数,混合专家(MoE)架构下总参数与激活参数也常被混用,解读时需以官方发布为准。
相关推荐
Grok团队月均1.1万PR的秘诀:用确定性约束代替人工审查
Grok团队单月提交1.1万个PR、回滚率仅0.5%的背后,是一套用Lint规则、类型系统和形式化验证构建的确定性约束体系。本文拆解xAI工程师的四层信任金字塔,解释为何禁掉99%注释、禁用useEffect能替代人工代码审查。
时空是某种东西构成的吗?量子引力的六种可能答案
时空是某种东西构成的吗?本文梳理量子引力的主要候选答案:时空可能根本是基本的、几何被量子化、因果关系先于距离、时空是涌现的物态、几何从弦论中派生,或根本不需要时空原子。
GTA 6之后,游戏业将走向何方?
The Vergecast 对话 Game File 作者 Stephen Totilo,深度解析《GTA 6》对游戏行业的影响:十亿美元预算、主机市场困境、云游戏测试与微交易未来,探讨它是否标志着一个时代的终结。