Qwen 4 Max上线零基准测试,实测者发现了什么?
Qwen 4 Max 预览版零基准上线,社区实测呈现视觉强、代码不稳的分裂画像。
阿里巴巴 Qwen 4 Max 于 11 月 11 日以预览版形式上线,官方未发布任何基准成绩或模型卡,仅通过阿里云订阅制 token 套餐开放,支持百万 token 上下文与多模态输入。社区测试者自行拼凑能力画像:开发者 AI Joey 用单提示词五小时产出通过检查的 CPU 设计,但存在 19 项安全违规且不可制造;视觉构建类任务一次成型效果获高度评价,token 效率约为 DeepSeek 的四分之一;而代码修复测试仅得 49 分(对手 75 分),结果可复现性不稳。匿名模型 CoDuck 被证实为测试版。预览版 11 月 25 日退役,适合前端与原型场景低成本试水,生产级智能体任务建议等待正式版。
阿里巴巴的 Qwen 4 Max 于 11 月 11 日正式上线,但官方没有发布任何基准测试成绩、没有模型卡,甚至连一句跑分都没提。这种反常的沉默让社区测试者们在过去两天里自己动手,试图用真实任务拼凑出这个模型的真实能力画像。有人测出了惊喜,有人测出了失望,而其中一个关于 CPU 设计的细节,直接改变了我们解读所有测试结果的方式。
上线了什么:预览版、百万上下文、订阅制准入
官方发布帖承诺了更强的编码和智能体能力,浏览量已突破百万。但目前能实际接触到的只是一个预览版:支持一百万 token 上下文窗口,可读取文本、图像和视频,推理功能默认开启并处于最高档位。
这个版本不能下载,也没有按 token 计费的 API。唯一入口是阿里云广告的 token 套餐,按月订阅。价格比预期低不少——轻量档每月 6 美元,新用户优惠价 3 美元,截至 11 月 30 日,包含 20000 积分。据 NeuroHive 报道,预览期间 Qwen 4 Max 消耗积分速率最低仅为正常费率的五分之一,北京时间夜间更低至十分之一以下。
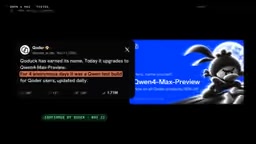
还有一个容易被忽略的线索:如果你上周用过阿里的编程应用 Coder,可能已经提前见过它。11 月 7 日,Coder 中出现了一个匿名模型 CoDuck,NeuroHive 发现其 token 套餐和分词器与 Qwen 一致,而它在预览版上线的瞬间就消失了。随后 Coder 确认:那四个匿名日里,Duck 就是 Qwen 的测试版本。
百万 token 上下文意味着什么
一百万 token 约相当于 70 万至 80 万个英文单词,或数本长篇小说的体量,也足以一次性装入一个中等规模代码仓库的核心文件。长上下文的核心价值在于让模型在单次推理中保持对大量材料的全局参照,例如跨文件理解依赖关系、通读整份设计文档后再生成代码。但长上下文并不等于“有效利用长上下文”:模型在超长输入中检索和推理关键信息的能力(常被称为“大海捞针”测试)往往随长度增加而衰减,且 token 消耗与成本同步上升。文中测试者观察到的 token 效率优势,需要在具体任务类型下理解,不能简单等同于长上下文能力强。
五小时设计 CPU:真实但不可制造
最引人注目的测试来自开发者 AI Joey。他在公开预览前一天,用早期 Qwen 4 checkpoint 给模型下了一个提示词,然后放手不管。五个小时后,模型交出了一份 CPU 设计——它自己写设计、跑测试、证明正确性,并产出了芯片代工厂真正会索要的文件格式。
更进一步,他把 Qwen 4 与另一个模型 SWE2 Flash 配对,经过 10.6 小时协作,得到了完整的电路板设计:四层板、144 颗 LED,Qwen 负责设计,另一个模型负责布线。
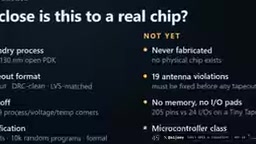
但大多数标题都跳过了同一篇帖子里的关键一句:还不能制造,存在 19 项安全违规,没有引脚定义,没有内存。所以这是一个通过了真实检查的真实设计,但明天还送不进工厂。AI Joey 自己的说法很克制——"只是在试着推一推这个模型"。
CPU 设计的交付物是什么
文中提到模型“产出了芯片代工厂真正会索要的文件格式”,这通常指 GDSII(版图数据)或用于流片的网表、时序约束等。一个完整的 CPU 设计流程包括:RTL 代码(用 Verilog/VHDL 描述逻辑)、逻辑综合、布局布线、时序分析和 DRC/LVS 物理验证。AI Joey 所说的“通过真实检查”,大概率指模型自行跑通了仿真和形式验证,证明逻辑功能正确。但“19 项安全违规”和“没有引脚定义、没有内存”意味着设计在物理实现和接口层面远未闭合——引脚定义决定芯片如何与外部电路连接,内存子系统则是 CPU 运行程序的前提。因此这是一个功能层面可验证、工程层面不可制造的原型,距离流片还有大量人工工作。
一次成型的视觉构建:强项所在
测试者 Ajay 对每个新模型都跑同一组一次性提示词,不给工具、不给重试机会。他向 Qwen 4 Max 要一个 V8 发动机剖面图,得到的是运动活塞、点火顺序,以及他根本没要求的控制面板。最让他意外的是,模型在代码里加了发动机音效——整个构建含思考过程约消耗 85000 token。
他评价最高的 Lighthouse Island 提示词,拿到了所有模型里最好的结果,一只机械蜂鸟一次成型,消耗不到 56000 token。另一个测试者 Lokdar 用同一套测试框架对比 Qwen 和 DeepSeek广告,Qwen 的 token 用量约为后者的四分之一。他还让 Qwen 为硬件合成器构建交互性最强的网站,一直运行到模型自称完成。
Qwen 对批评的接受度也不错。在肿瘤模拟器任务中,AI Joey 让 Opus 审查代码、Qwen 负责修复。三轮之后,代码里多了一个内置自检模块,包含 18 项检查。

基准测试真空下的分歧
官方零基准的做法引发了社区猜疑。9 月阿里发布 Qwen 3.8 Max 时还附带了 Code Arena 网页开发榜第一名的奖杯,这次却一片沉默。Lumina Bench 直接发问:"没有基准测试,我很想知道为什么。"
独立测试的结果并不一致。Lumina Bench 自己跑的 3D 直升机任务评价是"不算差,但还没达到当前模型的水平"。中国测试者 NFT Chen 用代码修复测试对比 Kimi K3.1 Pro,百分制下 Kimi 得 75 分,Qwen 4 Max 得 49 分。公平地说,这是单人测试,而且同一位测试者也发了一段鹈鹕骑自行车的动画——车轮完整旋转,鹈鹕稳坐其上。
这与 Lokdar 四天正面对比后的结论一致:Qwen 4 出效果时更漂亮,前提是它能出效果。有一个提示词 Qwen 试了三次,前两次失败,DeepSeek 一次通过。在他的螃蟹测试里,Qwen 赢在动画和 token 成本,DeepSeek 赢在沙地和光照。还有 Kiminismus 分享并明确标注为传闻的说法——"Qwen 4 令人失望"。无人证实,但在没有官方数字的情况下,传闻填补了真空。
整体形状大致如此:一次成型的视觉构建和 token 成本看起来很强,代码修复和结果可复现性看起来不稳。这大概正是"预览版"三个字的含义。
基准测试为何重要,又为何可能缺席
基准测试(benchmark)是用标准化任务集对模型能力打分的方法,如代码修复常用 SWE-bench,网页开发有 Code Arena 等竞技榜单。它的价值在于提供可横向比较、可复现的能力参照,降低用户的选择成本。厂商不发布基准可能有几种原因:预览版尚未调优完毕,跑分不具代表性;担心竞品对比不利;或刻意让社区实测形成话题。但零基准的代价是信息真空——传闻、单点测试和主观印象会填补空白,导致评价方差极大。文中 49 分对 75 分的代码修复对比来自单人单次测试,样本量极小,不能视为定论;同样,视觉任务的好评也依赖特定提示词和审美判断。解读任何社区测试时,都应关注任务类型、尝试次数和是否允许重试。
谁该试,谁该等
三个限制需要提前知道。套餐仅限在编程工具内交互使用,不能跑脚本、不能批处理。速度不快——Ajay 实测约每秒 47 token,一个河流场景花了 30 分钟。最关键的是,预览版 11 月 25 日结束,之后该模型即退役。
如果你做前端、3D 场景或快速原型,3 美元是了解"一个提示词能换来什么"的低成本方式。如果你需要智能体修复生产代码库,早期测试的建议是等正式版。阿里的帖子结尾下了战书:拿一个真实问题去测它。测试者们照做了,得到的是一个带 19 项违规的 CPU、一台能听见声音的发动机,以及一个百分制里的 49 分。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。