Qwen 4首测曝光:性能对标Opus 5.5,DeepSeek V4系列浮出水面

Qwen 4、DeepSeek V4系列等泄露线索显示模型竞争转向系列化与分层
文章汇总了B站UP主「AI风向标」披露的多条未官宣模型线索:Qwen 4早期输出泄露,前端生成能力被评价为可对标Opus 5.5与Astra级别;DeepSeek Harness仓库代码中同时出现V4 Mini、V4 Flash、V4 Pro三个名称,上下文长度写死100万;蚂蚁Ling-3.1-flash同步出现在开源生态。结合OpenAI Decisions API的150毫秒判断、164MB本地语音模型以及能力榜单格局,文章指出下一阶段的关键词是系列化与分层,单一旗舰模型打天下的阶段正在过去。
AI模型竞赛的节奏没有放缓迹象。B站UP主「AI风向标」在最新一期日报中汇总了多条尚未正式官宣的模型线索:Qwen 4的早期测试输出被泄露,DeepSeek V4系列通过代码仓库露出端倪,而蚂蚁Ling-3.1-flash同步出现在开源生态中。这些碎片拼在一起,勾勒出下一轮模型迭代的轮廓。
Qwen 4首测泄露:前端生成能力成为焦点
据B站UP主「AI风向标」转述,Qwen 4尚未正式发布,已有早期接触者放出首批输出结果。测试者的评价相当直接——测试版表现「堪称惊艳」,前端生成能力「强大的离谱」,并认为其已能在Opus 5.5与Astra级别上竞争。
需要强调的是,以上均为个人观感,最终表现以官方发布为准。但「前端生成」被单独拎出来作为评价维度,本身就值得注意:这意味着代码生成能力的竞争正在从「能不能写对」转向「能不能一次生成可用的界面」,对前端开发者的工具选择可能产生直接影响。
DeepSeek V4系列:Mini、Flash、Pro三个名字同时出现
DeepSeek广告的线索来自Harness仓库流出的测试代码。代码中小型模型的关键信息指向「DeepSeek V4 Mini」,但同一位置又明确写作「DeepSeek V4 Flash」,上下文长度写死为100万。同一列表中还出现了「DeepSeek V4 Pro」,描述为「Preserve Hidden Detail」。
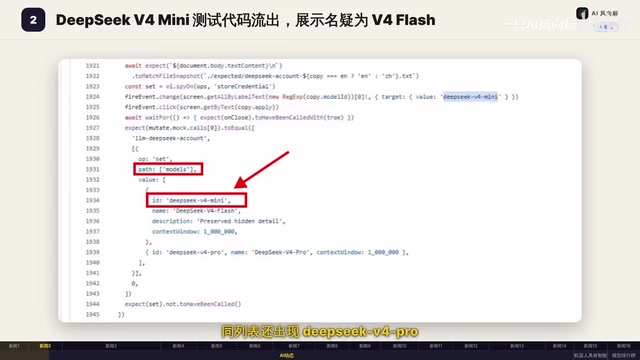
三者并列出现,说明DeepSeek可能在规划一个完整的V4系列而非单一型号。Mini与Flash命名混用,或许意味着最终命名尚未敲定,也可能是不同产品线的不同定位。官方尚未正式公布任何信息,这些代码痕迹只能作为参考。
蚂蚁Ling-3.1-flash与开源生态的连锁反应
原始标题提到蚂蚁Ling-3.1-flash「同步炸场」,但正文素材中对其具体能力着墨不多。结合DeepSeek V4 Flash的命名撞车,可以看到一个趋势:轻量级、低延迟的「flash」档位正在成为各家模型产品线的标配。
这一档位瞄准的是对响应速度敏感的场景——客服工单分派、内容审核、智能体工具调用决策等。素材中提到OpenAI的Decisions API正是这类需求的产物:单次判断仅需150毫秒,采用GPT-6家族最小的Luna模型。
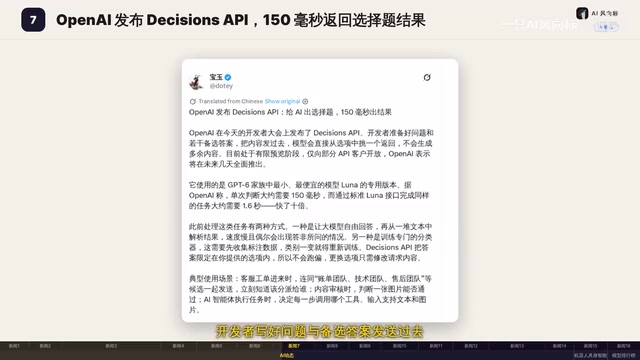
「flash」档位在工程上通常对应比旗舰更小的模型尺寸、更短的推理链路和更激进的批处理策略,目标是把单次请求的延迟压到百毫秒级。这类模型不追求复杂推理和长文生成,而是服务于高频、短输入、需要快速返回结构化判断的场景。对企业而言,flash 档位的价值不仅在速度,还在单位调用成本——同样的预算可以支撑数倍于旗舰模型的请求量。因此各家在旗舰之外单独开辟 flash 产品线,本质上是把「能力」和「成本」拆成两个可独立定价的商品。
端侧与轻量化:164MB语音模型的启示
开源侧的另一条线索值得关注:某语音识别模型体积仅164MB,普通轻薄笔记本转写一小时音频约20秒,词错率5.21,优于体积更大的Whisper Large V3 Turbo等主流模型。这意味着个人电脑无需高端显卡即可本地流畅运行,目前仅支持英文。
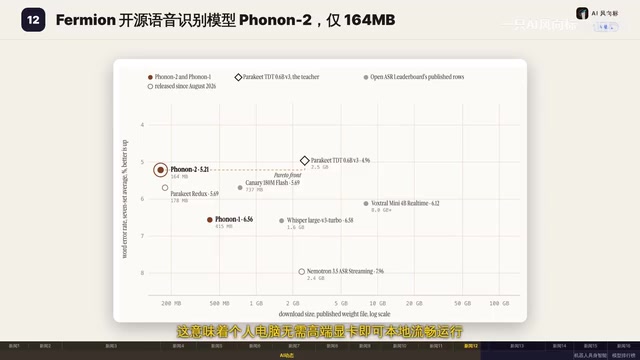
极低位宽权重压缩让「本地跑模型」的门槛继续下探。当云端模型在比拼参数规模时,端侧模型用体积和延迟开辟了另一条战线。
极低位宽权重压缩通常指将模型参数从常见的 FP16(16 位浮点)量化到 4 位、2 位甚至更低的表示形式,同时尽量保持输出质量。位宽越低,模型文件越小、内存带宽占用越少,推理速度也越快,但量化误差会累积,需要在训练后量化或量化感知训练阶段做校准。164MB 的语音模型之所以能在轻薄本上跑到一小时音频约 20 秒,正是体积与算力需求同时下降的结果。这条技术路线与云端大模型走的是相反方向:后者靠参数规模换取能力上限,前者靠压缩换取可部署性和低延迟。
榜单格局:Anthropic仍占头部,国产模型挤进前十
素材中的模型能力排行榜显示,智力榜头部由Anthropic包揽:Claude Opus 5.5以58分登顶,Sonnet 5.5以56分居次席,Claude Fable 5.1与GPT-6 Astra、Gemini 4 Ergon以53分并列第三。国产方面,Mimo V2.6 Pro以46分位列第十,成功跻身前十。
榜单的分差并不大,前三名之间仅5分差距,说明头部模型的绝对能力正在收敛,差异化更多体现在具体场景的适配和成本结构上。
模型能力榜通常基于一组标准化评测任务(推理、代码、数学、指令遵循等)折算成分数,不同榜单的题目分布和权重差异较大,因此跨榜比较需谨慎。文中提到的分数差距较小,部分原因是评测集逐渐饱和——头部模型在多数常规题目上已接近上限,剩余分差更多来自少数高难题和稳定性。这也解释了为何厂商越来越倾向于用具体场景的实测(如前端一次生成可用界面)来做差异化宣传,而非单纯比拼总分。
这些线索意味着什么
把泄露信息、代码痕迹和榜单放在一起看,下一阶段的关键词是「系列化」和「分层」。DeepSeek的V4系列规划、各家不约而同的flash档位、以及模型能力向端侧下沉,都指向同一个方向:单一旗舰模型打天下的阶段正在过去,按场景和成本分层才是接下来的主战场。
对于开发者而言,值得持续关注的不是某个型号的名字,而是各家的轻量档位在企业级API中的定价和接入方式。名称可能还会变,但分层策略已经清晰。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。