Qwen Image 2.1 本地实测:开源图像编辑能否叫板闭源?
阿里开源Qwen Image 2.1实测:单图编辑和文字生成达开源天花板,但分镜逻辑与商用授权仍是短板。
阿里开源的Qwen Image 2.1是一款主打图像编辑的多模态模型,相比上代2511有飞跃式提升,被评为当前开源图像编辑领域最强。实测显示其人物一致性、文字生成和换衣场景表现优秀,但四格漫画分镜逻辑和影视分镜质量仍明显落后于GPT等闭源产品。本地部署门槛方面,8GB显存可运行但受限于分辨率和参考图数量,多参考图场景下即使5090D也需数分钟生成,低配置用户需使用INT8量化版并严格控制参考图。模型对提示词依赖极高,官方提供PE扩写模块和模板,但PE本地模型建议跳过。此外,当前开源协议仅限非商业研究用途,商用需另行申请授权。
阿里的 Qwen Image 2.1 正式开源,这是一款主打编辑能力、同时兼具文生图能力的图像模型。B站UP主梨花第一时间搭建了工作流并进行了七组实测。核心问题很直接:开源图像编辑模型,到底能不能替代 GPT、Nano Banana 这类闭源产品?
为什么这次开源值得关注
开源社区在图像生成领域与闭源的差距一直不大,视频生成此前差距明显,但随着 MiniMax Hailuo 等模型开源后被逐渐弥补。真正的短板落在了图像编辑这一块。Qwen Image 2.1 正是冲着这块空白而来。
据梨花的实测评价,相比上一代的 2511,这一代实现了「飞跃式的提升」,称其为「开源最强」并不夸张。但他也坦言,要说打得过 GPT 或 Nano Banana 这类闭源产品,仍有些言过其实——细节问题依然不少,而且模型对提示词的依赖极高。
模型构成与本地部署门槛
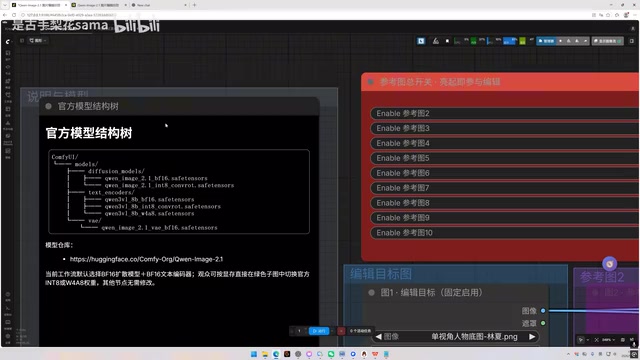
官方本次放出的资源相当完整,包括两个底模(BF16 与 INT8 量化版)、三个文本模型(BF16、INT8、FP8)、一个 BF16 的 VAE,以及两个分别支持图片编辑和文生图的 PE 模型。
所谓 PE 模型,实际上是独立的 Qwen3 9B 提示词扩写模块,可理解为官方提供的提示词改写工具。它会把你输入的短指令扩写成长提示词。
梨花在工作流中并未集成 PE,理由很实际:这个本地 9B 模型语言能力有限,处理简单指令没问题,但遇到复杂的多图编辑、人物关系时扩写结果不佳。更关键的是,它并非出图的必需组件,却要额外加载接近 10GB 的模型,占用显存内存、拉长生成时间。对低配置用户来说得不偿失。
好在官方同时提供了提示词扩写模板,用户完全可以把模板喂给任意大语言模型来生成长提示词,反而更省事。
显存与速度的现实
本地部署方面,8GB 显存可以跑,但分辨率和参考图数量会受限,其中参考图数量对显存的压力最大。梨花用 5090D 跑满血全 BF16 模型,单图编辑 50 步 2K 分辨率约需一分半,但三参考图直接飙到八分钟,差距悬殊。配置不高的用户建议使用 INT8 量化模型,并严格控制参考图数量,否则大概率爆显存。
对于本地跑不动的用户,UP主也将工作流上传到了 RunningHub 云端平台可供体验。
BF16、INT8、FP8 是模型权重的不同数值精度格式。BF16(Brain Float 16)是完整精度版本,推理质量最高但显存占用最大;INT8 是 8 位整数量化,显存占用约为 BF16 的一半,质量损失通常较小;FP8 则是更激进的压缩,适合显存极为有限的场景。VAE(Variational Autoencoder,变分自编码器)是图像生成流程中的关键组件,负责将图像在像素空间与潜空间之间转换——扩散模型的采样过程发生在低维的潜空间,最终由 VAE 解码还原成可见图像,其精度直接影响图像的清晰度和色彩还原。
5090D 是英伟达 RTX 5090D 的简称,「D」版本是专为中国大陆市场定制的阉割版,相比国际版 5090 在互连带宽上有所削减,但显存容量同为 32GB GDDR7,是目前面向消费级市场的最高配置之一。梨花在此配置下跑满血 BF16 模型尚需数分钟,普通用户(如 8GB 或 12GB 显存的 30/40 系显卡)遇到多参考图场景时爆显存几乎是必然的,INT8 量化加上控制参考图数量是目前最实际的应对策略。
工作流的三个关键设置
搭建工作流时有几个要点需要注意:
- 内核更新:ComfyUI 内核必须更新到最新开发版本,否则会报错。
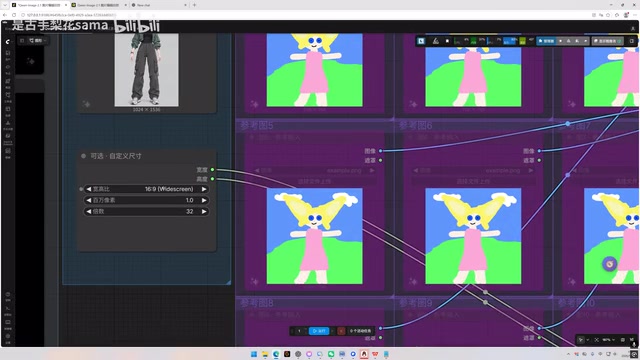
- 分辨率模式:一种是按原图宽高比生成,此时需关闭 custom size 节点,参数为 0 则沿用原图分辨率。但若原图为 4K/8K,需手动改成如 1024,让模型保持宽高比并把总像素压到约 1024×1024,避免爆显存。另一种是打开 custom size 指定比例(如 3:4、16:9),数值 1 对应约 1024×1024 总像素,2K 则需拉到 4(约 2048×2048)。
- 采样步数:官方推荐 40–50 步,25 步也能正常出图,但 40 步以上在细节与质感上明显更好,具体取决于对速度的取舍。
七组实测:强在哪,弱在哪
单图编辑:一致性与文字表现亮眼
人物四视图测试整体一致性保持不错,链条、手表、肩膀标志的方向大体正确。更复杂的人物资料卡是过去 2511 完全无法胜任的场景——文字和图案会错乱,而 Qwen Image 2.1 布局清晰、小字可辨,仅有个别文字出错。对开源模型而言已相当出色。
不过一旦继续增强信息密度(加更多格子和文字),画面就会崩坏。这方面确实不如 GPT,但正如梨花所言:闭源模型出于审核限制,很多内容压根不给你出——这是开源不可替代的价值。
漫转真(写实转换)测试在无 LoRA 的情况下美学已可接受,且原生具备较好的一致性保持能力。人物姿势与表情修改中,脸部和衣服细节一致性都保持得很好。
多图编辑:换衣服表现稳定
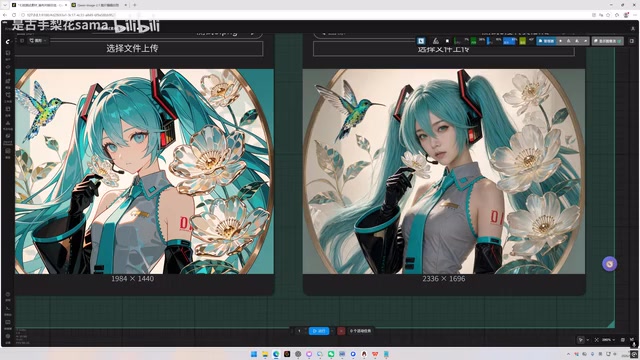
换衣服是常用场景。过去 2511 需要把衣服单独抠出,穿在人身上的衣服识别效果差。这次测试直接迁移穿在人物身上的衣服,一致性、质感、细节都保持良好,原图基本无变形。
漫画与影视分镜:短板暴露
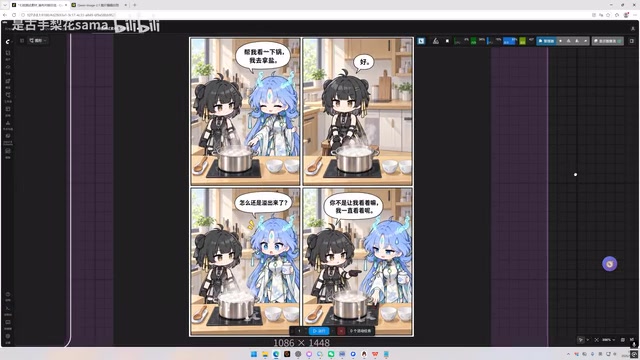
人物参考出四格漫画时,模型确实能做出漫画效果,画面质感清透,但细节问题不少:锅里汤汁溢出、道具消失、气泡归属错误、表情不到位。横向对比 GPT(相同提示词),GPT 画面会有色斑色块感,但在分镜逻辑、台词归属和表情表现上领先较多,综合完胜。
三参考的电影剧情分镜测试则「有点难绷」,格子和人物细节都偏糊。梨花的结论是:做正经影视分镜、追求高效高质量,还得靠闭源;开源虽能出,但需要反复抽卡改提示词,效率不划算。
「抽卡」是 AI 图像生成社区的常用说法,指同一提示词多次生成取优的过程,类比抽盲盒——每次生成结果都有随机性,需要反复运行才能碰到满意的输出。这一现象在对构图、人物数量、台词归属等有精确要求的分镜场景下尤为突出,因为每次抽卡成本(时间和算力)较高,整体工作效率远不如闭源产品稳定出图的表现。
结论:开源最强,但闭源仍有护城河
不吹不黑,Qwen Image 2.1 在开源领域综合能力全面,人物一致性和文字生成都有不错表现,堪称当前开源图像编辑的天花板。但追求高效和细节质量时,闭源依然占优——即便是顶级消费级配置,在多参考、高分辨率场景下生成耗时依然漫长,还得不断抽卡调词。
需要特别提醒的是授权问题:按照阿里的开源协议,该模型当前公开授权仅限非商业的研究和评估用途。若要用于商业项目,需另外向官方申请商业许可,此外还有诸多限制条款。个人把玩无所谓,商用前务必仔细阅读开源协议。
相关推荐
Vibe Coding 深度解读:从写代码到指挥AI的一人公司实战路径
Vibe Coding 是什么?本文解读从「人写代码」到「人指挥AI」的开发新范式,涵盖Claude Code、Codex、Cursor等工具协同、全链路闭环、多端开发与AI自动化运营,剖析一人公司与超级个体的机会与误区。
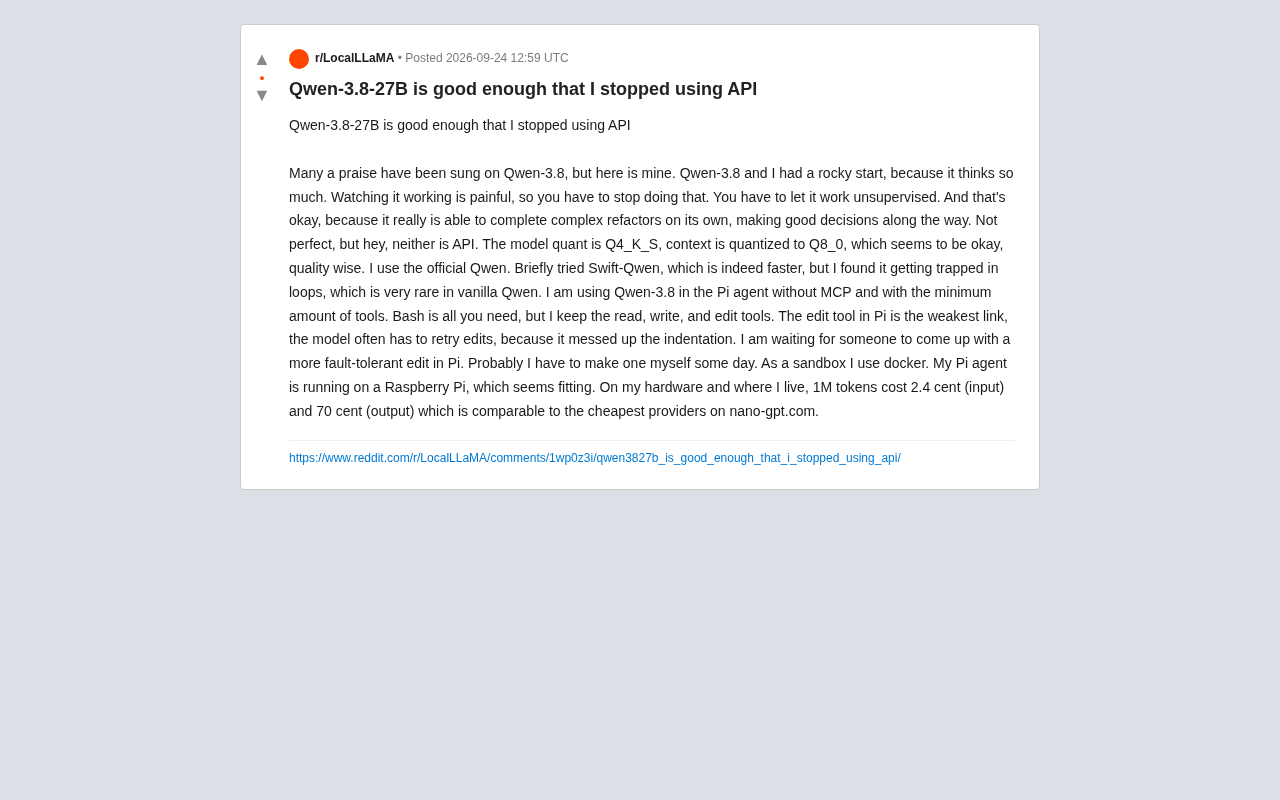
本地跑 Qwen-3.8-27B 替代 API:一位开发者的实战体验
一位 Reddit 开发者分享用本地 Qwen-3.8-27B 完全替代云端 API 的实战经验,涵盖 Q4_K_S 量化、Pi agent 极简工具链、树莓派部署与详细成本核算,探讨开源大模型「够用」的临界点。
生产环境中如何验证AI Agent的行为?运行时校验实战指南
AI Agent在生产环境代表用户执行操作时如何验证其行为?本文从非确定性输出、不可逆副作用等挑战出发,梳理策略护栏、人在回路、运行时追踪、LLM评判等验证方法,帮助团队构建分层防御体系。