Qwen Image 2.1 Edit 实用提示词技巧全解析
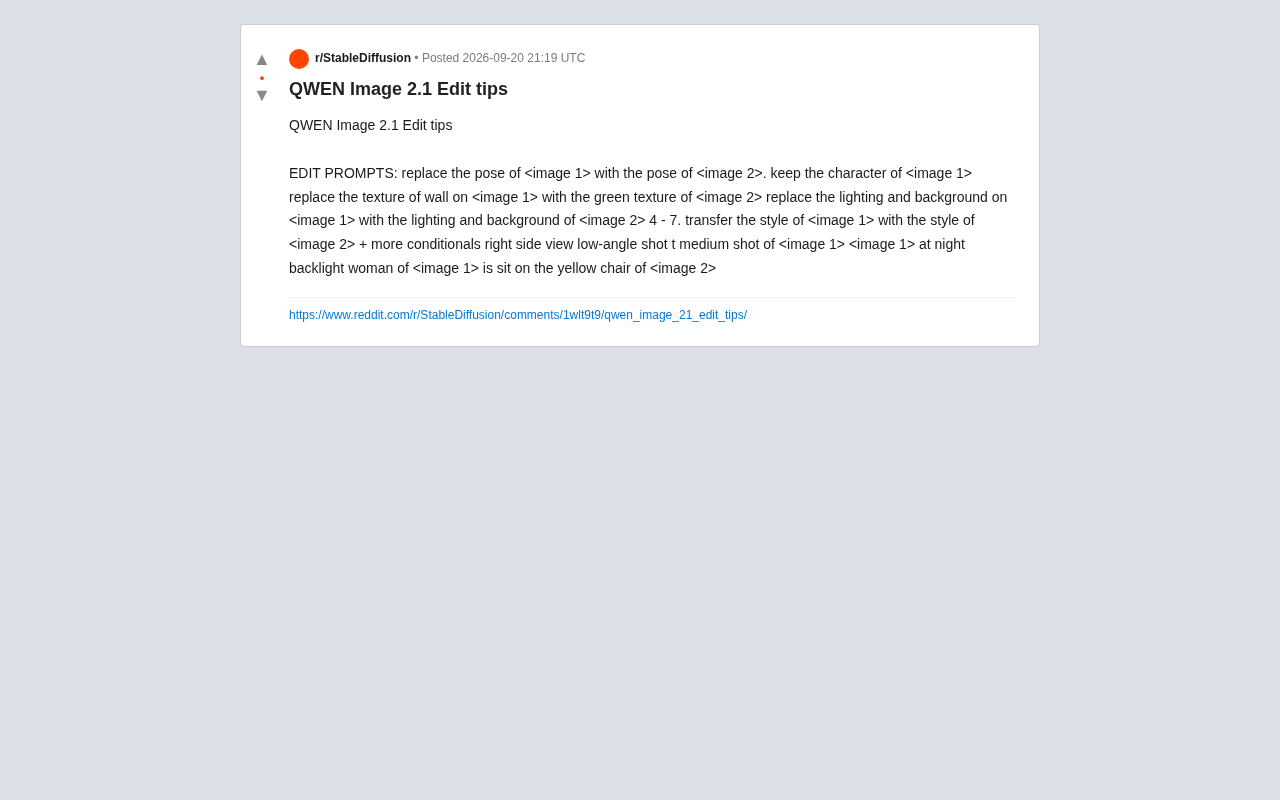
Qwen Image 2.1 Edit通过多图占位符语法,实现姿态、纹理、风格等属性的跨图精准迁移与场景重组。
阿里通义千问团队推出的 Qwen Image 2.1 Edit 模型,支持通过 `<image 1>`、`<image 2>` 等占位符同时引用多张图片,从而明确区分各图在生成过程中的角色——主图提供主体,参考图贡献特定属性。一位 Reddit 用户整理的实战提示词揭示了该模型的核心用法:遵循「主图 + 参考图 + 保留项」的三段式结构,可完成姿态迁移、纹理替换、光照与背景解耦替换、风格迁移等任务,还能识别 low-angle、medium shot、backlight 等摄影术语来控制镜头视角。进阶用法则可将不同图片中的对象跨图组合,实现场景重组。文章同时提示,这些提示词来自社区经验而非官方验证,实际效果因素材和模型版本而有明显波动,建议以模板为起点反复微调。
阿里通义千问团队推出的 Qwen Image 2.1 Edit 模型,主打多图参考的图像编辑能力。与传统的文本生图不同,它允许用户同时引用多张图片作为条件,通过结构化的提示词精准控制姿态、纹理、光照、风格乃至镜头视角。一位 Reddit 用户整理了一批实战验证过的编辑提示词,为理解这类多图编辑模型的工作逻辑提供了很好的样本。
多图引用的核心语法
Qwen Image 2.1 Edit 最关键的特点是支持 <image 1>、<image 2> 这样的占位符引用。这套语法的意义在于,模型不再把所有输入混为一谈,而是能明确区分「哪张图提供什么信息」。
以姿态迁移为例,提示词写作 replace the pose of <image 1> with the pose of <image 2>, keep the character of <image 1>。这条指令拆解开来包含三层意图:以第一张图为主体、借用第二张图的姿态、并保留第一张图的角色特征。这种「主体 + 参考 + 保留项」的三段式结构,是多图编辑提示词的通用范式。
理解这一点后,其他编辑任务都可以套用同样的思路——先确定要保留的主图,再指定从参考图中提取哪一个维度的属性。
多图占位符机制在技术层面属于「条件图像生成」(Conditional Image Generation)的一种扩展形式。传统的图生图模型(img2img)通常只接受单张参考图,通过调节去噪强度(denoising strength)来平衡保留原图结构与融入新内容的比例,难以精细拆分不同图片的贡献。而 Qwen Image 2.1 Edit 采用的多图引用语法,本质上是在提示词层面为模型建立了一套「注意力路由」机制——模型在处理不同语义指令时,会优先关注对应占位符所绑定的图像区域或特征。这与近年来多模态大语言模型(MLLM)将图像编码为 token 序列的架构密切相关:每张图像对应独立的 token 序列,提示词中的 <image N> 标记使模型能够在推理时将语义指令与特定图像的 token 流对齐,从而实现跨图属性的精准提取与融合。
属性替换类提示词
分享者列出了几类高频的属性替换用法,本质上都是「从参考图抽取单一属性,替换到主图对应位置」。
- 纹理替换:
replace the texture of wall on <image 1> with the green texture of <image 2>,把主图墙面的材质换成参考图的绿色纹理。 - 光照与背景替换:
replace the lighting and background on <image 1> with the lighting and background of <image 2>,同时迁移光照氛围和背景环境。
这类提示词的价值在于「解耦」。传统图生图往往牵一发而动全身,改光照可能连带改变主体;而 Qwen Image 2.1 Edit 通过明确点名要替换的属性(texture、lighting、background),试图让编辑更具针对性。实际效果如何还需按具体素材验证,但这种指令设计方向值得关注。
风格迁移与条件叠加
分享中提到风格迁移的写法为 transfer the style of <image 1> with the style of <image 2>,并可叠加更多条件(more conditionals)。风格迁移相比纹理替换更抽象,涉及色调、笔触、整体质感等综合因素,因此往往需要配合额外的限定词来收窄结果范围。
所谓「叠加条件」,是指在一条提示词里同时给出多个约束,让模型在满足风格要求的同时兼顾构图、光线等其他目标。这也提示了此类模型的一个使用心得:提示词越结构化、约束越明确,输出越可控。
风格迁移(Style Transfer)作为一个研究方向,最早可追溯到 2015 年 Gatys 等人提出的基于卷积神经网络(CNN)特征统计的方法,通过匹配内容图与风格图在不同网络层的 Gram 矩阵来合成新图像。扩散模型时代的风格迁移则转向了基于文本或图像条件的引导生成,核心挑战在于「内容-风格解耦」:模型需要识别哪些特征属于可迁移的风格(色调分布、笔触频率、纹理统计),哪些属于应当保留的语义内容(物体形状、人物身份)。Qwen Image 2.1 Edit 通过「叠加条件」的方式应对这一挑战——用户可以同时给出风格参考图和内容保留指令,让模型在多个约束之间寻找平衡点。这种方式的局限在于,当多个约束之间存在冲突时(例如风格图的构图与内容图差异过大),模型可能会在不同约束之间随机倾向,输出稳定性下降,这也是为什么建议使用者反复微调提示词的根本原因。
镜头与视角控制
除了内容层面的编辑,Qwen Image 2.1 Edit 还能理解摄影语言,对镜头视角进行调整。分享者给出了一组示例:
right side view(右侧视角)low-angle shot(低角度仰拍)medium shot of <image 1>(中景镜头)<image 1> at night backlight(夜晚逆光效果)
这些术语借鉴了传统摄影和影视的镜头语言。能够识别 low-angle、medium shot、backlight 等专业词汇,意味着模型在训练时接触了大量带有摄影标注的数据,用户可以像指导摄影师一样描述想要的画面。
组合式复杂编辑
最能体现多图编辑潜力的,是把多个元素跨图组合的用法。示例中 woman of <image 1> is sit on the yellow chair of <image 2> 就是典型——从第一张图取出人物,让她坐到第二张图里的黄色椅子上。
这类指令要求模型同时完成对象识别(找到 woman、找到 yellow chair)、空间关系推理(sit on)和跨图合成。它体现的是从「单属性替换」向「场景重组」的进阶,也是这类编辑模型区别于简单滤镜工具的核心能力。
跨图对象组合在计算机视觉领域被称为「图像合成」(Image Compositing)或「对象级编辑」(Object-level Editing),其难点不仅在于识别和分割两张图中的目标对象,还需要处理光照一致性、透视匹配、遮挡关系以及边缘融合等问题。传统方法依赖人工抠图和后期合成,往往需要专业软件操作。基于扩散模型的方法通过在去噪过程中同时注入多个图像条件,理论上可以让网络自动学习跨图合成所需的几何变换和外观调和。然而,「sit on」这类空间关系指令对模型的三维空间理解能力提出了较高要求——模型需要推断椅子的大小与人物比例是否匹配、人物坐姿如何与椅子形状适配。当两张参考图的拍摄角度、光线条件或画面风格差异较大时,合成结果的自然度会显著下降,这是当前多图编辑模型普遍面临的瓶颈。
使用建议与局限
从这份社区分享中可以提炼几条实用原则:明确指定主图和参考图的角色分工;用具体名词点名要编辑的属性(pose、texture、lighting、background、style);善用摄影术语控制视角;复杂需求可组合多个条件。
需要说明的是,这些提示词来自单一社区用户的经验总结,未经官方文档系统验证,实际生成质量会因输入图片、模型版本和随机性而有明显波动。建议使用者以这些模板为起点,结合自己的素材反复微调,逐步找到稳定可用的表达方式。
相关推荐
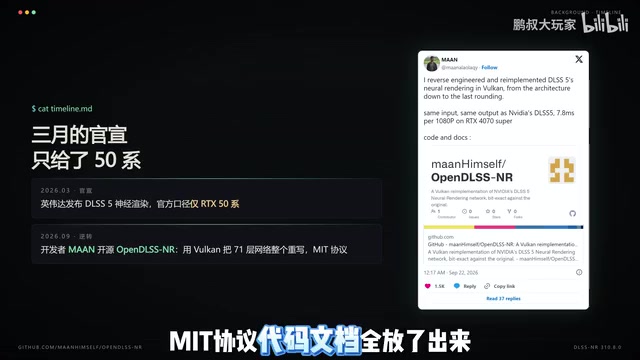
开源复刻DLSS 5:OpenDLSS NR让RTX40系甚至浏览器都能跑
开发者MAAN用Vulkan开源复刻英伟达DLSS 5,项目OpenDLSS NR实现逐字节一致的神经渲染网络,RTX40系显卡甚至浏览器都能运行。本文解析复刻精度、性能数据与落地门槛。
168人俘虏印加皇帝:卡哈马卡伏击战的权力逻辑
1532年皮萨罗率168人在卡哈马卡俘虏印加皇帝阿塔瓦尔帕。本文还原这场悬殊对决背后的征服剧本、心理威慑与擒贼先擒王的权力逻辑。
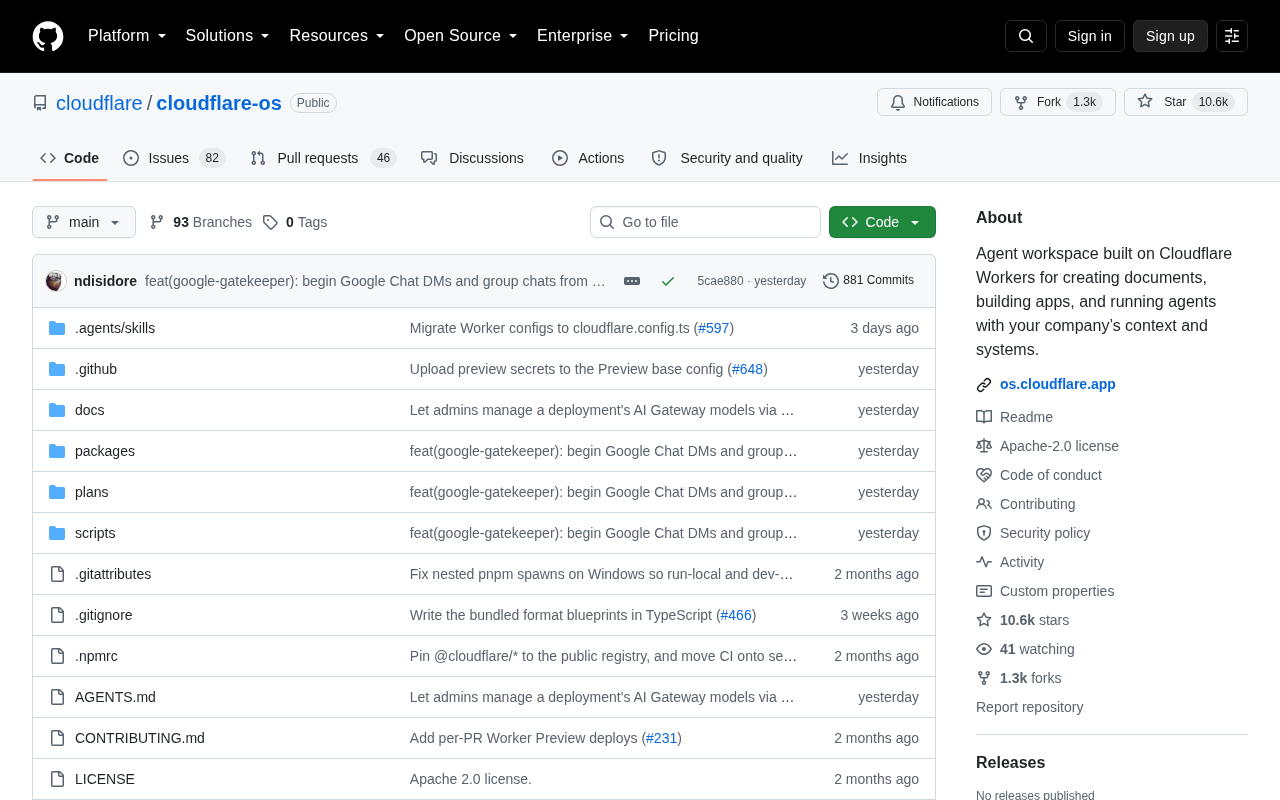
Cloudflare OS:构建在 Workers 上的 AI Agent 工作空间
Cloudflare 开源 cloudflare-os,一套构建在 Workers 上的 AI Agent 工作空间,支持创建文档、构建应用、运行智能体并整合企业上下文与系统。项目已获超 1 万 GitHub 星标,本文解析其定位、技术底座与开发者价值。