Qwen Image 2.1本地32项实测:数数翻车,动漫风格意外能打
RTX 5090本地实测Qwen Image 2.1:文本布局可靠,计数与几何翻车。
B站UP主Luke的DevLab用RTX 5090在本地对Qwen Image 2.1进行了32组提示词压力测试,覆盖拼写、计数、空间布局、人体结构、材质风格与几何结构等维度。结果显示:单词拼写、颜色位置指令和空间关系可靠,动漫风格的人体与场景表现超出预期,多人物群像一致性较高;但物体计数失败(5个苹果数不对),自行车轮辐条等精细几何结构明显翻车,写实人体姿势结构错乱,杯子装水等物理一致性场景也出现问题。此外,多张生成图反复出现疑似训练数据残留的紫色印记,UP主向社区求助排查。模型可生成无审查内容,测试图集将公开供横向对比。
图像生成模型扎堆发布的当下,Qwen团队交出了Qwen Image 2.1这张牌。B站UP主Luke的DevLab用一张RTX 5090在本地跑了32组提示词,从拼写、数数到人体结构、材质反射,做了一轮相当细致的压力测试。这是该频道第一次涉足图像生成领域,测试维度却铺得比不少老牌评测更开。下面把这场实测里真正有价值的信息拆开来看。
文本与数字:小词能过,数数不行
最基础的单词拼写测试,Qwen Image 2.1全部字母正确,短词组也能正确组合。给一段简单指令让它输出数字,同样没出岔子。
真正露怯的是计数任务。UP主让模型"生成一个碗,里面恰好装5个苹果",结果苹果数量根本没到5个,右侧下方还多出一些莫名其妙的线条。物体计数一直是扩散模型的传统弱项,这次测试没有例外。
另一个反复出现的现象是画面上的紫色印记,UP主形容它像打印痕迹,在多数生成图里都能看到。他猜测这可能来自训练数据,并在视频里向观众求助:如果其他人本地运行也遇到同样的紫色线条,希望能告诉他排查方向。
扩散模型(Diffusion Model)是当前图像生成的主流架构,其原理是从随机噪声出发、经多步去噪逐步还原出图像,而非像语言模型那样逐词预测。这一机制决定了模型对“整体像素分布”的建模能力强,对“离散数量”这类需要精确计数的约束则天然偏弱:训练目标并未显式奖励“数对物体个数”,模型只是模仿训练分布中“一碗苹果”的常见样子。因此当提示词要求恰好5个苹果时,模型倾向于生成视觉上合理的构图,而非严格执行计数。物体计数、重复结构(如辐条、栏杆)的一致性,至今仍是扩散模型公认的短板,常见缓解手段包括引入布局控制、分割掩码或专门的后处理校验。
“紫色印记”这类在大量生成图中反复出现的伪影(artifact),在扩散模型实践中并不罕见。它通常指向训练数据中的系统性偏差——例如某批图像带有水印、压缩色偏、特定采集设备的色彩特征,模型便会把这种颜色模式当作“图像应有的样子”学进去,在生成时无差别复现。排查方向一般包括:检查所用权重是否经过量化或合并(不同精度版本可能放大伪影)、确认VAE解码器是否与训练时一致、调整采样步数与CFG引导强度、更换调度器,以及用不同种子复现以排除个案。若多种配置下仍稳定出现,基本可判定为训练数据层面的残留,需等待官方权重更新或社区微调修复。
空间布局与人体结构:稳中有坑
颜色与位置指令完成得干净:桌上左边红色立方体、右边蓝色球体,没有多余元素。"合上的书上放一个杯子,书在旁边的桌子上"这类空间关系也答对了。在空旷场景中摆放物体的任务同样通过,模型没有硬塞进常规家具。
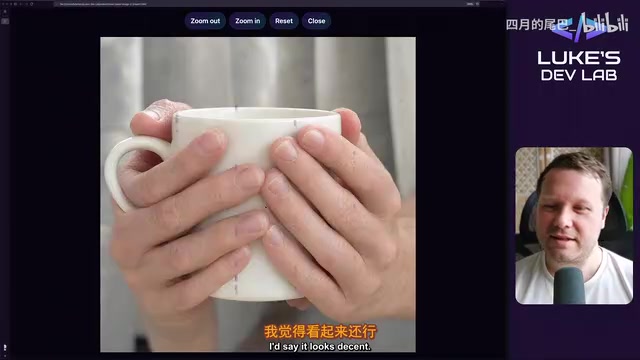
人体解剖则是另一回事。让模特摆出指定姿势时,结构完全错乱,UP主直言"太糟糕了"。手持杯子的测试里,右手食指弯曲角度不自然,好在没有出现经典的多指问题。
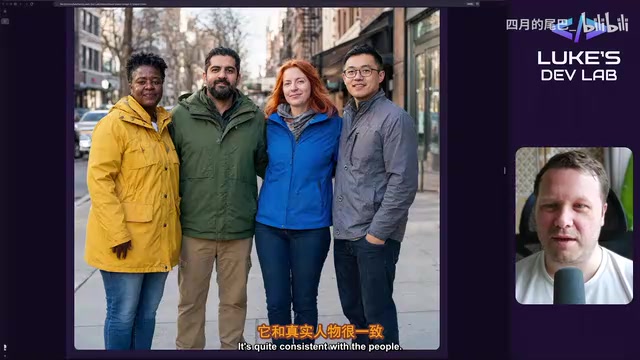
群像场景反而是亮点。多人物站位合理,不同种族的呈现也较自然,没有手部乱入或人物重叠。UP主检查了两遍,认为与真实人物一致性很高。动漫风格的人体表现明显优于写实风格,瑜伽姿势换成动漫风后就"看起来还挺准确"。
写实人体结构是图像生成中最难啃的部分之一,原因在于人类对自身姿态、关节角度和手部细节极为敏感,任何细微偏差都会被瞬间识别为“不对劲”。模型在训练中见到的手部图像往往被遮挡、角度单一,导致手指数量、弯曲方向和关节连接容易出错。动漫风格反而更“宽容”:其线条简化、比例夸张,本就偏离真实解剖,模型只需符合风格惯例即可,出错空间反而更小。这也是评测中常见“动漫优于写实”的原因——并非模型更懂动漫,而是写实任务对物理与解剖一致性的容错率极低,任何细微结构错误都会暴露。
风格、材质与几何:强项与短板都很清楚
动漫街道场景获得高度评价:雨中黄昏、黄雨衣骑车人、亮灯店铺,整体氛围到位。UP主分享了一个辨别AI图的技巧——放大看电线,AI画的电线常像蜘蛛网一样乱;另外人物眼神飘忽也是可疑信号。
油画日出、水墨悬崖、抛光金属、湿漉漉的霓虹小巷等材质与风格测试,多数完成度不错。但杯子装水这类需要物理一致性的场景翻了车:水量明显不对,水太多破坏了构图。
几何结构是明确的短板。自行车轮辐条测试中,线条逐渐螺旋分叉、越来越乱,UP主评价"处理得不太好,不太干净"。
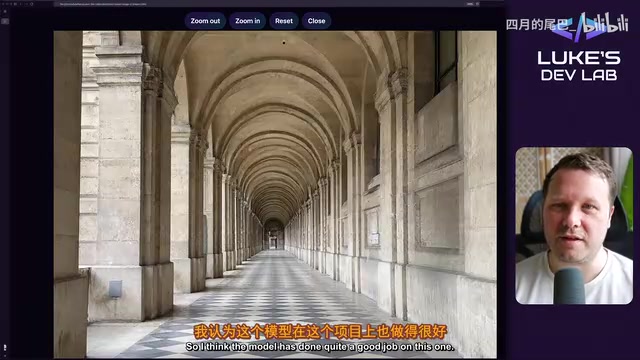
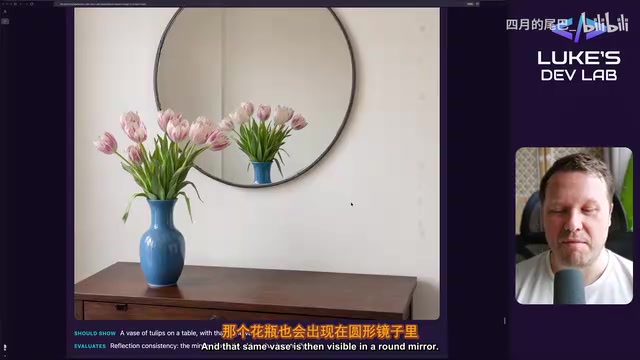
透视与重复结构(长廊拱门、方格地板)表现良好,元素对齐规整。镜子反射测试中,花瓶在镜中的位置让UP主觉得"有点不对劲",但整体反射效果他认为做得不错。
场景叙事:前景稳,背景糙
食物细节(拉面加蛋加葱花加蒸汽、不出现手)达标。热闹市场场景的前景人物和摊位不错,但背景模糊处出现了"像没头的人"的粗糙结构。两人咖啡馆倒茶场景,手部有奇怪线条,液体也没流到该去的地方。网球发球姿势被质疑不符合真实运动力学。模拟指针时钟则干净准确,小时数正确、无多余指针。
视频最后,UP主确认模型可以生成无审查内容。他也说明后续会把测试图集放到DevLab图库,方便与其他图像模型横向对比,并强调频道主线仍是Hugging Face文本生成模型,图像和视频只是补充。
这轮实测说明了什么
32项测试勾勒出的Qwen Image 2.1画像相当清晰:文本渲染和空间布局可靠,动漫风格与材质表现超出预期,计数、精细几何和写实人体结构是明显软肋,紫色印记这类疑似训练数据残留需要社区共同排查。对于想在本地部署图像生成能力的开发者,这份实测提供了少见的细粒度参考——尤其是它把"能做什么"和"会在哪里翻车"放在了同一张清单上。
相关推荐

Claude Code 新手避坑指南:桌面版上手与6个关键设置
Claude Code 桌面版上手教程:讲解付费门槛、Opus 规划与 Sonnet 施工的模型分工、工作区文件夹选择、审批规则、claude.md 常驻规则、compact 会话压缩等新手最易踩坑的六个设置,并附四个实战项目演示。
Anthropic安全限制引众怒:开发者逆向电视被拒,社区分享绕行技巧
Anthropic安全限制阻止用户逆向工程电视,引发Reddit社区热议。开发者分享绕过技巧,讨论AI安全与开源的博弈,以及用户转向中国模型的趋势。

Reddit 神帖:想快乐活过此生,必须避开的几个陷阱
Reddit 热帖引发对快乐生活的集体思考:社区共识指出需避开社交媒体比较、消耗型关系与消费主义陷阱,同时呈现职业选择与经济安全的分歧。本文提炼讨论精华,并延伸至科技从业者的避坑启示。