Qwen3.8 27B 本地实测:性能碾压旗舰,配置才是关键
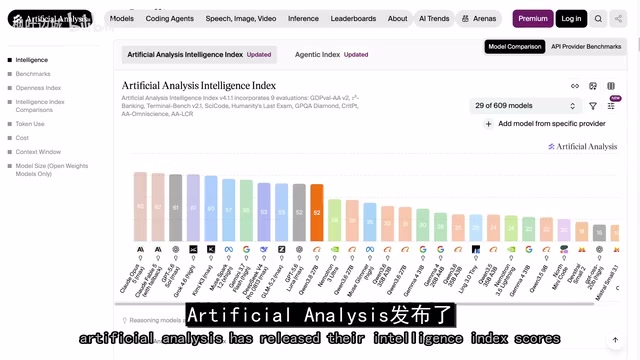
Qwen3.8 27B 是当前最强可本地运行开源模型,但发挥其潜力的关键在于推理档位与推理框架的正确配置。
Qwen3.8 27B 在 Artificial Analysis intelligence index 上以 52 分紧追 GLM 5.2 和 DeepSeek V4 Pro,在 agentic 任务上甚至超越部分旗舰模型,是一个真正能在消费级和准专业级硬件上运行的开源标杆。然而,模型的实际体验高度依赖三个变量:版本选择(BFloat16、FP8、NVFP4 量化各有适用场景,消融去审查版因重复解码问题暂不推荐)、推理档位设置(medium 是性价比最优的"甜点"档,X-high 会烧掉上万思考 token 且频繁超出上下文窗口),以及推理框架(SGLang 配合官方 NVFP4 权重与 D-Spark 投机解码可达约 200 tokens/秒,显著优于 vLLM 的 120 tokens/秒)。博主的核心结论是:只要能正确配置这三个维度,Qwen3.8 27B 就是当前本地 AI 领域需要被击败的那个模型。
上周 Qwen 放出了 Qwen3.8 Max 的权重,这个 2.4 万亿参数的庞然大物能力惊人,但绝大多数人根本无法在本地运行。真正让社区翘首以盼的,是周五发布的 Qwen3.8 27B——一个真正能在消费级和准专业级硬件上跑起来的开源模型。海外博主在实测后给出的结论相当直接:如果你能把它服务起来,这就是当前本地 AI 的标杆模型。
本文基于该博主的完整实测,重点不在于罗列跑分,而在于回答两个更实际的问题:你应该选哪个版本的模型,以及应该怎么配置才能让它真正跑好。
跑分:小模型打出了旗舰级成绩
从 Qwen 官方给出的基准来看,3.8 27B 相比此前广受本地开发者喜爱的 3.6 27B 在几乎所有维度都有实质性提升,是一个可以无痛替换的升级版。更值得关注的是视觉性能——在 computer use、浏览器操作这类任务上,它甚至超过了 Opus 4.6 Max(公平地说,早期 Opus 模型对这类场景的优化本就不如新版本)。
博主还提到,Meta 此前赶工发布的 Muse Glimmer 30B 在很多例子里都是拿 3.6 27B 来对标的。他当时就判断 Meta 是在赶在 3.8 27B 发布前抢跑,如今看来基本属实——3.8 27B 在跑分上已明显超越 Muse Glimmer。不过他也提醒,Muse Glimmer 在泛化能力上训练更充分,不能仅凭跑分否定它,仍值得针对具体场景测试。
真正让人意外的是第三方评测。Artificial Analysis 的 intelligence index 给这个 27B 模型打出了 52 分,紧追 GLM 5.2(53 分)和 DeepSeek V4 Pro,把 3.6 27B 以及几乎所有你有机会本地运行的开源模型远远甩在身后。在 agentic index 上,它甚至击败了 GLM 5.2 和部分 GPT 5.6 模型。对于一个能在本地跑出可观速度的模型来说,这个成绩相当夸张。
版本迷宫:量化、微调与去审查
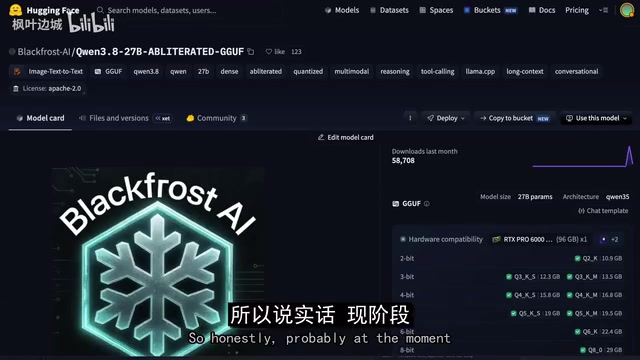
在 Hugging Face 上,27B 已经衍生出一大堆版本。官方提供 BFloat16 全精度版和 FP8 版;Unsloth 已经放出了使用 NVFP4 量化的 4-bit 版本(要注意并非所有 GPU 都能跑这种量化)。
除此之外还有大量社区微调:有人用不同数据集训练以获得新能力,也有人做出了去审查版本。去审查的路径分两种——一种通过微调实现,另一种通过 obliteration(消融)实现,Black Frost AI 团队是最早尝试的团队之一,此后又出现了多个消融版本。
对 Mac 用户,MLX 社区也已经发布了多个版本,涵盖 BFloat16、8-bit、4-bit 以及各种量化方案的 MLX 移植。
博主实测后对消融版给出了保留意见:这些版本虽然有趣、确实放开了一些限制,但容易在思考阶段陷入重复解码的死循环,卡在循环里出不来。所以目前阶段,他不建议使用消融版。
量化(Quantization)是将模型权重从高精度浮点数压缩为低精度表示的技术,核心目标是降低显存占用与计算开销。BFloat16 是 16 位脑浮点格式,保留了 float32 的动态范围但减半了存储;FP8 进一步压缩到 8 位,在 Hopper 与 Blackwell 架构 GPU 上有硬件加速支持;NVFP4 则是 NVIDIA 专有的 4 位量化格式,仅在 Blackwell(RTX 50 系列、H100 后继)等特定 GPU 上才有原生指令支持,这也是文中特别提醒"并非所有 GPU 都能跑这种量化"的原因。
消融(Obliteration)与微调去审查在机制上截然不同:微调去审查是用新数据集继续训练,引导模型忽略安全拒绝规则;消融则是直接在权重空间中定位并"抹除"与拒绝行为相关的方向向量,无需额外训练。消融操作激进且不可逆,容易破坏模型内部的注意力一致性,这正是消融版在思考阶段容易陷入重复解码死循环的根本原因。
决定成败的关键:推理档位设置
这是整篇实测最核心的洞察——模型好不好用,很大程度上不取决于量化,而取决于你怎么设置推理(reasoning)档位。
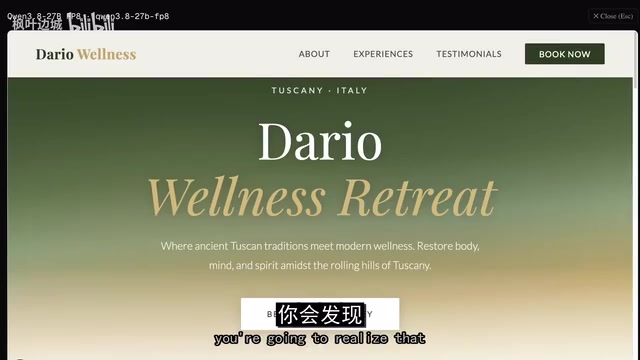
博主用经典的 HTML 网页生成测试和 Simon Willison 的「画一只鹈鹕 SVG」测试跑了不同档位:
- 关闭思考(no thinking):直接进入生成,网页结果其实相当不错,有时甚至比开思考的版本更讨喜。
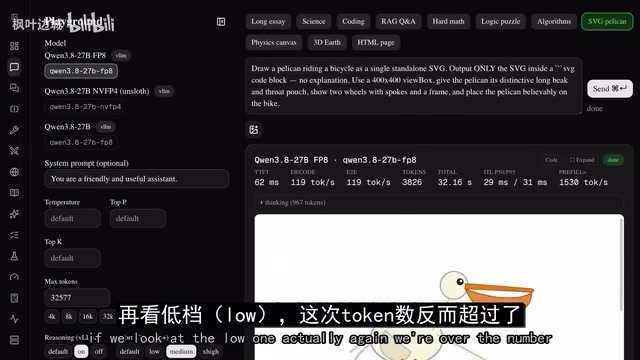
- 低思考(low):约 512 个思考 token,效果不错,但开始丢失一些细节。
- 中思考(medium):有趣的是,在某些任务上它消耗的 token 反而比 low 更少,效果与 low 接近。
- X-high(超高):模型直接「发疯」。他把最大输出限制在 32k token,结果光思考就烧掉 17,500 甚至高达 22,000 个 token,网页经常还没生成完就超了上限。
在鹈鹕 SVG 测试里,X-high 用掉 11,000 token 思考,而 medium 只需不到 1,000 token 就能画出相当好的鹈鹕。他把题目换成「红龙骑自行车」来检验是否过拟合,发现无思考时自行车画得对但龙很幼稚,medium 在龙上甚至有点退步,X-high 用了 35,000 token(其中 21,000 是思考)才勉强画出还算能看的龙。
他的结论是:medium 是甜点档位。X-high 确实能带来更好结果,但 token 消耗大到离谱,你必须同时准备好超大的上下文窗口和漫长的等待时间。
Qwen3 系列引入了可控的"混合思考"机制:用户可以通过系统提示或 API 参数指定思考预算(thinking budget),以 token 数量为单位约束模型在正式输出前花费多少"内心独白"。这与 OpenAI o 系列或 DeepSeek R1 的做法类似,但 Qwen3 将档位暴露得更加显式——从 no thinking(0 token)、low(~512 token)、medium,一直到 X-high,形成连续的能力-成本权衡曲线。思考 token 本身会消耗上下文窗口空间,也直接决定推理延迟;当思考 token 占满上下文窗口时,模型甚至没有足够空间输出最终答案,这就是 X-high 档位下"光思考就烧掉上万 token、网页还没生成完就超限"的直接原因。选择合适的思考档位,本质上是在"解题深度"与"实际可用性"之间找到平衡点。
版本与推理引擎实测:速度对比
博主的测试平台是 Dell Pro Max(赞助算力),核心是一块 NVIDIA RTX Pro 6000,拥有 96GB 显存,因此加载全精度模型毫无压力——这显然是一种奢侈,多数人无法加载完整的 16-bit BFloat 版本。
他跑了五个版本,主要基于 vLLM:
- BFloat16 原版:约 30 tokens/秒(未开投机解码)。开启 speculative decoding 并设置 MTP=3(多 token 预测)后有明显提速。
- 官方 FP8 版:配合内置 MTP 投机解码,约 120 tokens/秒,质量与 16-bit 相比几乎无差异。vLLM 可自动处理这套配置。
- 消融版:容易陷入重复思考循环,暂不推荐。
- Unsloth 版:量化质量很好,配合 MTP 同样能到约 120 tokens/秒。
真正的赢家出现在最后——SGLang。它对 Blackwell GPU 做了深度优化,博主用其官方 NVFP4 权重、配合 D-Spark 投机解码,在 Docker 容器中把无关负载全部剥离后,跑出了平均约 173 tokens/秒的成绩,短任务甚至能逼近 200 tokens/秒,同时完整加载 262k 上下文窗口运行流畅。SGLang 官方 X 账号宣称最高可达 206 tokens/秒。他也提到,用 SGLang 配 Unsloth 量化效果不如用官方权重。
投机解码(Speculative Decoding)是一种通过"草稿-验证"两阶段加速自回归生成的技术:先用一个轻量草稿模型快速预测若干候选 token,再由主模型并行验证,若验证通过则一次性接受多个 token,从而减少主模型的序列化调用次数。文中提到的 MTP(Multi-Token Prediction,多 token 预测)是 Qwen3 内置的一种投机解码变体,利用模型自身的多头输出同时预测后续多个位置,无需额外草稿模型即可获得加速。D-Spark 则是 SGLang 针对 Blackwell GPU 实现的深度融合投机解码优化,结合 NVFP4 量化与 CUDA kernel 融合,最终实现了约 173–200 tokens/秒的吞吐——这一数字在本地运行 270 亿参数模型的背景下已属罕见。vLLM 与 SGLang 都是主流开源 LLM 推理框架,前者生态更成熟、兼容性更广,后者在新架构 GPU 上的极限性能优化更激进。
实用建议与展望
博主给出的操作路径很清晰:先针对你的具体用例测试不同模型版本,选定后再调推理 token 档位,最后还要选对推理框架。在他的最终配置里 SGLang 胜出;但如果你的 GPU 显存较低,建议试试 llama.cpp。他甚至建议把这些配置文档直接丢给你的编程 agent,让它帮你测出最佳组合。
对未来,他期待几个方向:会不会出现类似 ThinkingCap 的微调版本,用更少 token 达到同等智能?会不会有进一步提升智能的微调?会不会有 fused kernel 之类的效率优化,把服务速度推得更高?
结论是明确的:Qwen3.8 27B 在开源权重和本地 AI 两个维度上都迈出了一大步,让准专业级硬件也能跑起接近旗舰的能力。只要你能把它服务起来,这就是当前本地 AI 需要被击败的那个模型。
相关推荐
Claude Code与Codex企业级实战:AI工程化编程如何搞定复杂项目
从氛围编程到AI工程化编程,本文解析Claude Code与Codex企业级项目实战:三种开发模式递进、国产大模型选型、SuperPower插件流程,以及Open Router聚合平台背后的AI行业盈利逻辑。
开源桌面端CC-HAHA上手:让AI自动操作你的电脑
开源桌面客户端 CC-HAHA 新增 computer use 电脑操控功能,让 AI 通过虚拟鼠标自动操作电脑。本文详解三步配置流程、实际效果演示,并分析不同模型在操作电脑能力上的差异与局限。
Claude Code桌面版实操:中文汉化+免登录+接入DeepSeek全攻略
手把手教你安装 Claude Code 桌面版,实现免账号使用、中文汉化,并通过 CC Switch 接入国产模型 DeepSeek,还包含自定义 Skill 导入的完整实操步骤,帮你低成本跑通 Claude Code 工作流。