Qwen3.8-Max实测:4道变态题全过,耗时近3小时
Qwen3.8-Max四道极限题全过,能力上限高但耗时近三小时暴露效率短板。
B站博主在「签问办公」平台对Qwen3.8-Max进行四道极限实测:强约束写作字数递增全对、夜景摩天轮仅一处遮挡穿帮、复古掌机俄罗斯方块逻辑正常、3D赛车完整可玩且弯道可救车。四题全过证明其中文写作、3D场景和游戏逻辑三条线均有能打的能力,但整个过程耗时接近三小时。文章认为,这代旗舰总参950B、激活上下文极长,为复杂任务提供了底座,但推理与生成链路过长,导致效率成为明显短板。结论是:Qwen3.8-Max能啃硬骨头但啃得慢,适合愿意等待的复杂任务,即时反馈场景仍需优化。
AI大模型的评测从来都不缺跑分,真正能拉开差距的,是那些看起来「不讲道理」的极限任务。B站博主在「签问办公」平台上对 Qwen3.8-Max 进行了一轮实测,四道题目从汉字结构约束一路打到3D物理引擎,最终全部通过,但整个测试烧掉了接近三个小时。这代旗舰的实际水平,值得仔细拆解。
四道题,从文字到3D的极限拉扯
第一题:强约束写作,字数的「俄罗斯套娃」
题目要求写十句话,第一句三个字,第二句四个字,依此类推,到第十句刚好十二个字。这种题目放在人类写手面前都要反复数格子,模型不仅要保证字数递增全对,还得让整段文字读起来像话。
实测结果是结构和格式都稳,字数递增一次没崩。这说明模型在长程约束下的计数能力已经相当扎实——要知道,很多大模型在写到第三四句时就开始「数错数」了。
强约束写作与长程约束下的计数能力
强约束写作指的是在生成文本时,除了语义连贯之外,还必须满足一系列硬性格式条件,例如字数、句数、韵律、特定字符出现频率等。这类任务在大模型评测中常被用作「压力测试」,因为自回归模型逐 token 生成,一旦在中间某一步数错字数或漏掉约束,误差会向后累积,最终整体崩盘。
其中「长程约束下的计数能力」尤其关键。模型需要在整个生成过程中持续维护一个内部计数器,并让后续每一句的字数都严格遵循递增或递减规律。很多模型在短文本上表现正常,但一旦约束链拉长到七八步以上,就会出现「数错数」、句子长度跳变或语义为了凑字数而崩坏。这次测试中字数递增一次没崩,说明模型在规划阶段对全局约束有较强的保持能力。
第二题:夜景摩天轮,只穿帮了一处
第二题要求生成一幅城市夜景,包含摩天轮、被轮幅挡住的月亮,以及完整的城市灯光层次。这类复合场景最考验模型对空间遮挡关系的理解。
博主给出的评价是:摩天轮结构清晰,轿厢和齿轮联动都对,城市夜景一层不少。唯一的瑕疵是月亮被轮幅遮挡的位置出现了一处穿帮。放在整体完成度里看,这属于「小瑕疵」级别,不影响画面成立。
空间遮挡关系与生成式图像的空间一致性
空间遮挡关系是图像生成中判断模型是否真正「理解」三维场景的重要指标。所谓遮挡,是指前景物体挡住背景物体的一部分,被挡住的区域不应再出现背景物体的纹理或轮廓。在摩天轮与被轮幅挡住的月亮这一组合中,模型需要同时处理摩天轮的轮幅结构、月亮的圆形轮廓,以及两者前后层级。
生成式模型通常在训练中通过大量图像隐式学习遮挡规律,但在复杂复合场景里仍可能出现「穿帮」——比如月亮的部分圆面错误地浮现在轮幅前方,或者轮幅与月亮的交界处出现纹理断裂。一处小穿帮在整体完成度较高时通常可接受,但也说明模型的空间推理仍依赖统计先验,而非严格的几何计算。
逻辑与工程能力的双重施压
第三题:复古掌机跑俄罗斯方块
第三题是一台复古掌机外壳里运行俄罗斯方块,考的是逻辑严谨性、UI审美、动画状态机,以及Game Boy风格的外壳、按键、屏幕配色是否到位。
模型交出的答卷是:方块下落、堆叠、消行的逻辑正常,跑起来没报错、没穿膜。UI和动画状态机都撑住了,外壳按键屏幕配色全部还原。这已经不是在「画一张图」,而是在一个可交互的框架里维持状态一致性。
动画状态机与交互逻辑的一致性
动画状态机是游戏和交互式界面中用来管理「当前处于什么状态、下一步切换到什么状态」的机制。以俄罗斯方块为例,方块有下落、左右移动、旋转、锁定、消行等多个状态,每个状态对应不同的动画和逻辑分支。模型要在一个复古掌机外壳里呈现俄罗斯方块,不仅要画出静态 UI,还要保证状态之间的切换不冲突、不穿膜、不报错。
这比单纯生成一张图片难得多,因为生成结果需要在一段时间内维持内部状态一致:方块堆叠高度变了,消行逻辑要跟着触发;外壳按键和屏幕配色要始终统一。能跑起来且逻辑正常,说明模型对交互框架的建模能力已经超出了静态图像生成的范畴。
第四题:3D赛车,物理手感是最大考验
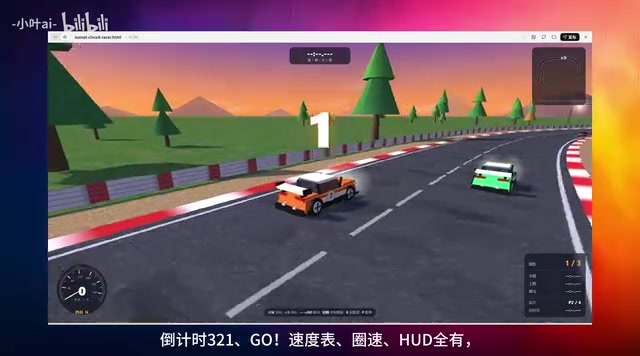
压轴题是3D赛车场景「Sunset Circuit」,直接考验智能体的3D工程能力和物理手感调教。题目要求包括倒计时3、2、1、Go,速度表、圈速、HUD全部到位,还要有多车同场。
实测中,模型不仅做出了完整可玩的赛道,弯道打滑后还能自己救回来——说明物理反馈不是摆设。博主明确说「不是空壳电梦」,完成度达到了可玩标准。
物理手感调教与弯道救车
物理手感调教指的是在游戏或模拟环境中,让物体的运动反馈符合玩家直觉:加速有推背感、刹车有惯性、转弯有侧滑,且这些反馈的参数需要反复调整才能自然。3D赛车场景里,弯道打滑后能否自行救回,是判断物理系统是否「活」的关键。
如果物理反馈只是摆设,车辆打滑后通常会直接失控旋转或滑出赛道,无法通过反向打方向、松油门等操作恢复抓地力。模型能做出「打滑后自己救回来」的效果,说明它在生成赛道和车辆行为时,隐含地建立了一套可响应的动力学规则,而不是只渲染了一组固定动画。这也让「Sunset Circuit」从视觉演示升级为可玩原型。
全过背后:3小时的成本与真实水平
四道题全过,这个结果本身已经说明 Qwen3.8-Max 在中文写作、3D场景和游戏逻辑三条线上都有能打的能力。但博主也点出了一个关键信息:整个过程花了接近三个小时。
这个时间成本值得玩味。一方面,它说明模型在处理高复杂度、多约束任务时,推理和生成的链路很长;另一方面,也意味着在效率层面,距离「随手可用」还有优化空间。
从参数规模看,这代旗舰猫总参950B、激活上下文拉到极长文本,确实为复杂任务提供了底座支撑。四道题的通过率验证了能力上限,三小时的耗时则暴露了速度短板。
Qwen3.8-Max 到底是什么水平?从这次实测看,它属于「能啃硬骨头,但啃得慢」的类型。中文写作、3D建模、游戏逻辑都能打,短板不在能力而在效率。对于愿意等待的复杂任务,它已经能交出可用结果;对于追求即时反馈的场景,还需要再等等。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。