Qwen3-Max登陆Venice:匿名AI问答的隐私新选择

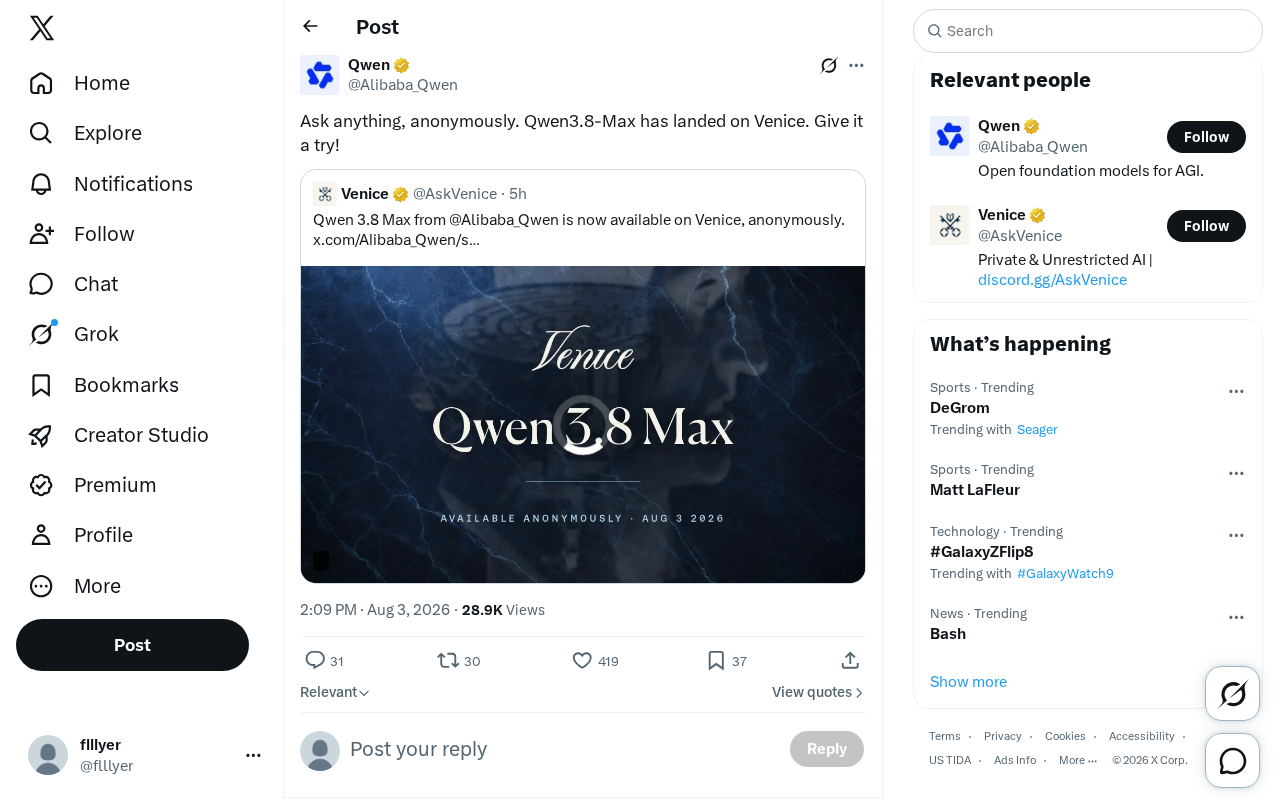
Qwen3-Max入驻Venice平台
近日,Venice平台宣布正式集成阿里巴巴通义千问广告团队推出的Qwen3-Max模型,为用户带来"匿名提问、随心探索"的AI交互体验。这一整合意味着用户无需注册账号或暴露个人身份信息,即可直接调用当前业界领先的大语言模型能力。
对于日益关注隐私保护的AI用户群体而言,Venice与Qwen3-Max的结合提供了一种全新的使用范式:既能享受旗舰模型的推理能力,又能在无追踪、无数据留存的环境中自由提问。这种"隐私优先"的产品定位,正在成为差异化AI服务的重要竞争力。
Venice平台是什么?
Venice是一个主打隐私与去中心化理念的AI应用平台。与主流商业AI服务不同,Venice强调不存储用户对话记录、不进行身份绑定,用户可以完全匿名地访问平台上的各类大模型。这种设计理念吸引了大量对数据主权和隐私安全有较高要求的用户。
Venice所倡导的去中心化AI服务理念,根植于Web3和加密隐私社区的核心价值观。传统AI服务(如ChatGPT、Claude等)通常要求用户注册账号、绑定邮箱或手机号,并在服务器端保留完整的对话日志用于模型改进和合规审计。而Venice采用的技术路径包括端到端加密通信、服务器端零日志策略以及可能的去中心化推理节点架构。这种设计哲学与Tor网络、Signal通讯协议等隐私工具的理念一脉相承——即服务提供者本身也无法获取用户的交互内容。在当前全球数据保护法规(如欧盟GDPR、加州CCPA)日趋严格的背景下,这类"隐私by design"的平台架构正获得越来越多技术精英和企业用户的青睐。
此次引入Qwen3-Max,是Venice丰富其模型生态的关键一步。通过接入来自不同厂商的高性能模型,Venice让用户能够在同一平台上灵活切换、对比不同模型的表现,而无需为每个AI服务单独注册账号。
Qwen3-Max的技术定位与核心优势
Qwen(通义千问)系列是阿里巴巴推出的开源与商用大模型家族,凭借在中文理解、多语言处理、代码生成以及复杂推理等方面的出色表现,在全球开源模型排行榜上长期位列前茅。
Qwen3-Max作为该系列的旗舰级模型,代表了通义千问在参数规模与能力上限上的最新探索。从技术演进角度来看,Qwen3属于通义千问第三代模型家族,相较于Qwen2系列在架构设计上有多项重要升级。Qwen3系列可能采用了混合专家(Mixture of Experts, MoE)架构,这种架构允许模型在拥有极大总参数量的同时,每次推理只激活部分专家网络,从而在性能与计算效率之间取得平衡。在训练数据方面,Qwen3系列据称使用了超过30万亿token的多语言语料,覆盖119种语言,这使其在跨语言任务上表现尤为突出。此外,Qwen3引入了"思考模式"(thinking mode),允许模型在回答前进行内部推理链展开,这一机制类似于OpenAI o1系列的Chain-of-Thought推理方式,能够显著提升数学、编程和复杂逻辑任务的准确率。
相较于中小型号,Max版本在以下几个维度上有显著优势:
- 长文本处理:能够理解和生成更长篇幅的内容,支持超长上下文窗口
- 多步推理:在复杂逻辑链条上的准确率更高,得益于思考模式的深度推理能力
- 知识密度:覆盖更广泛的专业领域知识,受益于海量多语言训练数据
这些特性使Qwen3-Max更适合处理复杂的专业问答、深度内容创作和数据分析任务。
开源生态带来的价值
Qwen系列的一大特色在于其开放策略。大量模型权重以开源形式发布,使得开发者和第三方平台能够便捷地进行集成、微调和部署。具体而言,Qwen系列采用Apache 2.0许可证发布其开源模型权重,这是当前最为宽松的开源许可之一,允许商业使用、修改和再分发而无需开源衍生作品。这与Meta的Llama系列(采用自定义的Llama Community License)、Mistral的部分模型形成了开源大模型的第一梯队竞争格局。
开源策略的商业逻辑在于:通过开放基础模型建立开发者生态,吸引企业用户在此基础上进行私有化部署和定制微调,进而为云计算平台(如阿里云)带来算力消费收入。这种"开源模型+云服务"的商业模式已被证明是AI基础设施竞争中的有效策略。正是这种开放性,让Venice这类隐私AI平台能够快速接入Qwen的能力,形成互利共赢的生态格局。
对整个AI行业而言,头部开源模型登陆各类第三方平台,正在加速优质AI能力的普及。用户不再局限于单一厂商的官方入口,而是能够通过多样化的渠道体验同一模型——这既降低了使用门槛,也在客观上推动了行业竞争与创新。
匿名AI问答的意义与深层思考
"匿名提问"这一特性值得深入探讨。在传统AI服务中,用户的每一次对话往往都会被记录和分析,用于模型训练或商业化用途。而Venice提供的匿名访问模式,让用户可以放心地探讨敏感话题、进行私密咨询,不必担心数据泄露或身份追踪。
实现真正的匿名AI服务在技术上面临多重挑战。首先是身份隔离——平台需要确保即使在网络层面也无法将请求关联到特定用户,这可能需要支持Tor网络接入或VPN友好的访问策略。其次是推理过程中的数据保护——模型推理时输入的prompt是否会被缓存、是否会进入训练数据管道,这些都需要通过架构设计来保证。更前沿的方案包括使用可信执行环境(TEE,如Intel SGX或AMD SEV)进行推理计算,确保即使是平台运营者也无法窥探用户输入。还有同态加密推理等研究方向,虽然目前因性能开销过大尚未商用化,但代表了隐私AI的终极技术愿景。Venice的具体技术实现细节尚未完全公开,用户在评估其隐私承诺时应关注其是否经过第三方安全审计。
这对于以下场景尤其有价值:
- 涉及个人健康、法律等隐私话题的咨询
- 企业内部的保密性技术问题探讨
- 不希望留下数字痕迹的日常提问
不过,隐私优先的模式也伴随着一定的权衡。匿名环境下,平台难以根据历史对话提供个性化服务;同时,如何在保护用户隐私的前提下有效防止滥用,也是这类平台需要持续应对的挑战。
不同用户该如何选择?
对于普通用户,是否选择Venice+Qwen3-Max这样的组合,可以从以下维度考量:
- 重视隐私保护:如果你在意对话数据不被存储和追踪,匿名AI平台是理想选择
- 追求模型性能:Qwen3-Max作为旗舰模型,能够胜任绝大多数复杂任务
- 需要个性化体验:如果你希望AI记住偏好和对话历史,带账号体系的官方服务可能更合适
简单来说,Venice适合那些"用完即走、不留痕迹"的使用场景,而官方渠道则更适合需要持续交互和个性化定制的深度用户。
AI服务分发渠道的多元化趋势
Qwen3-Max进入Venice代表了AI模型分发格局的重要变化。传统上,大模型主要通过官方API(如阿里云DashScope)和官方应用(如通义App)提供服务。但随着开源模型生态的成熟,第三方分发渠道正在快速崛起,包括:聚合平台(如OpenRouter,提供统一API接口访问多家模型)、隐私平台(如Venice)、本地部署工具(如Ollama、LM Studio)以及各类垂直行业应用。
这种多渠道分发模式类似于Android应用生态——开发者可以选择Google Play、第三方应用商店或直接APK分发。对用户而言,这意味着更多的选择自由;对模型厂商而言,这扩大了模型的覆盖面和影响力;对整个行业而言,这降低了任何单一平台形成垄断的可能性。
总结:隐私与性能兼得的AI新范式
Qwen3-Max登陆Venice,是开源大模型与隐私优先平台深度结合的一个典型案例。它既展现了通义千问系列在模型能力上的持续进化,也反映出市场对数据隐私日益增长的关注。
随着越来越多的高性能模型进入多样化的分发渠道,AI服务正朝着更开放、更以用户为中心的方向演进。对于希望在保护隐私的同时体验前沿AI能力的用户来说,Venice+Qwen3-Max这样的组合无疑值得一试。
注:本文基于官方公告信息整理,具体功能与模型表现建议以实际使用体验为准。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。