Qwen4 百万上下文窗口曝光:27B与Max版本即将登场
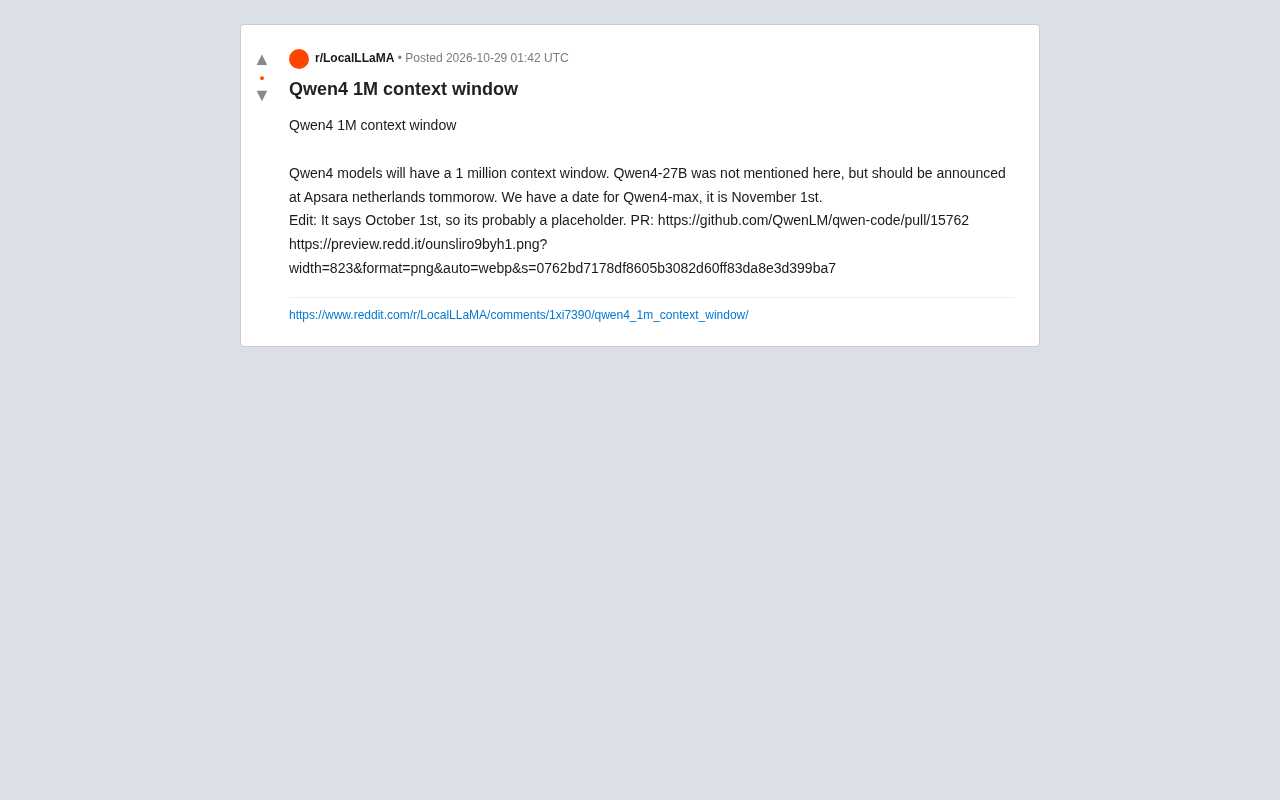
爆料称 Qwen4 全系支持 1M 上下文,27B 与 Max 版本即将发布。
文章基于 Reddit 社区爆料,称阿里通义千问下一代模型 Qwen4 将全系支持 1M token 上下文窗口,信息来源为一个 qwen-code 仓库的 GitHub PR 及泄露截图。爆料提到 Qwen4-27B 可能在荷兰 Apsara 大会公布,Qwen4-max 的日期先显示 11 月 1 日、后更正为 10 月 1 日,爆料者判断为占位符。文章分析了百万上下文的行业意义:长上下文正从炫技走向实用,可能改变 RAG 的分块设计思路,但同时带来推理成本、延迟与长上下文性能衰减等未知数。27B 尺寸对单卡部署和开源社区友好。所有信息均未经官方确认,需等待正式公告。
Qwen4 百万上下文窗口曝光:27B与Max版本即将登场
据 Reddit 社区爆料,阿里通义千问广告团队下一代模型 Qwen4 将具备 1M(百万)token 的上下文窗口。这一消息来自一个 GitHub PR(QwenLM/qwen-code#15762),其中包含了相关配置信息,同时还有一张泄露的截图作为佐证。
Qwen4 核心信息:1M 上下文与版本规划
根据帖子内容,Qwen4 系列将全系支持 1M 上下文窗口。这意味着模型可以一次性处理超长文档、大型代码库或长篇对话历史,在长文本理解与生成任务上迈出一大步。
帖子还透露了具体的版本发布节奏:
- Qwen4-27B:虽然未在 PR 中直接提及,但爆料者称该版本将在荷兰 Apsara 大会上公布(时间指向“明天”)。
- Qwen4-max:已有明确的日期信息,最初显示为 11 月 1 日,但编辑更新指出实际写的是 10 月 1 日,因此该日期很可能是占位符,最终发布时间待定。
原文摘录:Qwen4 models will have a 1 million context window. Qwen4-27B was not mentioned here, but should be announced at Apsara netherlands tommorow. We have a date for Qwen4-max, it is November 1st. Edit: It says October 1st, so its probably a placeholder.
百万上下文的行业意义
1M 上下文窗口并非首次出现——此前已有其他模型展示过类似能力,但 Qwen4 将其作为全系标配,意味着长上下文正在从“炫技”走向“实用”。对于开发者而言,这直接影响到 RAG(检索增强生成)的设计思路:当模型可以稳定处理百万级 token 时,许多场景不再需要复杂的检索分块,而是可以直接将整本书、整个项目仓库塞进提示词。
不过,上下文窗口的扩大也带来推理成本与延迟的挑战。1M token 的注意力计算量巨大,实际可用性取决于推理优化水平。目前爆料未提及 Qwen4 在长上下文下的性能衰减情况,这将是后续关注重点。
上下文窗口与注意力计算
上下文窗口(context window)指模型单次推理能够接受的最大 token 数量,它决定了模型“一次能看多少内容”。主流 Transformer 采用自注意力机制,每个 token 都要与序列中其他 token 计算相关性,标准实现的计算量与显存占用随序列长度呈平方级增长。因此从 32K 扩展到 1M,理论计算量可增长约千倍。业界通常借助 FlashAttention、稀疏注意力、滑动窗口、分块处理以及 KV Cache 压缩等技术来缓解这一问题,但这些优化往往会在超长序列上引入精度或召回上的折衷。这也是为什么“支持 1M”与“在 1M 下仍保持可用质量”是两个不同层面的问题。
RAG 与长上下文的关系
RAG(检索增强生成)的做法是先把文档切分成小块、建立向量索引,推理时只检索最相关的若干片段拼入提示词,从而绕开上下文长度限制并降低 token 成本。长上下文模型并不必然取代 RAG:当语料规模远超 1M token 时仍需检索;而在中等规模、强调整体关联的场景(如通读一份合同、理解整个代码仓库),直接把全文放入上下文可以避免分块造成的语义割裂和检索遗漏。实践中更常见的形态是二者结合——先用检索缩小范围,再让长上下文模型做深度整合。成本上,长上下文按输入 token 计费,海量无关内容进入提示词反而更贵,这也是设计时需权衡的因素。
版本命名与发布节奏的解读
Qwen4-max 的日期从 11 月 1 日变为 10 月 1 日,爆料者自己判断为“占位符”,说明官方尚未最终敲定。而 Qwen4-27B 选择在荷兰 Apsara 大会亮相,符合阿里云通过技术大会发布重要模型的惯例。27B 这个尺寸介于中小型与大型之间,适合单卡或少量 GPU 部署,对开源社区友好。
有意思的是,GitHub PR 本身是 qwen-code 仓库的变更,可能涉及代码模型的上下文配置,但被社区解读为 Qwen4 整体规格的线索。这种“从 PR 反推产品”的现象在开源社区并不罕见,信息真实性需要官方确认。
27B 参数规模的定位
27B 属于中等偏大的稠密模型规模,介于 7B—14B 的轻量级与 70B 以上的大型模型之间。以 FP16 精度计算,27B 权重约需 54GB 显存,量化到 4bit 后约 14—16GB,可在单张高显存消费级显卡或少量专业卡上运行,因此对本地部署和开源社区较为友好。这一尺寸通常被用来在能力与部署成本之间取得平衡:既能承担代码补全、文档问答等较复杂任务,又不至于像超大模型那样依赖多卡集群。若该版本以开放权重形式发布,将成为本地推理与微调的一个有吸引力的基线选择。
对开发者的影响与期待
如果 Qwen4 全系支持 1M 上下文,最直接受益的是代码助手、长文档问答和智能体(Agent)应用。代码仓库级理解、跨文件重构、长篇法律合同分析等任务将获得更好的基础能力。同时,27B 版本若开源,将给本地部署带来新的选择。
目前所有信息均来自社区爆料,建议关注官方渠道(阿里云、Qwen GitHub 仓库)的正式公告,以获取准确的发布计划和模型卡信息。
本文基于 Reddit 社区爆料整理,具体规格以官方发布为准。
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。