Qwen4-Max深度解析:阿里最强AI模型的能力边界
Qwen4-Max以2.4万亿参数稀疏MoE架构主打长上下文与Agent能力,强项突出但短板明显。
本文从技术架构、核心能力、基准测试和成本结构四个维度解析阿里旗舰模型Qwen4-Max。架构上,它总参数约2.4万亿但每token仅激活约710亿,依靠稀疏MoE与混合注意力在超长上下文中平衡容量与效率;能力上支持约100万token上下文、思考/标准双模式、文本图像视频多模态输入以及五阶段Agent工作流。基准测试显示其在Agent类任务上领先竞品,但终端编码与图表理解明显落后。API国际定价为输入每百万1.50美元、输出每百万4.50美元、缓存输入每百万0.075美元,且思考模式会推高输出成本。结论是文档分析与专业Agent场景值得优先考虑,编码、图表和视频任务需谨慎比较,生产决策应以自有负载实测为准。
Qwen4-Max深度解析:阿里最强AI模型的能力边界
阿里巴巴推出的Qwen4-Max被视为其旗舰级大语言模型,主打长上下文处理、复杂推理、多模态理解以及AI Agent工作流。一款模型是否真的“最强”,不能只看参数规模,更要看架构设计、实际表现与适用场景。本文基于公开的教程信息,从技术架构、核心能力、基准测试和成本结构四个维度,梳理Qwen4-Max的真实面貌。
稀疏MoE架构:2.4万亿参数如何高效运转
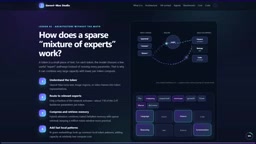
Qwen4-Max的整体架构包含约2.4万亿参数,但每个token仅激活约710亿参数。这一设计的关键在于稀疏混合专家(Sparse MoE)机制。
可以把MoE理解成一家拥有财务、法务、开发和调研专家的公司:每次遇到问题,不必让所有专家同时开会,而是由路由机制判断哪些专家与当前任务相关,只调用对应的“专家路径”。处理财务数据时激活金融相关路径,处理编程指令时激活另一组路径。这让模型拥有极大的总容量,同时避免每个token都跑完整网络的计算开销。
除MoE外,Qwen4-Max还采用了混合注意力机制,结合门控DeltaNet记忆与稀疏检索,并引入n-gram embeddings来识别局部token模式、增强表示能力。这些组件共同服务于一个目标:在超长上下文中高效管理信息。
混合专家(Mixture of Experts, MoE) 是一种将模型的前馈网络层拆分为多个并行的“专家”子网络的架构。每个token在推理时并不会经过所有专家,而是由一个轻量的路由网络(Router) 计算该token与各专家的匹配分数,仅选择得分最高的少数专家(通常为1至4个)参与计算,其余专家保持闲置。因此,MoE模型的总参数量可以远大于每个token实际激活的参数量,从而在保持计算成本可控的前提下显著扩展模型容量。MoE的核心挑战在于负载均衡:如果路由总是偏向少数专家,会导致这些专家过载而其他专家训练不足,常见解决方案是引入辅助损失函数来约束专家利用率。此外,MoE对显存的需求仍然由总参数量决定,部署时通常需要专家并行(Expert Parallelism)策略将不同专家分布到多张GPU上。
百万级上下文:白板更大,但仍需清晰指令
Qwen4-Max支持约100万token的上下文窗口。用教程中的比喻,上下文窗口像一块巨大的数字白板——白板越大,处理任务时能同时“摊开”的资料就越多。面对数百份PDF、技术报告、表格和会议记录,用户不必再频繁切分文档。
但大窗口不等于完美记忆。模型仍需要明确的指令:说明目标、指定待分析文档、交代约束条件、描述期望的输出格式。对于重要的研究任务,还应要求模型引用原文对应章节,以便核验结果。上下文再大,检索质量依然取决于提问质量。
上下文窗口(Context Window) 指模型在一次推理中能够同时接收和处理的最大token数量,涵盖用户指令、输入文档、对话历史以及模型已生成的输出。上下文窗口越大,模型在一次请求中可参考的信息越多,但同时也带来两个实际问题。其一是注意力计算成本:标准自注意力机制的计算量随序列长度呈二次方增长,百万级token的序列若使用全注意力将极为昂贵,因此长上下文模型普遍采用稀疏注意力、线性注意力或混合注意力来降低开销。其二是有效召回率:研究表明,模型对长上下文中部位置的信息召回能力往往弱于开头和结尾(即“迷失在中间”现象),窗口长度不等于模型能同等质量地利用其中每一段内容。这也是文中强调需要明确指令、指定文档并要求引用原文的技术原因。
思考模式与标准模式:按任务选择推理深度
Qwen4-Max提供两种实用模式。开启思考模式后,模型会在给出最终答案前投入额外的推理步骤,适合多步骤复杂任务,比如分析大型技术报告、审阅法律文档或协调Agent工作流。关闭思考则进入标准模式,响应更直接,适合信息抽取、数据分类、文本改写等高频简单请求。
需要留意成本:思考产生的token计入输出预算,开启思考会同时推高处理时间和API费用。教程建议在实际应用中两种模式都跑一遍再作取舍。
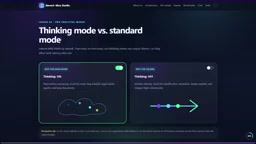
思考模式(Thinking / Reasoning Mode) 源自让模型在给出最终答案前先生成一段内部推理链的技术路线。与传统的直接输出不同,模型会先展开中间推理步骤——分解问题、列出假设、逐步演算——再基于这段推理生成结论。这类方法在数学、代码、多步骤逻辑和法律分析等任务上通常能显著提升准确率,因为显式推理降低了模型“跳步”出错的概率。代价是输出token数量大幅增加:一段最终只有几百token的答案,背后可能消耗数千token的推理过程,而这些推理token同样按输出计价。因此思考模式本质上是用成本换准确率的开关,是否开启应基于任务难度和错误代价来判断,而不是默认全开。
多模态与Agent工作流:能力边界在哪里
Qwen4-Max支持文本、图像和视频三类输入。文本侧可处理文档、合同、代码、转录稿和JSON等结构化信息;图像侧可分析截图、照片、图表和扫描件;视频侧能跨帧、跨场景分析时序信息。
Agent能力是另一个重点。与传统聊天机器人“一问一答”不同,Agent能理解目标、制定计划、调用外部工具、检查结果并迭代修改。教程将其拆为五个阶段:接收任务简报、拆解计划、调用工具、修订完善、交付成果。在金融、法律和研究场景中,这种工作流可以自动产出带引用的报告、表格和演示文稿。模型提供推理能力,外围Agent系统提供工具与执行环境,二者缺一不可。
AI Agent(智能体) 指以大语言模型为决策核心、能够自主规划并调用外部工具来完成多步骤任务的系统。与单轮问答的根本区别在于闭环执行:Agent不仅生成文本,还会调用搜索、代码执行、数据库查询、文件读写等工具,观察工具返回的结果,再据此调整下一步行动,直至任务完成。支撑这一过程的关键能力包括工具调用(Function Calling)——模型以结构化格式输出要调用的工具及参数;规划与分解——将高层目标拆成可执行的子任务;以及记忆管理——在多轮迭代中保留必要的中间状态。需要注意的是,模型本身只提供推理与决策能力,工具的执行环境、权限控制、错误重试和安全边界都由外围Agent框架负责,二者的工程质量共同决定最终效果。
基准测试:强项突出,短板同样明显
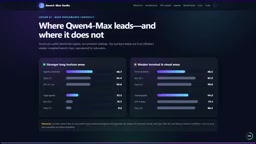
根据教程中厂商汇编的发布对比数据,Qwen4-Max在Agent类任务上表现突出:Agent Last Exam得分46.7,高于对比中的Opus 5.5和GPT 6.1 Sol;法律Agent任务得分21.3,对比Kimi K3.1的11.7和Opus 5.5的9.2。这印证了它在长流程Agent和文档密集型专业任务上的定位。
短板同样清晰。Terminal Bench得分48.5,低于Kimi K3.1和Opus 5.5的对比成绩;图表理解得分54.2,明显落后于GPT-6 Astra的71.1。教程也明确指出,Qwen4-Max在图表和视频理解上并未全面超越领先竞品。结论很直接:文档分析与专业Agent场景值得优先考虑,终端编码、复杂图表分析和视频理解则需谨慎评估竞品。
API定价:低价不等于低成本
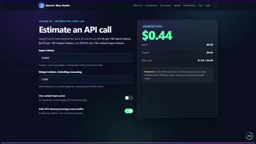
国际版API定价分三档:输入token每百万1.50美元,输出token每百万4.50美元,缓存输入token每百万0.075美元。输入涵盖指令、文档和对话历史;输出包含模型生成内容及思考模式下的推理token;缓存输入适用于可复用提示词的场景。
教程中的计算示例是25万输入token加1.2万输出token,计算器分别估算输入与输出成本后汇总,还可开启缓存计价和20%的规划缓冲。关键提醒是:token单价低不代表总成本低,重试次数、推理长度和总请求量都会影响最终账单。
选型建议
Qwen4-Max适合需要分析海量长文档、生成带引用的结构化报告、构建多工具Agent工作流以及产出表格和演示文稿的场景。若任务偏重shell编码、复杂图表分析或视频理解,或者应用要求开放模型权重与极低响应延迟,则应认真比较其他方案。任何基准分数都不能替代用自己的真实工作负载做测试——模型规格、API可用性和定价都可能变化,生产决策前务必核对最新信息。
相关推荐
AI替你写代码,还要学Git吗?五个理由
AI编程代理能自动处理Git操作,还有必要学Git吗?本文提炼五个理由:与团队沟通、审阅代理提交的PR、监督代码改动、在AI宕机时兜底,以及学习本身的乐趣,并分析代理时代Git学习重心的转移。

Anthropic据报以每股83美元定价IPO,估值达1.5万亿美元
Anthropic据报以每股83美元定价IPO,高于预期发行区间,完全稀释估值达1.5万亿美元。本文分析此次定价的信号意义及其对AI行业融资环境的影响。

纳德拉预言:AI代理将重塑网络经济规则
微软CEO纳德拉预测AI代理将重新洗牌网络经济,冲击广告驱动模式,并迫使亚马逊等平台重新思考客户争夺方式。本文解析代理经济对广告、电商与平台竞争逻辑的影响。