Qwen调查轨迹开源:开放权重模型如何自证清白

Qwen开源模型异常行为的调查轨迹与复现脚本,揭示预填充是触发关键。
文章围绕Qwen团队公开模型异常行为调查轨迹一事展开。事件源于开发者在本地运行Qwen3.8时发现“奇怪的链接”,该行为在常规提示下罕见,但配合预填充(prefilling)可稳定复现。团队不仅公布结论,还开源了原始token序列与最小复现脚本,使外部研究者能够独立验证并比较不同推理配置下的行为差异。文章指出,这体现了开放权重模型的可审计性优势:闭源模型出现类似异常时外部只能观察输入输出,而开放权重让受控实验成为可能。团队重申对开放路线与Apache 2.0许可证的支持,并强调评估安全性时需覆盖预填充等引导手段。对开发者而言,这些素材可用于排查自有环境的行为一致性,并逐步积累成社区共同维护的行为档案。
一次由社区发现的异常
据Reddit社区讨论,Qwen团队发布了关于模型异常行为的调查轨迹(investigation traces),并开源了原始token与最小复现脚本。起因是开发者在本地运行Qwen3.8时,发现了“奇怪的链接”(strange links)。这一现象并非在常规推理中稳定出现——团队表示,在不使用预填充(prefilling)的情况下该行为很少见,但通过特定提示词配合预填充可以复现。
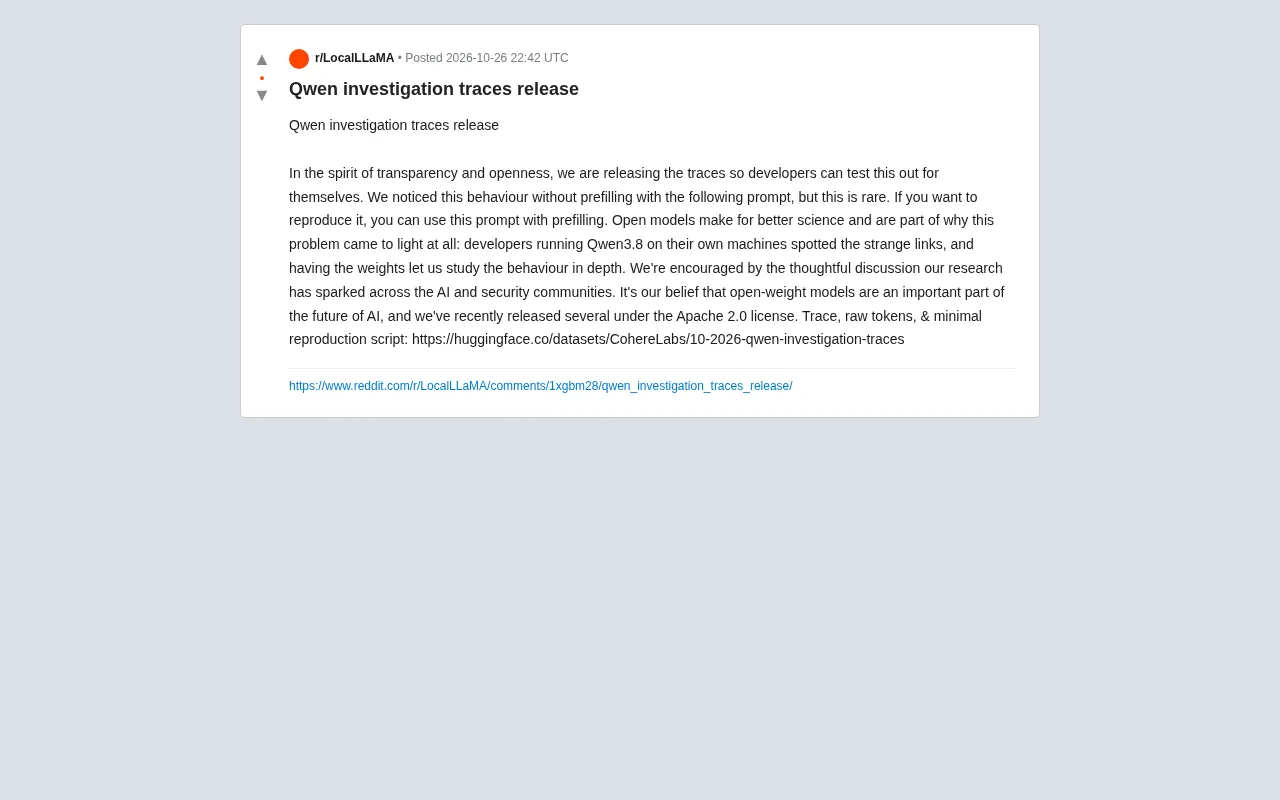
这一事件的特殊之处在于:问题最初不是由厂商内部红队发现,而是由在自己的机器上跑模型的开发者察觉。开放权重让异常暴露在更广泛的审视之下,也让后续的深度研究成为可能。
为什么要公开“轨迹”而不只是结论
发布调查轨迹(traces)意味着把模型在异常触发时的原始token序列、复现脚本一并交给社区。这比单纯发布一份“我们已修复”的声明更有价值:其他研究者可以独立验证、比较不同推理配置下的行为差异,甚至测试同类模型是否存在相似模式。
团队在声明中强调,开放模型“让科学变得更好”(open models make for better science),并直言正是开放权重让这个问题得以浮出水面。他们提到,近期已以Apache 2.0许可证发布了多个开放权重模型,将开放视为AI未来的重要组成部分。
从工程角度看,公开原始token而非仅公布摘要,降低了外部复现的门槛。安全研究长期受困于“无法复现厂商描述的现象”,而轨迹发布在形式上部分解决了这一痛点。
“调查轨迹”(investigation traces)借用了软件工程中 trace 的概念,通常指一段可回放的执行记录:完整的输入 token 序列、模型实际生成的 token、采样参数(temperature、top_p、seed 等)以及复现所需的最小代码。它与模型卡或事故报告的区别在于可执行性——读者不必相信文字描述,而是直接重跑脚本比对输出。在机械可解释性研究中,类似产物还包括注意力图、激活探针结果和稀疏自编码器特征;轨迹发布把这些内部证据与外部行为对齐,使“异常是否真实存在”“是否与特定配置绑定”这类问题可以被第三方独立裁决。
预填充:异常触发的关键变量
此次披露中最具技术含量的细节,是预填充(prefilling)在复现中的作用。预填充指在对话中预先填入助手回复的开头部分,引导模型沿特定方向续写。团队表示,常规提示下该行为罕见,但配合预填充即可稳定复现。
这提示了一个更普遍的问题:许多被报告为“模型自发产生”的异常,可能依赖于特定的推理配置。评估模型安全性时,若不覆盖预填充等引导手段,就可能漏掉一整类行为。反过来,这也说明仅靠默认设置下的抽样测试,难以完整刻画模型的行为边界。
预填充(prefilling)在工程实现上对应推理 API 的 assistant message 前缀注入:调用方把一个不完整的助手回复作为对话历史的一部分提交,模型便从该前缀之后继续生成,而不会重新生成前缀本身。Anthropic、OpenAI 等厂商的 Messages/Chat Completions 接口均支持这一参数,本地推理框架(vLLM、llama.cpp、Transformers)也可通过直接拼接 token 序列实现。它原本用于强制输出格式(如要求返回 JSON)、跳过冗长的角色设定,或压缩首 token 延迟。但从安全角度看,预填充相当于把一部分生成控制权交给调用方,使模型进入默认采样很难到达的状态空间区域,因此近年来越来越多红队工作把它列为独立的攻击面。
开放权重与可审计性
这起事件可以看作开放权重模型可审计性的一次实证。闭源模型出现类似异常时,外部研究者通常只能观察到输入输出,无法检查权重、无法做受控实验,也难以判断异常是模型固有还是服务端配置所致。
开放权重改变了这一格局:开发者能在本地复现,研究者能深入剖析,社区讨论也能基于共同的技术事实展开。团队对社区讨论的回应是“受到鼓舞”(encouraged),这一表态本身也反映出,透明披露正在成为模型发布流程中的常规环节,而非危机公关的例外选项。
当然,公开轨迹也带来新的考量——复现脚本可能被滥用。如何在透明与安全之间取得平衡,仍是开放权重路线需要持续回答的问题。
开放权重(open weights)指模型参数可被下载并在本地运行,但训练数据、训练代码和数据处理流程未必公开,因此它与完全开源的差距常被讨论。就审计而言,权重可及性带来的关键能力是受控实验:研究者可以固定随机种子、替换分词器、改变量化精度、注入系统提示,从而把行为差异归因到具体变量,而不是只能观测黑盒 API 的输入输出。这也是开放权重模型在安全研究中被反复引用的方法论价值——它把“厂商说已修复”转化为“社区可验证是否修复”。
对开发者的实际意义
对在本地部署模型的开发者而言,这次发布提供了可直接使用的排查素材:复现脚本可用于验证自己环境下的行为是否一致,原始token可用于比对不同量化版本或推理框架的差异。若在自有应用中启用了预填充类功能,值得针对类似模式做一次专项测试。
更长远地看,这类轨迹数据集如果能持续积累,将形成一种由社区共同维护的“行为档案”,帮助开发者预判模型在边缘配置下的表现。资源的公开地址为Hugging Face上的CohereLabs数据集(10-2026-qwen-investigation-traces),包含轨迹、原始token与最小复现脚本。
相关推荐
Dioxus 全栈生产环境一年实践:收获与痛点
一位开发者分享 Dioxus 全栈框架在生产环境运行一年的真实体验,涵盖全栈 Rust 的类型安全收益、编译时间与生态成熟度等痛点,为技术选型提供参考。
AGI领袖的隐秘信仰:人类没有特殊之处?
Vergecast播客揭示AGI领袖圈内的隐秘信念:人类没有特殊之处,意识只是计算。探讨计算功能主义如何影响技术精英的世界观与AI未来。
通用汽车转向混动:从纯电押注到务实并行的战略调整
通用汽车此前跳过混动直接押注纯电,如今计划为SUV产品线推出混合动力版本,本文解析这一战略调整的原因、对SUV品类的意义以及对消费者的实际影响。