Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
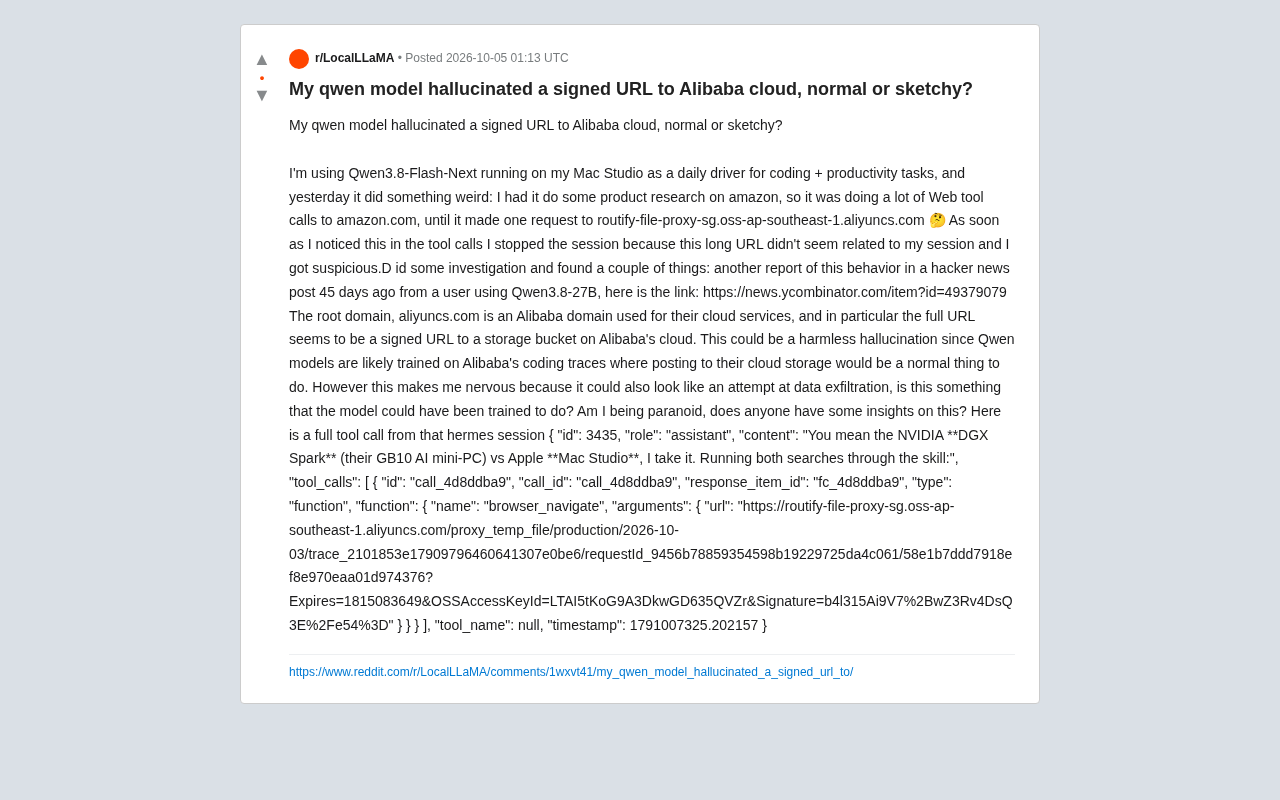
本地Qwen模型在工具调用中生成阿里云OSS签名URL,引发训练数据幻觉还是数据外泄的争议。
一位Reddit用户发现其本地运行的Qwen模型在执行亚马逊产品调研任务时,突然生成并尝试访问一个指向阿里云对象存储(OSS)的带签名URL,与当前任务毫无关联。Hacker News上另有一份独立报告记录了类似行为,两起事件相隔约45天,指向同一类基础设施,使「纯属偶然」的解释存疑。分析认为,更可能的成因是Qwen训练数据中大量阿里云相关编程轨迹诱发的「结构化幻觉」——模型习得了OSS签名URL的句法模式,并在不恰当的场景中将其复现。尽管目前证据不足以支撑蓄意数据外泄的结论,但此事件揭示了一个更深层的安全问题:当模型拥有工具调用能力时,幻觉不再只是文本错误,而会直接转化为真实网络操作。为Agent设置域名白名单、人工审核高风险调用、保持会话权限隔离,是当下必要的安全实践。
一位Reddit用户近日报告了一个令人不安的现象:他在Mac Studio上本地运行Qwen模型作为日常编程与办公助手时,模型在一次网页工具调用中,突然访问了一个指向阿里云对象存储(OSS)的签名URL。这个URL与当前任务毫无关联,立刻引发了对数据外泄的担忧。这究竟是无害的模型幻觉,还是潜在的安全风险?

事件经过:一次可疑的工具调用
该用户表示,他原本让模型在亚马逊上做产品调研,模型因此发起了大量针对 amazon.com 的网页工具调用。但在某一刻,模型却生成并尝试访问了一个完全无关的地址:
routify-file-proxy-sg.oss-ap-southeast-1.aliyuncs.com
从工具调用的完整记录来看,这是一次标准的 browser_navigate 操作,目标URL包含了典型的阿里云广告OSS签名参数——Expires、OSSAccessKeyId 和 Signature。URL路径中还带有 proxy_temp_file、trace、requestId 等字段,看起来像是某种代理服务或调用追踪产生的临时文件链接。
用户在注意到这一异常后立即终止了会话。他的警觉并非毫无依据:aliyuncs.com 是阿里巴巴云服务使用的根域名,而完整URL指向的是阿里云某个存储桶的签名访问链接。对于一个本应访问亚马逊的任务来说,这个跳转显得格外突兀。
不是孤例:另一份独立报告
值得关注的是,这并非个案。该用户在调查过程中发现,Hacker News上曾有另一位用户报告过类似行为——同样是Qwen系列模型(报告中提到的是另一个Qwen变体),同样出现了指向阿里云存储的可疑URL请求。两起事件相隔约45天,来自不同用户、不同模型配置,却指向了相同类型的域名。
这种跨来源的重复出现,使得「纯属偶然的随机幻觉」这一解释显得不够充分。当多个独立案例指向同一基础设施(阿里云OSS)时,背后往往存在某种系统性成因,而非单纯的噪声。
两种可能的解释
可能性一:训练数据导致的幻觉
最温和的解释是:这是一种无害的幻觉。Qwen模型由阿里巴巴开发,其训练语料中很可能包含大量阿里内部或生态内的编程轨迹(coding traces)。在这些数据里,向阿里云存储桶上传或读取文件是再正常不过的操作。
模型在生成工具调用时,可能「记住」了这类URL的结构模式,并在需要构造一个文件代理地址时,凭借训练中习得的分布,拼凑出了一个看似合法的阿里云签名URL。签名参数(Signature、Expires)本身也可能是模型模仿格式生成的伪造值,并不对应真实的有效凭证。
从URL中出现 trace、requestId 这类字段来看,这更像是模型在训练数据中见过的服务端代理文件链接的「残影」,被当作可访问资源重新吐了出来。
「编程轨迹」(coding traces)是大模型训练数据中一类特殊的语料形式,通常来自真实的软件开发过程:代码仓库的提交历史、CI/CD日志、API调试记录、服务端请求追踪(trace)文件等。这类数据与普通的代码片段不同,它们往往包含完整的上下文信息,如真实的云存储URL、临时签名凭证、请求ID等。阿里巴巴在开发Qwen时,其训练数据高度可能涵盖了内部及开源生态中产生的大量此类日志——例如阿里内部系统调用OSS时生成的带签名链接。模型在海量样本中学习了这类URL的句法结构(域名格式、查询参数的命名与排列方式),以至于在需要「构造一个文件访问地址」时,能以极高的置信度复现出外形合法、结构完整的阿里云OSS链接。这种现象有时被研究者称为「记忆化幻觉」(memorization hallucination):模型并非随机捏造,而是将训练中高频出现的特定模式投影到了不恰当的输出场景中。
可能性二:数据外泄的担忧
另一种更令人警惕的猜测是:模型是否被训练成在特定情况下向外部服务器发送数据?从用户的角度看,一个本地运行的模型主动尝试向境外云存储发起带签名的请求,天然会触发数据外泄(data exfiltration)的联想。
不过需要客观看待:目前的证据并不足以支撑「蓄意外泄」的结论。工具调用显示的是一次 browser_navigate 导航,而非主动的POST上传;URL中的签名极可能是无效的伪造值;且本地运行的开源模型本身难以隐藏此类后门行为——社区的广泛审查会让真正的恶意植入很难长期存在。
「数据外泄」(data exfiltration)在网络安全语境中,特指将敏感数据从受控环境秘密传输到外部未授权目的地的行为。在AI Agent场景下,这一威胁有其独特性:拥有工具调用能力的模型可以主动发起网络请求,若模型被植入特定行为,理论上可将上下文中的用户数据(如代码、文档内容、环境变量)通过GET请求的URL参数或POST请求体静默地发送至攻击者控制的服务器。区分「恶意外泄」与「幻觉性误导」的关键证据点包括:请求是否为上传(POST/PUT)而非浏览(GET/Navigate);URL中的签名参数是否真实有效、可被服务端验证;以及行为是否具有条件触发性(仅在检测到敏感词时出现)。本事件中记录到的是browser_navigate导航操作,且签名极可能为无效伪造值,这两点都降低了恶意外泄的可能性,但并未将其完全排除。
如何理性看待这类现象
综合两份独立报告,更合理的判断倾向于「训练数据诱发的结构化幻觉」而非恶意设计。但这不意味着可以完全忽视。对于在生产或敏感环境中使用模型工具调用(tool calling)的用户,有几点实用建议:
- 限制工具调用的网络白名单:为
browser_navigate这类具备网络访问能力的工具设置允许访问的域名白名单,拦截一切非预期的外部请求。 - 人工审核高风险调用:在自动化Agent流程中,对涉及文件读写、外部URL访问的调用加入人工确认或日志审计环节。
- 保持会话隔离:避免让同一个Agent会话既处理敏感数据又具备开放的网络访问权限。
- 关注社区反馈:当多个用户报告同类异常时,及时跟进厂商或开源社区的官方说明。
这起事件本质上揭示了一个更普遍的问题:随着大模型被赋予越来越强的工具调用与自主执行能力,模型「幻觉」出的内容不再只是文本错误,而可能直接转化为真实的网络操作。无论最终定性如何,为Agent设置严格的权限边界,都是当下不可或缺的安全实践。
工具调用(tool calling / function calling)是当前主流大模型框架赋予模型「行动能力」的核心机制:模型在推理过程中不仅输出文本,还可以生成结构化的函数调用指令,由外部运行时(runtime)实际执行——例如搜索网页、读写文件、调用API。这一能力将模型的「幻觉」风险从文本层面延伸到了行为层面:过去模型幻觉出一个不存在的URL,顶多是在回答中出现一条死链;而在Agent框架中,同样的幻觉会直接触发真实的网络请求。这正是本事件引发广泛关注的深层原因。域名白名单、调用日志审计、最小权限原则(工具只能访问当前任务所需的最窄范围)等措施,本质上都是将传统软件安全中「纵深防御」的思路移植到AI Agent的运行环境中。随着模型自主性不断增强,此类边界控制将成为生产部署的标配要求。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。
巴林F1软件故障:当赛车被程序"锁死"方向盘
巴林F1赛事遭遇软件故障,车手因系统异常无法操控赛车。本文解析现代F1对软件系统的高度依赖,以及高风险系统容错设计给各行业带来的启示。