多模态AI转录开罗genizah:右向左语言的VLM微调实践
研究者通过微调视觉语言模型,探索自动转录开罗Genizah希伯来语等右向左手写历史手稿的技术路径。
开罗Genizah是保存有约30万份中世纪犹太社区文献的珍贵档案,因书写语言为希伯来语等右向左文字、手稿年代久远且破损严重,人工转录长期是学界瓶颈。近期一篇技术文章探索了通过领域微调视觉语言模型(VLM)来自动处理这类文献的方法:相较于传统分步OCR流水线,端到端的VLM能够同时处理图像理解与文字生成,对不规则布局和残缺手稿更具鲁棒性;RTL语言的方向处理是微调质量的关键环节。这一实践不仅为开罗Genizah的大规模数字化提供了新工具,也为更广泛的低资源、非主流书写系统文献转录提供了可复制的方法论参考,对历史学、语言学、宗教学研究具有重要意义。
当古老手稿遇见多模态AI
开罗genizah(Cairo Genizah)是中世纪犹太社区遗留的海量手稿文献库,涵盖希伯来语、阿拉米语等多种从右向左书写的语言。这批文献对研究中世纪地中海世界的宗教、商业与日常生活具有不可替代的价值,但其数量庞大、书写潦草、年代久远,人工转录工作长期是学界的瓶颈。
近期一篇技术文章探讨了如何通过微调视觉语言模型(Vision-Language Models, VLM)来自动转录这类文献,为数字人文领域提供了新的工具思路。文章同时提供了免付费墙的阅读链接,让更多研究者能够直接接触这一方法的技术细节。
开罗Genizah(字面意思为"存放库")于1896年在开罗本以斯拉犹太会堂的储藏室中被发现,保存了约30万份从9世纪至19世纪的文献碎片,现分藏于剑桥大学、牛津大学等机构。这批文献涵盖宗教典籍、私人信件、商业合同乃至购物清单,是研究中世纪地中海犹太社区日常生活的第一手资料。其中尤为珍贵的是大量用犹太-阿拉伯语(Judeo-Arabic,以希伯来字母书写阿拉伯语)写成的文本,以及迈蒙尼德(Maimonides)的亲笔手稿。由于年代跨度大、书写者众多、字体风格迥异,这批文献的人工转录进展极为缓慢——即便是专业学者,一生能够整理的碎片也极为有限。
右向左语言为何是难点
当前主流的多模态模型和OCR系统大多以拉丁字母、从左向右书写的语言为训练重心。希伯来语、阿拉伯语这类从右向左(Right-to-Left, RTL)书写的语言,在训练数据覆盖、字符分割、文本行排序等环节都存在天然劣势。
具体困难体现在几个方面:手写体字符形态变化大,连笔与缩写普遍;RTL语言的文本方向与模型默认的解码顺序相悖,容易出现字符顺序错乱;历史手稿往往伴随墨迹褪色、纸张破损、页边注释等噪声,进一步增加了识别难度。这些因素叠加,使得通用VLM在未经专门调优时表现不佳。
微调VLM的技术路径
文章的核心贡献在于验证了对现有视觉语言模型进行领域微调(fine-tuning)的可行性。相较于从零训练专用OCR模型,微调VLM能够复用大模型已有的视觉理解与语言生成能力,在相对有限的标注数据下实现对特定文献类型的适配。
这一思路的价值在于,VLM将图像识别与语言理解统一在同一框架内,不再需要分离的字符检测、分割、识别流水线。对于手写、残缺、排版不规则的历史文献,端到端的多模态方法往往比传统分步OCR更具鲁棒性。微调过程中对RTL语言方向的处理,是决定转录质量的关键环节。
视觉语言模型(VLM)是将图像编码器与大型语言模型联合训练的多模态架构,代表性模型包括GPT-4V、LLaVA、Qwen-VL等。其核心思路是通过交叉注意力或特征拼接,让语言模型能够"看懂"图像内容并生成对应文本。在OCR类任务中,VLM相较于传统流水线的优势在于:它不需要预先定义字符集或分割规则,而是将图像整体输入后直接输出文字序列,天然适应布局不规则、字符集开放的历史手稿场景。领域微调(domain fine-tuning)通常采用少量高质量的图文对(手稿图像+人工校对转录文本)对预训练模型进行参数更新,常见方法包括全量微调、LoRA等参数高效微调技术,后者可在消费级GPU上完成训练,大幅降低了人文研究机构的技术门槛。
对数字人文的意义
将多模态AI应用于古籍转录,意味着大量此前难以数字化的文献有望被纳入可检索、可分析的数据集。对历史学、宗教学、语言学研究者而言,这不仅是效率的提升,更可能打开新的研究维度——批量转录后的文本可用于语料分析、跨文献比对与知识图谱构建。
同时,这项工作也提示了一个更普遍的方向:针对低资源、非主流书写系统的AI适配,正在成为多模态模型落地的重要课题。开罗genizah的转录实践,可以视为RTL语言乃至更多小语种文献数字化的一个方法论样本。
数字人文(Digital Humanities)领域已有若干大规模古籍数字化项目积累,如Transkribus平台通过众包标注与HTR(手写文字识别)技术处理欧洲历史档案,但这些工具对RTL语言和非拉丁字符系统的支持仍相当有限。批量转录后的结构化文本可进一步与地理信息系统(GIS)结合,复原中世纪贸易网络;或通过命名实体识别(NER)提取人名、地名,构建人物关系图谱。开罗Genizah的数字化实践也与更广泛的"濒危语言与文化遗产AI保护"议题相呼应——世界各地博物馆和档案馆中存有大量尚未数字化的非主流语言文献,VLM微调路径的可复制性,意味着这一方法有望以相对低廉的成本推广至更多语言文化传统。
小结
受限于原始素材信息量,本文无法深入呈现具体的模型选型、数据规模与量化评测结果。但从公开的方法框架看,用微调VLM处理右向左手写文献,代表了多模态AI在专业垂直领域的一次有价值的探索。有兴趣的读者可通过原文提供的免费链接进一步了解技术细节。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
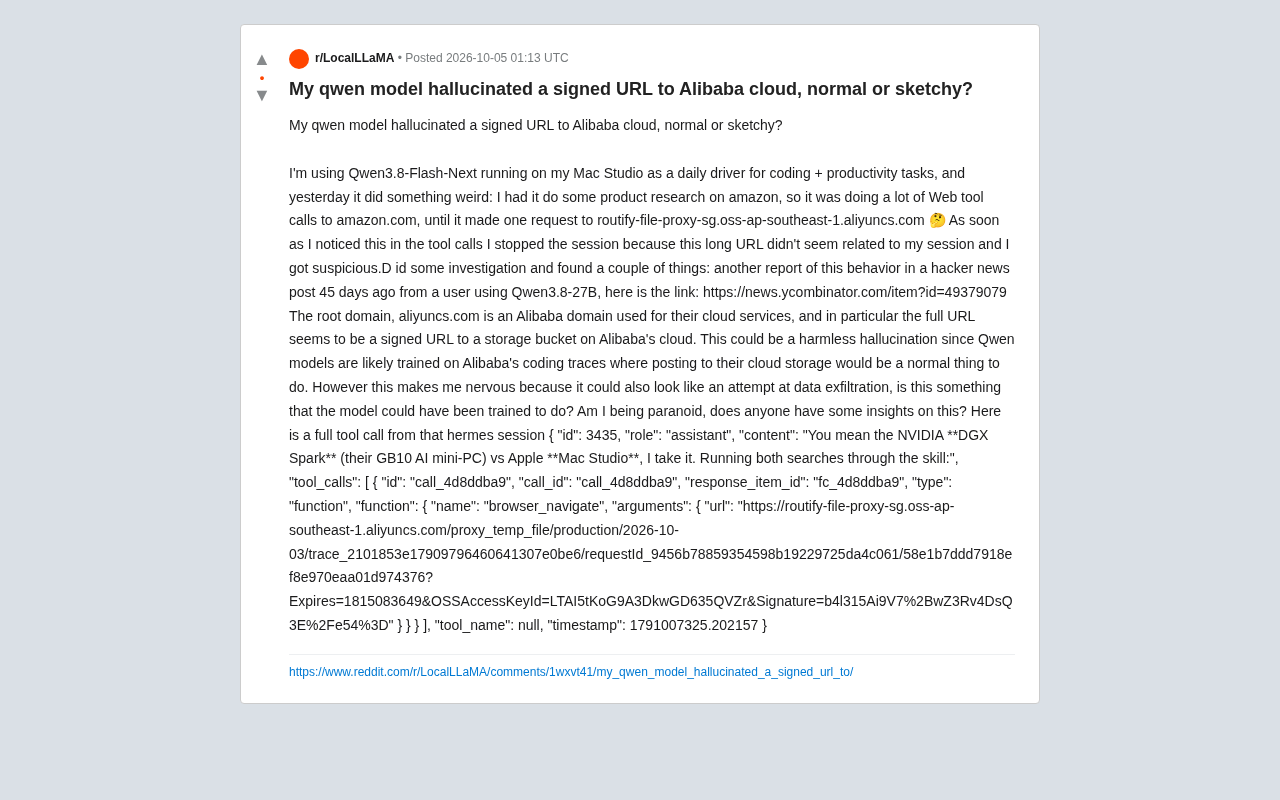
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
巴林F1软件故障:当赛车被程序"锁死"方向盘
巴林F1赛事遭遇软件故障,车手因系统异常无法操控赛车。本文解析现代F1对软件系统的高度依赖,以及高风险系统容错设计给各行业带来的启示。