R2VC:模块化事实核查架构,让LLM验证更可信
R2VC用四模块化架构拆解事实核查,在FEVER上准确率提升近14%并让置信度真正可信。
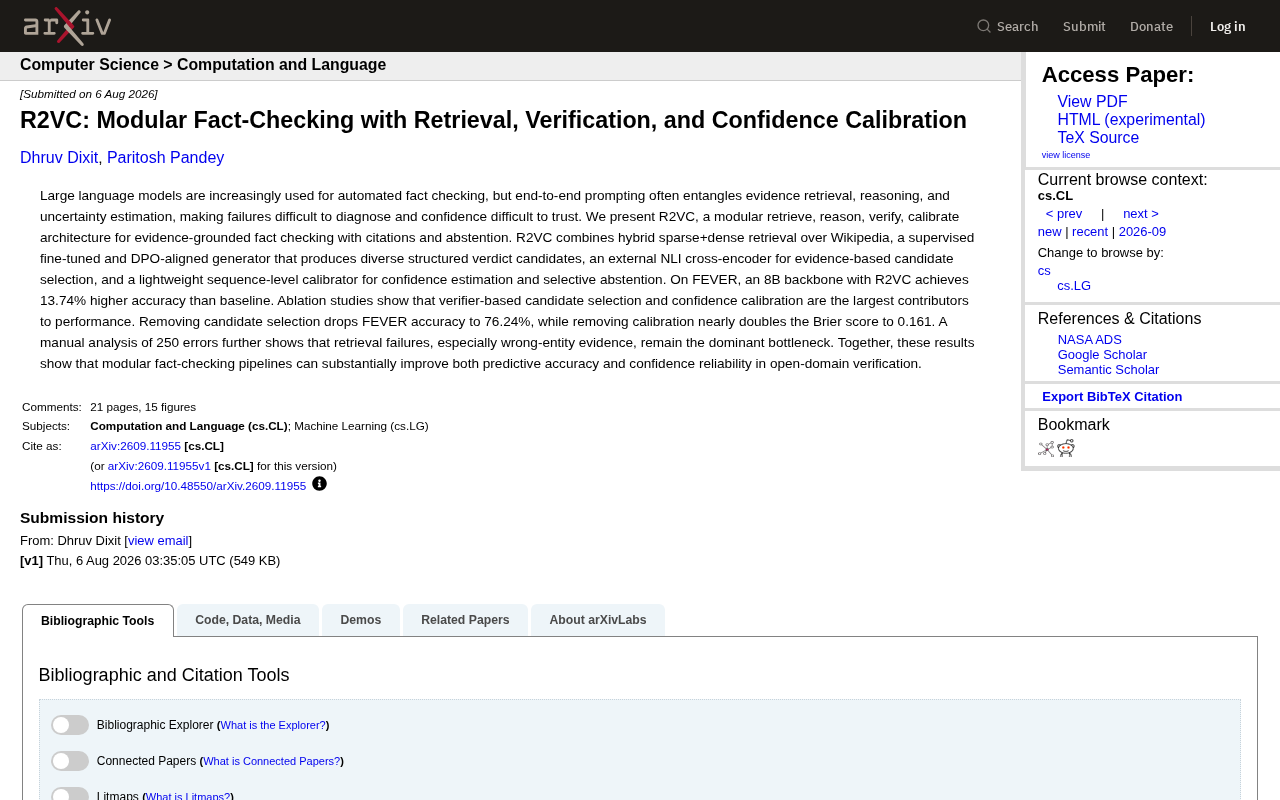
R2VC是一篇针对LLM事实核查"黑箱困境"提出的模块化解决方案。它将端到端流程拆解为检索、推理、验证、校准四个独立环节:混合稀疏与稠密检索召回证据,经监督微调与DPO对齐的生成器产出多个候选判定,NLI交叉编码器基于证据筛选最优候选,最后由轻量校准器给出可靠置信度并在必要时选择弃权。在FEVER基准上,8B骨干模型搭配R2VC后准确率较基线提升13.74%;消融实验显示移除校准模块会使衡量概率可靠性的Brier score几乎翻倍。人工分析250个错误案例发现,检索失败——尤其是错误实体证据——仍是整条流水线的最大瓶颈,提示提升实体消歧精度是未来最值得投入的方向。
端到端事实核查的困境
大语言模型正越来越多地被用于自动化事实核查,但主流的端到端提示(end-to-end prompting)方法存在一个根本性问题:它把证据检索、推理和不确定性估计三个环节纠缠在一起。当系统给出一个错误判断时,你很难定位究竟是检索没找到证据、推理逻辑出错,还是置信度估计失准。更麻烦的是,这种黑箱式的输出让模型给出的"确信度"变得不可信——它可能对一个完全错误的结论表现得信心十足。
arXiv 上一篇题为《R2VC: Modular Fact-Checking with Retrieval, Verification, and Confidence Calibration》的新论文,正是针对这一痛点提出了解决方案。研究者主张用模块化架构替代单一的端到端流程,把事实核查拆解成可诊断、可优化的独立组件。
R2VC 的四段式模块化设计
R2VC 的名字来自其核心的四个环节:Retrieve(检索)、Reason(推理)、Verify(验证)、Calibrate(校准)。这套架构面向的是带引用(citations)和可弃权(abstention)的证据支撑型事实核查,每个模块各司其职。
混合检索:稀疏与稠密结合
第一步是在维基百科语料上进行混合检索,同时使用稀疏(sparse)和稠密(dense)两种检索方式。稀疏检索擅长精确的关键词匹配,稠密检索则能捕捉语义层面的相关性,两者结合可以在开放域场景中更全面地召回相关证据。
生成多样化的结构化判定候选
第二步的生成器经过监督微调(SFT)和 DPO(Direct Preference Optimization)对齐训练,它并不直接给出单一答案,而是产出多个多样化的结构化判定候选(verdict candidates)。这种"多候选"策略为后续的验证环节留出了择优的空间,避免过早锁定在一个可能错误的结论上。
外部验证与置信度校准
第三步引入一个外部的 NLI 交叉编码器(cross-encoder),基于检索到的证据对多个候选进行筛选,选出最符合证据支撑的判定。第四步则是一个轻量级的序列级校准器,负责置信度估计和选择性弃权——当模型对某个判断的把握不足时,它可以选择"不作答",而不是强行给出一个低可信度的结论。
实验结果:准确率与可信度双提升
在事实核查的标准基准 FEVER 上,一个 8B 规模的骨干模型搭配 R2VC 架构后,准确率比基线提升了 13.74%。这是一个相当显著的改进,说明模块化设计并非只是工程上的整洁,而是切实带来了性能收益。
消融实验进一步揭示了各模块的贡献权重。研究者发现,基于验证器的候选筛选和置信度校准是性能提升的两大主力:
- 移除候选筛选环节后,FEVER 准确率下降到 76.24%;
- 移除校准模块后,Brier score(衡量概率预测可靠性的指标)几乎翻倍,达到 0.161——这意味着模型输出的置信度变得远不可靠。
这组数据清楚地表明,验证与校准这两个环节对于"让模型的自信程度值得信任"至关重要,而这恰恰是端到端方法难以保证的。
检索仍是最大瓶颈
值得关注的是研究团队对 250 个错误案例的人工分析。结果显示,尽管模块化架构整体表现优异,检索失败仍然是最主要的瓶颈,其中"错误实体证据"(wrong-entity evidence)问题尤为突出——即系统检索到了看似相关、实则指向错误实体的证据。
这一发现颇具启发意义:它提示后续研究的重点或许不在于更强的推理能力,而在于如何提升检索的实体消歧精度。哪怕推理和校准环节做得再好,如果喂进去的证据本身就指向了错误的对象,整个核查链条依然会失效。
对自动化事实核查的启示
R2VC 传递的核心信息是:模块化的事实核查流程能够同时改善开放域验证中的预测准确率和置信度可靠性。通过把检索、推理、验证、校准解耦,系统不仅表现更好,故障也更容易诊断——每个环节都可以单独评估和替换。
在 LLM 被广泛用于信息验证的当下,这种"可解释、可弃权、可校准"的设计思路,比一味追求更大模型的端到端方案更具工程价值。它承认模型会犯错,并为犯错提供了明确的兜底机制(弃权),这对于要求高可信度的实际应用场景尤为重要。
相关推荐
MIT衍生公司将塑料废料变身高韧性建筑材料
MIT衍生初创公司Atlas Building Composites将塑料废料转化为高韧性建筑与基础设施部件,探索塑料回收的高价值产业化出路。本文解析其技术路径与产业意义。
CCPS采样法:保留推理多样性,无需微调提升LLM表现
arXiv新论文提出Chopthin-Consensus Power Sampling(CCPS),通过保留推理多样性的重采样与语义多数选择机制,在不进行任何训练的情况下提升大语言模型推理准确率,最高绝对增益达10.6个百分点。
HardFlow算法:让生成式AI满足安全关键场景的硬约束
HardFlow是一种新算法,旨在让生成式AI在安全关键场景中严格遵守硬约束条件,同时保持高质量输出。本文解析其核心思路、技术难点与在机器人、工程设计等领域的应用前景。