RAG分块才是产品,模型只是引擎

RAG的瓶颈在分块策略而非嵌入模型,结构感知分割与管道负责人制是质量关键。
文章指出,RAG系统在生产环境中失败,往往不是因为嵌入模型弱,而是因为分块器在错误的位置切断了句子。结构感知分块尊重标题、条款、表格等文档逻辑边界,能避免表格碎片化、脚注毒化检索和交叉引用丢失。元数据(文档ID、章节路径、生效日期)对检索质量的提升甚至超过重排序器。评估应使用对抗性检索问题,recall@5失败时重排序器无法补救。摄入管道需要具名负责人、版本控制和CI中的分块版本管理,否则政策更新后索引会无声腐烂。多语言语料库还需分块级别的语言检测与按语言分别评估。核心行动是:抽样50个分块人工检查,追查生产失败案例到具体分块决策,修复剪刀而非模型。
你的RAG演示在十份干净的PDF上跑通了。然后法务上传了一份400页的政策文档,里面有脚注、附件和交叉引用,分块器把它搅成了一锅粥。模型没有失败——是你的剪刀出了问题。
分块是领域知识进入RAG系统的地方。结构感知的分割(标题、条款、表格)、针对引用需求调优的重叠、能在检索后存活的元数据——这些才是产品本身。你可以整天换嵌入模型,但如果分块在4.2节中间把句子切断了,用户拿到的就是自信满满的胡说八道。
对于许多企业文档,512-1024个token是常见的甜点区。但表格和政策文档往往需要结构感知,而不是固定大小。把元数据(文档ID、章节路径、生效日期)加进去,检索质量的提升比再加一个重排序器还大。
本文基于ayraix.com的社区分析整理。
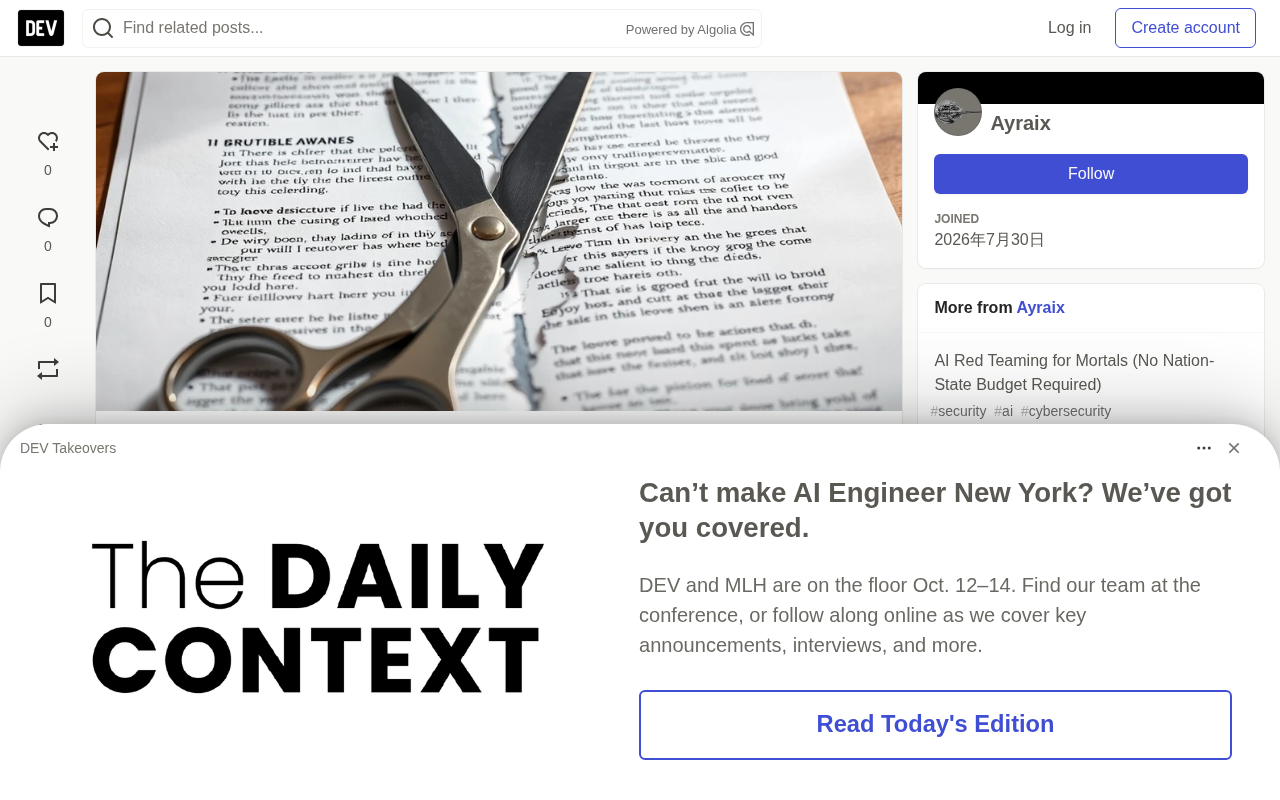
像图书管理员一样分块,而不是像碎纸机
尊重文档结构。保持表格完整,或者显式地为它们生成摘要。把标题传播到分块头部,让嵌入向量携带上下文。用真实问题测试检索——不是“这份文档讲了什么”,而是“根据政策,我们Q3能否报销客户晚餐”。
固定大小分块与结构感知分块的区别在于:模型看到的东西完全取决于你的管道喂给它什么。
分块质量检查清单
一个人能仅凭这个分块回答问题吗?如果不能,模型也不能。
- 语义边界——标题、编号条款、API端点块
- 有目的的重叠——衔接上下文,而不是复制整个章节
- 版本标签——过期的分块比没有分块更糟糕
- 人工抽查——在信任索引之前,先抽样50个分块
RAG是一个穿着AI外衣的出版问题。编辑纪律胜过更大的嵌入向量。
| 对比项 | 固定token | 结构感知 |
|---|---|---|
| 政策文档 | 条款中间切断 | 条款完整 |
| 表格 | 碎片化 | 保留或摘要化 |
| 引用 | 模糊 | 链接到章节 |
什么是结构感知分块? 结构感知分块(structure-aware chunking)是指在切分文档时,优先识别并尊重文档自身的逻辑边界——标题层级、编号条款、表格边界、列表项、代码块等——而不是简单地按固定字符数或token数切割。与固定大小分块相比,它的核心假设是:文档作者已经用结构标记了语义单元,这些标记比任何统计切分都更可靠。
在实践中,结构感知分块通常分两步:先用解析器(如处理PDF的layout-aware解析器、处理HTML的DOM解析器)提取带层级的文档树,再按节点类型决定合并或拆分策略。例如,一个条款可以整体作为一个分块,但若超过token上限,则优先在子条款边界切分,而非句子中间。
代价是管道复杂度上升:需要为每种文档类型维护解析规则,且当文档格式变化时解析器也要同步更新。但对于政策、合同、API文档这类结构本身就是语义载体的语料,这一投入几乎总是值得的——因为检索质量的上限由分块边界决定,而非嵌入模型。
表格、附件和脚注陷阱
法律和财务文档的分块方式不同于博客文章。一个被拆到两个嵌入向量里的表格比没有表格更糟糕——模型会在孤立行之间编造关系。从第200页引用的附件需要父级元数据,而不是孤立的碎片。在文档中间重新定义术语的脚注,如果被当作正文处理,会毒化检索。
关键在于:投资一个理解你的文档类型的解析器——合同、政策、API参考、SAP配置指南——而不是通用分割器。解析器质量就是分块质量。
- 表格策略——保持完整,或者为每个表格生成自然语言摘要
- 交叉引用——把“见4.2节”作为元数据中的链接存储,而不是孤立文本
- 生效日期——对分块进行版本控制;检索必须过滤被取代的政策
- 语言标签——多语言语料库需要分块级别的locale,而不是文档级别的猜测
你的分块器就是编辑。糟糕的编辑会让博士级模型看起来像实习生。
为什么被拆分的表格会让模型“编造关系”? 嵌入向量本质上是语义聚合:当一段文本被编码为一个向量时,模型会学习其中实体之间的共现与修饰关系。一个完整表格的每一行都带有列头所定义的语义角色(如“金额”“适用条件”“生效日期”),这些角色信息在向量空间中被绑定在一起。
一旦表格被按token切开,第二块分块可能只剩下一串孤立的数字和短语,失去了列头所赋予的含义。模型在检索到这块内容时,只能根据表面词语猜测这些数字之间是什么关系——于是它会把“相邻行”误读为“因果关系”或“同一实体”,生成看似合理实则错误的结论。
同理,脚注被当作正文处理时,会以“重新定义术语”的方式污染检索:模型无法区分“本文中X指A”与“某脚注中X指B”,最终给出互相矛盾的答案。解决方向有二:保持表格完整并附加自然语言摘要;或将脚注作为父级分块的元数据存储,检索时按需注入上下文,而不是让它独立成块。
真正有杀伤力的评估问题
别用“总结这份文档”了。用对抗性检索问题:互相矛盾的条款、埋在附录里的例外情况、只出现在表格里的数字。如果recall@5在这些问题上失败,没有重排序器能救你——去修你的剪刀。
对你的意义:在索引一万份文档之前,先手动抽样五十个分块。如果一个人无法仅凭一个分块回答问题,那就重写分割逻辑。当解析器变化时,在CI中运行分块版本控制——重新嵌入很贵;及早发现糟糕的分割很便宜。
分块审计提示词
“这个分块来自哪个章节,它能回答什么问题?”——如果你看不出来,模型也看不出来。
recall@5 为什么是分块质量的关键指标? recall@5 衡量的是:在检索返回的前5个分块中,是否包含能够回答该问题的“黄金分块”。它直接反映分块边界是否正确——如果答案所需的句子被切到了另一个分块里,无论嵌入模型多强,recall@5 都会失败。
与精确率(precision)不同,recall更关注“有没有找到”,这正是RAG第一阶段的瓶颈:生成模型只能基于检索到的内容作答,检索漏掉的事实它永远无法恢复。重排序器(reranker)只能在已召回的候选集中重新排序,无法把从未进入前K的正确答案拉回来。
因此,当对抗性问题的 recall@5 偏低时,正确的动作是回到分块策略:检查黄金答案所在章节是否被拆分、表格是否碎片化、交叉引用是否丢失。只有在 recall@5 达标之后,优化嵌入模型或重排序器才是有意义的投入。
管道所有权
指定一个摄入管道的具名负责人——而不是“AI团队”。当法务更新一份政策PDF时,谁来重新分块和重新嵌入?如果没有人负责,你的索引会在聊天模型每季度升级的同时悄悄腐烂。
对你的意义:按文档来源监控索引年龄。当关键语料库超过SLA没有重新索引时发出警报。RAG质量会无声地衰减;仪表盘应该在用户尖叫之前先尖叫。
多语言分块
混合语言语料库需要分块级别的语言检测——而不是文档级别的猜测。用适合语言的模型或统一的多语言编码器嵌入,并在你运营的每个locale中测试你的缩写词。
对你的意义:按语言分别评估检索。一个在英语上有效、在德语上失败的分块器会悄悄杀死全球推广。
在修复聊天模型之前先修复分块——叙述者无法恢复检索从未找到的事实。
对你的意义:当RAG对生产至关重要时,给分块管道自己的on-call轮值。
在责怪模型之前,先修好剪刀
那份400页的政策文档出问题,不是因为嵌入模型弱——而是因为分块器在4.2节中间切断了句子,把自信的胡说八道交给了模型。对你的意义: 在信任一万份文档的索引之前,手动抽样五十个分块。如果一个人无法仅凭一个分块回答问题,模型也不能,无论你加上什么重排序器。
关键在于:像给生产服务指定负责人一样,给摄入管道指定一个负责人。当政策更新而没有人重新分块时,RAG质量会无声衰减——聊天模型因稳定性受到赞扬,而索引在下面悄悄腐烂。
你的分块器就是编辑。糟糕的编辑会让博士级模型看起来像实习生。
分块边界决定了你的RAG系统能检索到什么。把一个脚注从它的表格中分开,上下文就断了;把它们放在一起,嵌入向量就被稀释了。
表格-脚注陷阱:一份法律文档在找到既能保留交叉引用又不丢失检索精度的策略之前,可能需要尝试20多种分块策略。
你的行动: 拿出生产环境中最糟糕的五个RAG失败案例——那些返回不相关分块或错过关键上下文的查询。对每一个,把失败追溯到分块决策:边界是否放错了位置?分块太大还是太小?交叉引用上下文是否丢失了?记录模式,然后针对该文档类型修复分块策略。重复直到生产失败率降到5%以下。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。