让AI Agent真正操作生产级SaaS:Sijil的架构实践
开发者为课堂管理SaaS接入22个Agent工具,通过生成式UI与写操作确认机制实现生产级安全落地。
这篇文章介绍了开发者为课堂管理平台Sijil构建AI Agent的实践:Agent接入22个连接生产后端的工具,可查询学生、成绩、考勤等真实数据,并直接生成可交互的React界面而非纯文本回复。遇到歧义请求时,Agent会生成选择组件将控制权交还用户;执行数据库写操作前,系统会生成预览界面要求用户明确确认,变更完成后写入审计日志。整套系统具备多租户隔离、速率限制等生产级要素。文章的核心命题是:如何在保留Agent灵活性的同时,维持传统软件经过多年打磨的安全边界——这被认为比"如何让LLM访问数据库"这一纯技术问题更具挑战性与普遍意义。
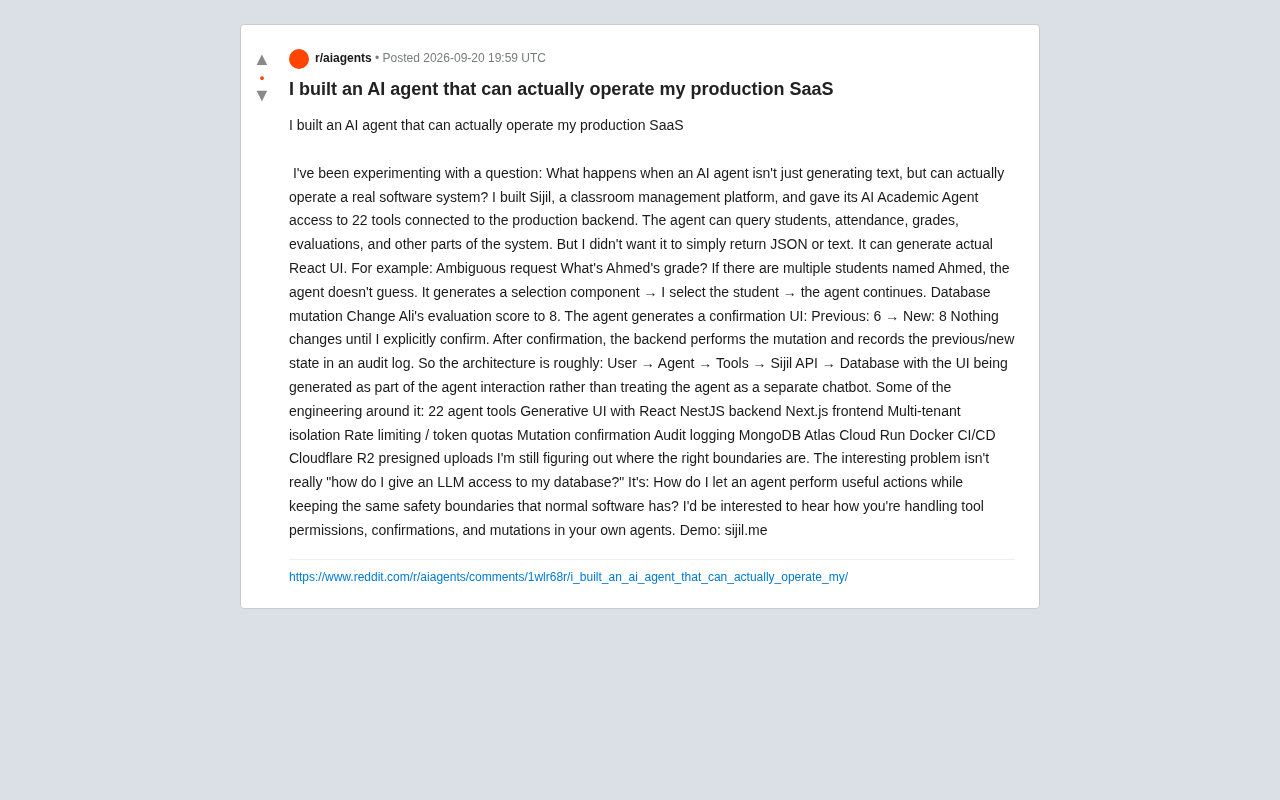
当AI Agent不再只是生成文本,而是能真正操作一套运行中的软件系统时,会发生什么?一位开发者用他构建的课堂管理平台Sijil给出了自己的答案。他为平台的"学术助理Agent"接入了22个连接生产后端的工具,让Agent能够查询学生信息、考勤、成绩、评估等数据——但更关键的是,这个Agent不只返回JSON或纯文本,而是直接生成可交互的React界面。
从聊天机器人到系统操作者
大多数AI Agent的实践停留在"给LLM接上数据库"这一层,让模型读取数据后吐出一段文字回复。Sijil的思路则更进一步:把生成式UI作为Agent交互的一部分,而不是把Agent当成一个独立的聊天窗口。
这种设计的价值在处理模糊请求时体现得很明显。当用户问"Ahmed的成绩是多少?",如果系统中存在多个叫Ahmed的学生,Agent不会去猜测或随便返回一个结果,而是生成一个选择组件,让用户先明确指定是哪一位学生,再继续后续操作。这种"遇到歧义就交还控制权"的机制,避免了LLM在不确定时强行编造答案的典型问题。
生成式UI(Generative UI)是指由LLM在运行时动态决定生成哪种界面组件,而非由开发者预先写死前端逻辑。在Vercel AI SDK等框架的推动下,这一模式近年来逐渐成形:模型不仅返回文本,还可以返回结构化的组件描述,由前端框架渲染成按钮、表单、列表等真实可交互元素。与传统聊天界面相比,生成式UI的优势在于它能将"操作意图"直接物化为界面,减少用户在自然语言和软件操作之间来回转译的认知负担。在Sijil的实现中,Agent将"歧义消解"这一认知步骤转化为一个可点击的选择组件,本质上是把LLM的不确定性在UI层面做了结构化处理,而非留给用户自行解读文字输出。
数据库变更的安全边界
真正的挑战出现在写操作上。读取数据出错顶多是信息不准,但如果让Agent直接修改生产数据库,风险就完全不同了。
当用户下达"把Ali的评估分改成8"这类变更指令时,Agent不会立即执行,而是先生成一个确认界面,清楚展示变更前后的状态:
- Previous: 6 → New: 8
在用户明确点击确认之前,数据库不会发生任何改动。确认之后,后端才执行变更,并将变更前后的状态记录进审计日志(audit log)。这套"预览—确认—执行—记录"的流程,本质上是把传统软件里成熟的安全实践,移植到了Agent的操作链路中。
审计日志(Audit Log)是企业级软件中记录"谁在什么时间对什么数据做了什么操作"的持久化记录机制。它的核心价值有三:事后溯源(当数据异常时可回溯操作链)、合规留证(金融、教育等行业通常有法规要求)、以及异常检测(通过日志模式识别误操作或恶意行为)。在Agent介入数据库操作的场景下,审计日志的重要性进一步提升——因为LLM的操作路径缺乏传统代码的静态可审查性,运行时的操作记录成为唯一可靠的追责依据。将变更前后的状态(before/after)一并记录,而非只记录"执行了某操作",是更完整的审计实践,可以直接支持数据回滚与差异比对。
底层架构与工程栈
整体的调用链路可以概括为:
用户 → Agent → 工具(Tools) → Sijil API → 数据库
UI在这个过程中作为Agent交互的产物被动态生成,而非独立于Agent之外的前端逻辑。
支撑这套系统的工程栈相当完整,涵盖了一个生产级SaaS应有的各个层面:
核心能力
- 22个Agent工具,覆盖查询与变更
- 基于React的生成式UI
- 变更确认机制
- 审计日志
技术选型
- 后端:NestJS
- 前端:Next.js
- 数据库:MongoDB Atlas
- 部署:Cloud Run + Docker + CI/CD
- 存储:Cloudflare R2 预签名上传
多租户与安全
- 多租户隔离(Multi-tenant isolation)
- 速率限制与Token配额
多租户隔离和速率限制这两项,说明作者在设计之初就把它当成一个面向真实用户的产品,而非玩具级Demo。给Agent接上生产环境,配额和隔离机制是防止滥用与数据泄露的基础防线。
多租户隔离(Multi-tenant isolation)是SaaS架构的基础安全要求,指同一套系统在服务多个独立客户(租户)时,确保各租户的数据和操作互不可见、互不干扰。实现方式通常有三种层次:数据库级隔离(每个租户独立数据库实例)、Schema级隔离(共享数据库但独立Schema)、以及行级隔离(共享表但每行附带租户标识并在查询层强制过滤)。在AI Agent场景中,多租户隔离面临额外挑战:LLM生成的工具调用参数可能绕过常规的业务逻辑层直接触达数据层,因此租户标识的校验必须在工具函数内部(而非仅在UI层)强制执行,否则一个构造巧妙的提示词可能让Agent跨租户读写数据。速率限制与Token配额则是防止单一租户过度消耗推理资源、导致服务质量下降的保护机制。
真正值得思考的问题
作者坦言,最有意思的问题并不是"如何让LLM访问数据库"——这在技术上并不难。真正的难点是:
如何让Agent执行有用的操作,同时保持普通软件所拥有的那套安全边界?
这是一个当前AI Agent落地普遍绕不开的命题。传统软件的权限控制、操作确认、事务回滚、日志追溯,都是经过多年打磨的成熟范式。而Agent的引入打破了原有的确定性——LLM的输出本身带有不确定性,如何在保留Agent灵活性的同时,不牺牲这些安全保障,仍是开放的工程课题。
作者也表示自己还在探索"边界应该划在哪里",并主动向社区抛出了三个具体问题:工具权限(tool permissions)如何管理?操作确认怎么设计?数据变更如何把控?
对Agent开发者的启示
Sijil这个案例的参考价值,不在于它用了多先进的模型,而在于它展示了一套务实的Agent落地范式:
把Agent当成系统的操作者而非旁观者,同时用生成式UI、变更确认、审计日志这些手段,把不确定的LLM包裹在确定性的安全框架之内。对于任何想让Agent真正碰生产数据的团队来说,读操作可以放开,写操作必须设卡——这套朴素的原则值得借鉴。
随着Agent能力的增强,"给它多大权限、如何兜底"会成为比"能不能做"更重要的问题。Sijil的实践提供了一个可供参考的起点。
相关推荐

人类造过最快的东西:帕克太阳探测器的43万英里时速
人类建造过最快的物体不是旅行者号或火箭,而是NASA帕克太阳探测器,时速约43万英里。本文解析它如何借助金星引力辅助与太阳引力井加速,以及为何以光速衡量人类仍刚刚起步。

美光CEO警告:内存供应将在未来两年持续趋紧
美光CEO表示存储芯片供应将在未来两年比当前更为紧张,AI需求激增与产能扩张滞后是主因。本文分析内存供应趋紧的原因及其对市场和消费者的影响。
用WhatsApp对话你的AI Agent:开源工具agent-bridge实测解读
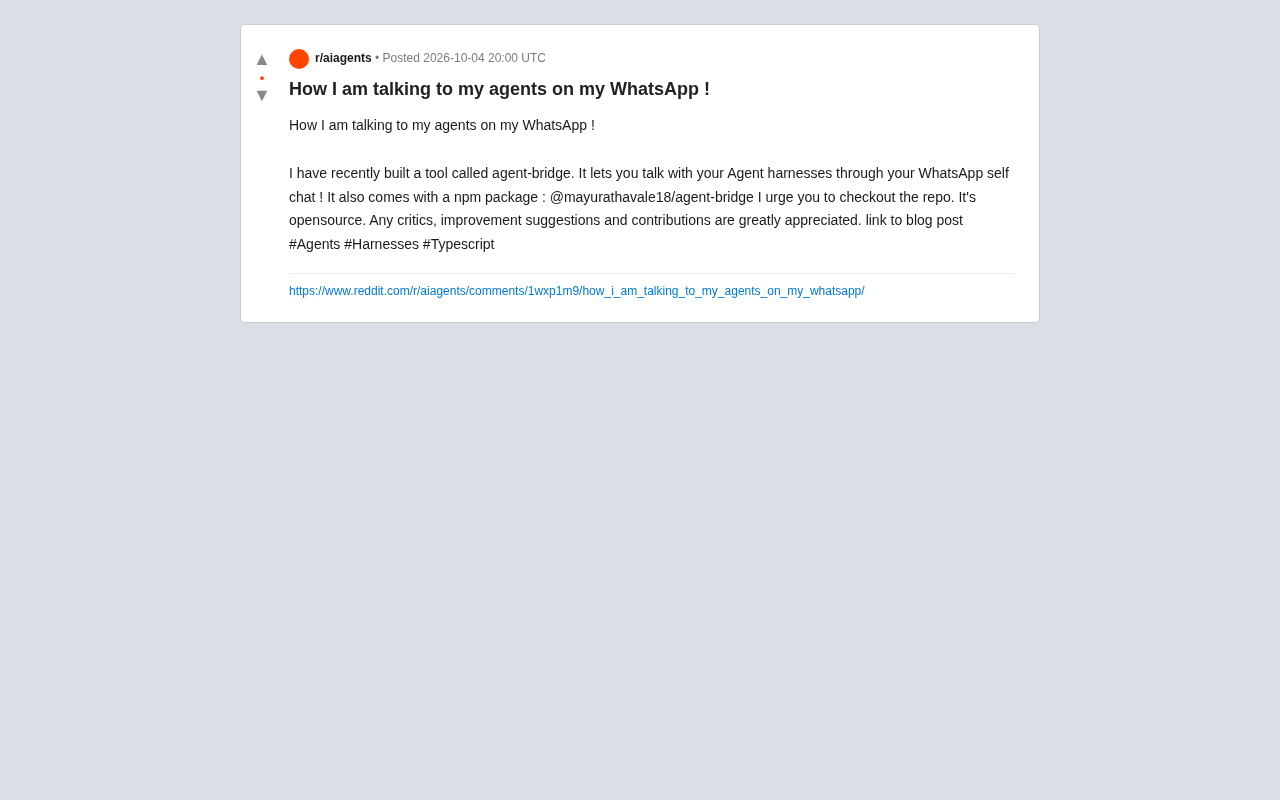
开发者开源了AI Agent工具agent-bridge,可通过WhatsApp自我聊天直接与Agent框架对话。本文解读其TypeScript实现、npm包使用方式及这类IM交互工具的优势与风险。