RCD:用对比解码破解思维链中的查询捷径

RCD 用免训练的对比解码削弱查询捷径,提升 CoT 答案对推理的依赖。
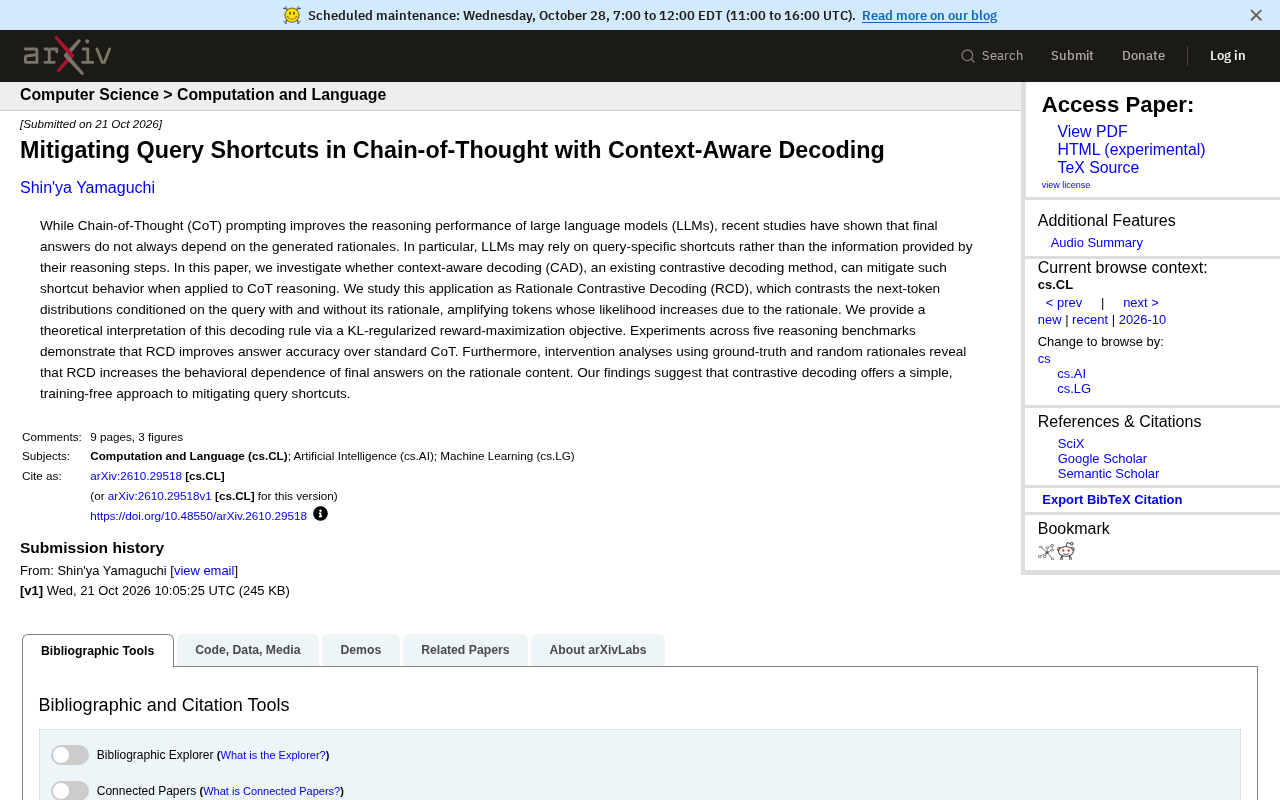
论文针对思维链中推理步骤与最终答案脱节的问题,提出 Rationale Contrastive Decoding(RCD)方法。该方法受上下文感知解码启发,在解码阶段对比“有 rationale”与“无 rationale”两种条件下的下一 token 分布,放大因推理过程而概率提升的 token,从而抑制模型对查询捷径的依赖。作者从 KL 正则化的奖励最大化角度给出了理论解释,并在五个推理基准上验证了 RCD 相比标准 CoT 能提升准确率。干预实验进一步表明,RCD 增加了最终答案对 rationale 内容的行为依赖,说明模型被推向了更依赖推理的路径。该方法免训练、可直接叠加,但依赖模型自身已编码的推理信号,跨领域泛化仍需验证。
思维链(Chain-of-Thought, CoT)提示让大模型学会“把推理过程写出来”,但一个长期被忽视的问题是:模型最终给出的答案,未必真正依赖于它自己生成的推理步骤。论文《Mitigating Query Shortcuts in Chain-of-Thought with Context-Aware Decoding》聚焦的正是这一裂缝——模型可能绕开推理,直接依靠问题本身携带的“查询捷径”作答。
思维链的“虚假依赖”问题
CoT 的流行建立在一个朴素假设上:生成中间推理步骤能提升最终答案质量。但近期研究反复指出,最终答案并不总是由 rationale(推理过程)支撑。模型可能记住了与问题表面形式相关的线索,或者利用训练数据中的统计关联,走一条更短的路径给出答案。
这类行为被作者称为“查询特定捷径”(query-specific shortcuts)。它的危险之处在于隐蔽:推理文本看起来合理,答案也可能正确,但二者之间没有因果联系。一旦问题被改写,或推理步骤被替换,答案就可能崩塌。
因此,问题不在于 CoT 是否“看起来在推理”,而在于答案是否“行为上依赖”推理内容。这篇论文要解决的,正是如何在不重新训练模型的前提下,把答案拉回到推理路径上。
把对比解码搬到推理链上:RCD 方法
作者提出的方法叫 Rationale Contrastive Decoding(RCD),其灵感来自已有的上下文感知解码(Context-Aware Decoding, CAD)。CAD 原本用于让生成结果更依赖给定上下文,做法是对比“有上下文”和“无上下文”两种条件下的下一 token 分布,放大那些因上下文而概率上升的 token。
RCD 把这一思路移植到 CoT 场景:对比“带 rationale”和“不带 rationale”两种条件下模型对下一 token 的预测分布,增强那些因推理过程而变得更可能的 token。
用作者的话说,RCD“通过对比有 rationale 和无 rationale 条件下的下一 token 分布,放大那些因 rationale 而概率提升的 token”。整个过程发生在解码阶段,属于 training-free(免训练)方法,不需要额外标注或微调。
对比解码(Contrastive Decoding) 本身是一种在解码阶段调整 token 概率的通用技术。其核心操作是计算两个分布的差值:一个“专家”分布(如大模型在充分条件下)与一个“业余”分布(如小模型或受限条件下),然后对差值做温度缩放或截断,从而抑制在业余分布中概率高、但在专家分布中概率低的 token。这种做法不需要额外训练,仅通过修改 logits 即可引导生成。CAD 将其具体化为“有上下文 vs. 无上下文”的对比,而 RCD 进一步将“条件”替换为 rationale,因此对比解码的通用框架为理解 RCD 提供了直接基础。
理论视角:KL 正则化的奖励最大化
论文为 RCD 的解码规则提供了一个理论解释:可以将其视为一个带 KL 正则项的奖励最大化目标。
这一视角的意义在于,它把“让答案更依赖推理”从一个工程技巧提升为有目标函数支撑的优化问题。对比解码在这里扮演的角色,是在原始语言模型分布与“以 rationale 为条件”的分布之间做平衡,避免过度偏离模型本身的先验。
对实践者而言,这解释了 RCD 为什么能在不破坏语言模型流畅性的前提下改变答案行为——它不是强行改写输出,而是沿着模型自己已经编码的推理信号做加权。
KL 正则化的奖励最大化 是强化学习与序列生成中的经典目标形式:最大化期望奖励的同时,约束当前策略与参考策略之间的 KL 散度,防止策略偏离先验过远。在语言模型解码中,这一框架常被用来解释“在给定条件下调整 token 分布”的做法——将“答案依赖推理”视为奖励信号,而 KL 项则保证生成结果仍保持语言模型本身的流畅性与多样性。RCD 的解码规则可以看作该目标的一个近似解:对比解码所放大的 token 恰好是那些在 rationale 条件下概率提升的 token,相当于在奖励(依赖推理)与正则(保持先验)之间做权衡。
实验:五个基准上的准确率提升
作者在五个推理基准上验证了 RCD 的效果。结果显示,相比标准 CoT,RCD 提升了答案准确率。
更具信息量的是干预实验。作者用真实 rationale 和随机 rationale 分别做干预,观察最终答案对 rationale 内容的行为依赖是否发生变化。结论是:RCD 增加了最终答案对推理内容的依赖程度。
这一点比单纯的准确率数字更关键。准确率提升可能来自多种原因,但“答案随 rationale 变化而变化”直接说明模型在解码层面被推向了更依赖推理的路径,而查询捷径的权重被相对削弱。
作者在总结中写道,实验“表明 RCD 提升了答案准确率,并增加了最终答案对 rationale 内容的行为依赖”,进而提出对比解码是一种“简单、免训练”的捷径缓解方案。
行为依赖(behavioral dependence) 是评估推理忠实性的一种操作化指标:不直接检查推理文本与答案的逻辑一致性,而是通过干预推理内容(如替换为随机 rationale),观察最终答案是否随之改变。如果答案对 rationale 的替换敏感,则说明模型在行为上依赖推理;反之则可能依赖查询捷径。这种干预实验比单纯准确率更能揭示模型的内部决策路径,因为它直接测试了“改变输入的一部分,输出是否相应变化”的因果效应,类似于因果推断中的干预分析。
对推理模型落地的启示
这项工作对实际部署推理模型有几点直接意义。
其一,捷径问题是评估盲区。如果只看最终答案正确率,很难判断模型是否真的在用推理。RCD 的干预分析提供了一种检验思路:改变 rationale,看答案是否跟着变。
其二,免训练意味着低成本。相比构造反事实数据做微调,解码阶段的对比方法可以直接叠加在现有模型和提示流程上,适合快速验证。
其三,方法仍有边界。RCD 放大的是模型本身已编码的推理信号,如果模型对某类问题根本没有可用的推理知识,对比解码也难凭空造出正确路径。论文的实验集中在五个推理基准上,跨领域泛化仍需更多验证。
从更宽的视角看,RCD 把“模型是否真的在推理”这个问题从训练阶段部分转移到了解码阶段。这未必是终点,但它提供了一条务实的中间路线:不改变模型参数,只改变模型在推理链上的注意力分配。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。