React Native端侧AI实测:Apple与ExecuTorch双引擎对比

实测对比Apple Foundation Models与ExecuTorch在React Native端侧AI推理的结构化输出、速度与工程落地细节。
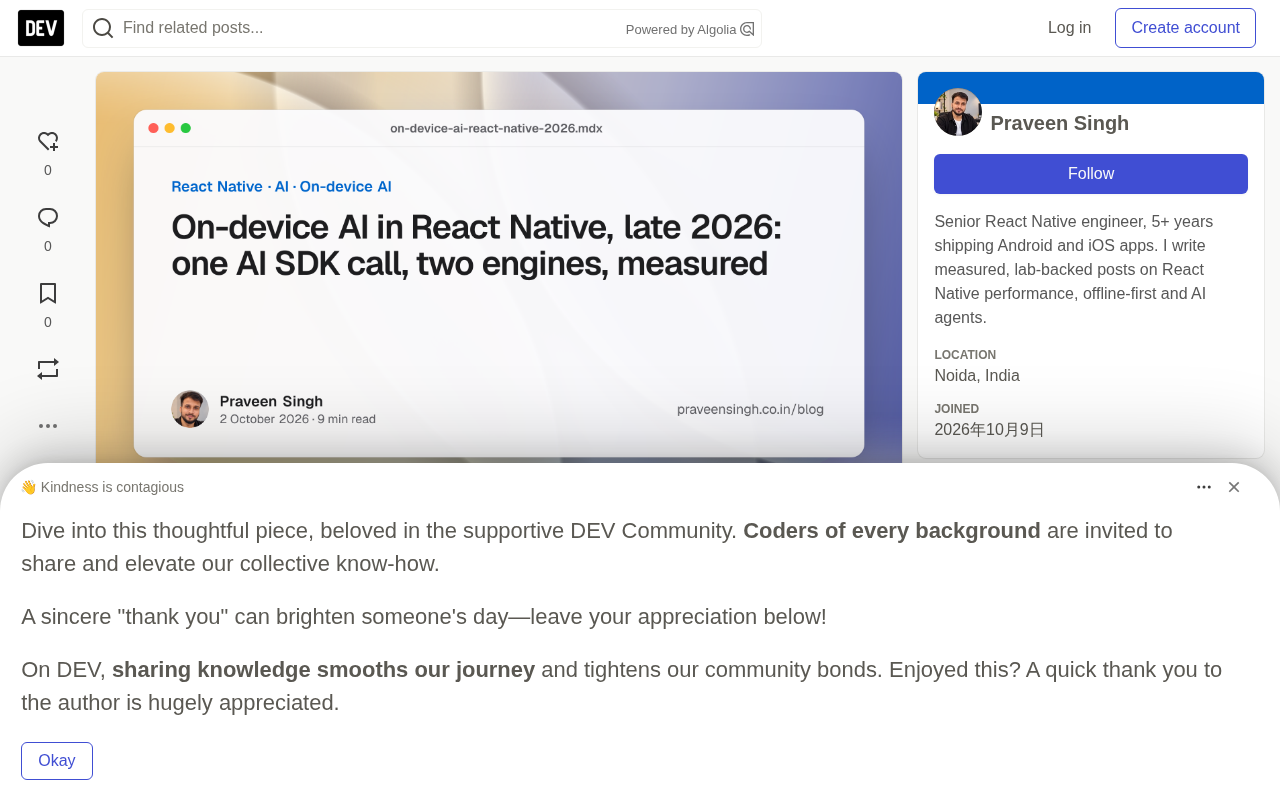
这篇实测将Apple Foundation Models与ExecuTorch(Llama 3.2 1B)两套端侧推理引擎置于相同的AI SDK调用层后面,在React Native 0.87应用中对比真实表现。结构化输出方面差距悬殊:Apple引导式生成20次全部通过Zod校验,ExecuTorch仅2/20,且通过校验的结果也存在内容捏造、字段错误等质量问题。速度上两者预热后首字时间中位数相近(约580ms),但成本分布迥异:ExecuTorch前期需下载1.14GB、每次启动加载5秒、占用约900MB内存;Apple首次调用需10–19秒但之后不占应用内存。工程落地层面,可用性标志不可信(模拟器自报可用却全部失败),必须用真实调用探活;RN 0.87上跑通还需七个文档外的构建修复,并需主动关闭ExecuTorch默认开启的遥测数据上报。
在无服务器、无API密钥的前提下,让大语言模型直接跑在React Native应用里,如今已经从「概念演示」走向了「可落地的工程实践」。但两套主流的端侧推理引擎——Apple Foundation Models 与 ExecuTorch——适合的任务类型差异巨大。一位开发者用一个真实的小型应用,把两套引擎放在同一套 AI SDK 调用代码后面,在相同任务上做了实测,结论值得每个考虑端侧 AI 的团队参考。
一个核心结论:结构化输出,20比2的差距
整篇实测最刺眼的数字,是结构化输出的通过率对比。作者设计了一个「门店审核清单」任务:把一段审核员随手记录的文字,转换成符合 Zod schema 校验的结构化 JSON——每条包含区域、问题和严重程度(low/medium/high)。
结果是:
- ExecuTorch(Llama 3.2 1B,schema 塞进 prompt):20 次只有 2 次有效
- Apple Foundation Models(引导式生成 guided generation):20 次全部有效
差距的根源在于机制。Apple 的模型通过「引导式生成」在框架层面约束模型输出,使其必然符合给定的类型结构;而 ExecuTorch 没有对应能力,适配器只能把 schema 写进 prompt,然后「祈祷」模型照做。这个底层差异,直接决定了结构化任务的成败。
「引导式生成」(Guided Generation)是一种在推理过程中实时约束模型输出 token 的技术,通常通过有限状态机或上下文无关文法来实现。每次模型准备采样下一个 token 时,框架会屏蔽掉所有不符合当前结构约束的候选 token,从而确保最终输出在语法层面必然合法。这与「把 schema 写进 prompt」的本质区别在于:前者是硬约束,发生在采样层;后者是软引导,依赖模型的指令遵循能力,而 1B 这个量级的小模型指令遵循能力本就有限。Zod 是 TypeScript/JavaScript 生态中广泛使用的运行时 schema 校验库,AI SDK 用它来描述期望的输出结构,并在收到模型响应后做严格校验——这也是为什么大小写不匹配或字段缺失都会直接导致「不通过」而非「勉强可用」。
1B 小模型是怎么失败的
作者细致记录了 1B 模型的三类失败模式,很有参考价值:
- 直接返回 schema 本身:某次运行的 9 次失败里有 5 次,模型回了 JSON Schema 定义(
{"$schema": ...}),而不是去填充它。 - 大小写错误:输出
"severity": "High",而 schema 要求小写"high"。 - 根本不是 JSON:返回一个用花括号包起来的无序列表。
两处低成本改动,把通过率从 1/10 提到了 6/10:用「示例」代替「schema」放进 prompt,并在校验前把枚举值统一转小写(通过 AI SDK 的 experimental_repairText)。
但 6/10 依然不足以上线,而且通过 schema 校验不等于内容正确。作者逐条阅读了那些「有效」的清单,发现模型把示例内容「Aisle 2: 洒了牛奶」原样抄进了结果(原始记录里根本没有)、字段张冠李戴、条目重复,而且每一条的严重程度都被标成了 high。
相比之下,Apple 的 20 份清单准确列出了每条问题,归类合理,从不凭空捏造,只是偶尔把小问题评级偏高。结论很清晰:如果你的功能需要可靠的结构化输出,应用里塞一个 1B 模型是不够的,要么用系统模型,要么用更大的下载模型(如 Llama 3.2 3B),要么走云端。
速度:预热之后其实差不多
很多人以为端侧小模型一定更快,实测数据给出了更细腻的答案。两套引擎预热后的表现非常接近,差异都集中在「边缘」:
| 指标 | ExecuTorch 1B(模拟器) | Apple(Mac) |
|---|---|---|
| 首次使用前下载 | 1.14 GB,6分12秒 | 无,随系统附带 |
| 磁盘加载 | 4.4–5.3 秒 | 无 |
| 首次调用首字时间 | 0.6–0.8 秒 | 9.7–19.2 秒 |
| 后续调用首字时间(中位数) | 579 ms | 580 ms |
| 生成速度 | 43 tokens/s | 未报告 |
| 生成时应用内存 | 907 MB | 不占应用进程 |
ExecuTorch 的成本在前期:1.14 GB 下载、每次启动约 5 秒加载、生成时约 900 MB 内存占用——这在容易杀后台的手机上很关键。Apple 的成本在首次调用:第一次要 10–19 秒,但之后约半秒,且模型跑在系统进程里,不占用应用内存,也无需下载。
需要强调的是,Apple 的数字跑在 Mac 上(M1/8GB,测试期间 Mac 还在频繁 swap),不能用来预测真机延迟,只能用于两套引擎之间的横向对比。
表中「首字时间」(Time to First Token,TTFT)是衡量推理延迟体验最重要的单项指标,它决定了用户看到第一个字符之前需要等待多久。Apple Foundation Models 首次调用 TTFT 高达 10–19 秒,原因在于系统需要将模型权重从存储加载到神经网络加速器(ANE)的内存中,这个过程在跨应用共享的系统进程里完成,因此只需付出一次。ExecuTorch 则需要在应用自身进程内完成模型加载,每次冷启动应用都要重新加载约 5 秒。「tokens/s」代表模型在预填充(prefill)之后逐字生成的吞吐率,43 tokens/s 大致对应人类可以流畅阅读的显示速度,在移动端属于可接受区间。值得注意的是,模拟器与真机在 ANE 调用路径上存在根本差异,模拟器无法访问真实硬件加速单元,因此文中 ExecuTorch 的模拟器数据在真机上可能有较大偏差。
可用性标志不可信:要用真实调用去探活
实测中最有工程价值的一条教训是:不要信任引擎自报的 availability 标志。
在 iOS 26.3 模拟器里,apple.isAvailable() 返回了 true,但两轮共 30 次调用全部以 GenerationError error -1 失败。真正原因藏在模拟器日志里:模型目录没有资产(UnifiedAssetFramework Code=5000)。同一模型在 Mac 的 Swift 环境下(macOS 26.6)却能正常工作。
类似地,MLX 版本的模型下载了全部 1.18 GB 后却加载失败(Error::NotFound),因为 MLX 后端只链接进真机构建,模拟器 SDK 缺少所需的 Metal API。使用 .DEFAULT 变体就能避免——它只会选择真正链接进当前构建的后端。
所以作者在运行时模型选择器里内置了一个原则:用一次真实的「一个 token」调用去探活,并缓存结果,而不是依赖标志位或硬编码某个变体。选择顺序是固定的:Apple 模型(若真能用)→ 用户同意下载的本地模型 → 云端兜底。
要跑起来,先搞定七个「坑」
从发布博客看,端侧 AI「什么都能做」;但真正把一个 React Native 0.87 应用跑起来,作者踩了七个文档里找不到的坑,每一个都会卡住构建或运行:
- iOS 构建报
unknown type name 'RCTCxxBridge':RN 0.87 已移除,需打补丁改用RCTTurboModuleWithJSIBindings注入 JSI 绑定。 - CocoaPods 报部署目标过低:Podfile 里设
platform :ios, '17.0'。 - Metro 报 export namespace 问题:加
@babel/plugin-transform-export-namespace-from的 v7 版本。 - ExecuTorch 原生调用失败:加
react-native-worklets/plugin,放在 Babel 插件最后。 TextDecoder不存在:为 Hermes 补齐 AI SDK 所需的 polyfill。ai@latest装成 7.x:必须锁定ai@6,因为 RN 的 AI providers 实现的是 v6 规范。- npm 11 跳过 ExecuTorch 的 postinstall:阅读后手动批准,它会从项目 GitHub release 下载原生库。
还有两个隐蔽的「陷阱」尤其值得注意:适配器里构建流必须用全局的 globalThis.ReadableStream(AI SDK 会用全局类做校验);以及 ExecuTorch 0.10 默认会上报匿名下载分析数据,必须调用 setTelemetryEnabled(false) 关闭——如果你是为了隐私才选端侧 AI,这一点非常关键。
JSI(JavaScript Interface)是 React Native 新架构的核心桥接层,它允许 JavaScript 直接调用 C++ 对象而无需序列化,是 ExecuTorch 这类高性能原生模块实现低延迟推理的基础。RN 0.87 移除了旧版 RCTCxxBridge 后,原生模块需要改用 RCTTurboModuleWithJSIBindings 来注入 JSI 绑定,这属于新旧架构迁移期的常见兼容性问题。Hermes 是 Meta 专为 React Native 优化的 JavaScript 引擎,它在体积和启动时间上做了大量裁剪,代价是部分 Web 标准 API(如 TextDecoder)未被内置,需要手动添加 polyfill。react-native-worklets 是一个允许代码在独立 JS 运行时(worklet)中并发执行的库,ExecuTorch 依赖它将推理调用从主线程卸载,避免阻塞 UI;它的 Babel 插件必须排在最后,否则会与其他代码转换插件产生顺序冲突。
该怎么选:一张决策图
基于全部实测,作者给出的落地建议清晰可执行:
iOS 优先用 Apple Foundation Models:无需下载、不占应用内存、引导式生成让结构化输出可靠。唯一要做的是预热模型,避开那个慢吞吞的首次调用。
没有系统模型时用 ExecuTorch:适合短文本、由人阅读结果的自由文本任务(改写、建议、草稿)。要在动作前检查输出,下载 1 GB 前先询问用户并展示进度,关掉遥测,别指望 1B 模型产出 JSON。
始终保留云端兜底,并在 UI 上标注:如果用户是因为「文本不出手机」才选这个功能,那么当请求离开设备时(包括云端兜底,以及 iOS 27 走 Apple 的 Private Cloud Compute 时),要如实告知。
关注 expo-ai:它正在 Expo 仓库评审中,已带 Apple provider、流式和工具调用。一旦落地,上面那堆 setup 坑就会变成 Expo 的问题而不是你的。
至于 Android 的 Gemini Nano,作者因缺少支持的真机未能实测,但从文档看它遵循同样的模式——@react-native-ai/adk 也是一个 AI SDK provider,可作为 pickModel 里的又一个分支;考虑到 Apple 标志位的前车之鉴,仍建议加一个探活调用。ExecuTorch 在 Android 上通过 Vulkan 走 GPU,下载模型的分支可以直接复用。
写在最后
这份实测最大的价值,不在于「端侧 AI 行不行」的宏观结论,而在于它把每一个工程细节、每一个失败、每一组数据都公开摆出来(代码、原始结果和失败案例都在公开仓库里)。它提醒我们:发布博客告诉你「可能」,而真正动手才知道「代价」。对于正在评估 React Native 端侧 AI 的团队,这些带着 patch 和 benchmark 的一手经验,远比营销话术更有参考价值。
相关推荐

macOS 不再是 UNIX:苹果未续认证,技术本质未变
苹果未续订 macOS 的 UNIX 认证,Open Group 官方名单已移除苹果条目。本文分析认证到期背后的技术真相、苹果可能的意图,以及对开发者的实际影响。
用Azure Cosmos DB构建有状态多智能体系统
基于Azure Cosmos DB官方教程,解析如何用Agent Memory Toolkit为多智能体旅行规划器添加共享持久记忆,涵盖短期、长期、情景、语义四类记忆及跨会话状态延续机制。

生产环境AI Agent运维:观察、评估与优化三步框架
Azure Cosmos DB 团队提出生产环境 AI Agent 的运维三步框架:观察 trace 追踪、用 LLM as a judge 与回归测试做评估、从 RU、检索、记忆、LLM 四层优化成本。本文解析这套方法论的核心要点与适用边界。