用Azure Cosmos DB构建有状态多智能体系统
用Agent Memory Toolkit为多智能体系统在Azure Cosmos DB中构建共享持久记忆。
文章指出,多数AI应用默认没有持久记忆,用户重复输入导致信任流失,记忆应作为多智能体架构的一等公民而非事后补充。作者将智能体记忆拆为短期、长期、情景、语义四类,分别对应持久性与内容两套维度。以旅行规划器为例,研究、酒店、餐厅三个智能体并非互相传递消息,而是共同读写Agent Memory Toolkit中的单一事实源,实现上下文完整交接。用户以自然语言修正偏好时,变更写入长期记忆,所有下游智能体即时同步。文章强调,架构设计之初就需考虑记忆分类、共享与修正机制,才能让系统越用越懂用户。
用Azure Cosmos DB构建有状态多智能体系统
大多数AI应用默认没有持久记忆:用户周一告诉旅行规划器“我从不坐红眼航班”,周二回来时,系统依然推荐红眼航班。这不仅是体验问题,更是信任问题——用户会停止期待应用变得有用。在Azure Cosmos DB团队看来,记忆不是后期添加的功能,而是多智能体应用的基础架构。
本文基于Code with Azure Cosmos DB系列第三期内容,拆解如何用Agent Memory Toolkit为多智能体旅行规划器添加共享持久记忆,实现跨会话、跨智能体的状态连续性。
无记忆智能体的信任困境
Azure Cosmos DB产品经理Madeline Egan指出,默认情况下多数AI应用启动时没有持久记忆——没有偏好、没有历史、没有上下文。用户每次回来都面对一个空白 slate,需要重复交代相同信息。
这种设计缺陷在单轮对话中不明显,但在需要长期协作的场景(如旅行规划、项目管理、学习辅导)中迅速暴露。用户的耐心被重复输入消耗,对系统的信任也随之瓦解。更深层的问题在于:没有记忆,智能体无法从交互中学习,也就无法真正个性化。
智能体记忆的四种类型
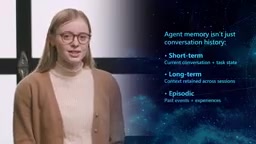
要把记忆做成架构的一等公民,首先需要区分记忆的维度。Madeline将智能体记忆拆解为四类:
- 短期记忆:当前交互或会话内可用的信息,如近期对话历史、当前意图、中间任务状态。
- 长期记忆:跨会话保留、可供未来交互使用的信息。
- 情景记忆:对具体事件或经历的长期记录,例如你过去的巴塞罗那之行,或在某家酒店的糟糕体验。
- 语义记忆:长期事实、偏好和泛化知识,例如“偏好精品酒店”这类从交互中推断出的结论。
这四类记忆共同构成系统对特定用户的结构化认知记录,使智能体能够个性化未来响应。有意思的是,短期记忆与长期记忆的划分依据是持久性,而情景与语义记忆的划分依据是内容性质——两套维度交叉,覆盖了智能体需要的全部记忆形态。
语义记忆与情景记忆的认知科学渊源
情景记忆与语义记忆的区分最早由认知心理学家Endel Tulving于1972年提出:情景记忆指向“何时何地发生了什么”的自传体经历,语义记忆则存储脱离具体时空的事实性知识。这一划分被引入智能体设计后,直接对应两类不同的数据建模需求——情景记忆通常需要时间戳、参与者、事件序列等字段,适合文档型存储;语义记忆更接近键值化的偏好标签,强调可检索与可更新。Azure Cosmos DB的灵活模式(schema-agnostic)恰好能同时承载两者:事件记录以嵌套JSON保存,偏好事实则以扁平字段供查询。开发者在设计记忆库时,应避免把两类记忆混在同一集合中,否则检索时的相关性排序会被噪声干扰。
多智能体共享记忆的实现机制
如果每个智能体各自维护记忆,系统会退化成多个孤岛,用户偏好无法一致传递。Agent Memory Toolkit的核心价值在于:为所有智能体提供统一的方式来存储、检索和更新Azure Cosmos DB中的记忆,无需每个应用从零搭建基础设施。
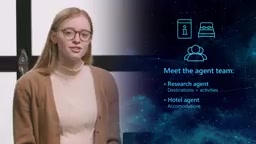
本期构建的旅行规划器包含三个专职智能体:研究智能体负责目的地与活动,酒店智能体负责住宿,餐厅智能体负责餐饮。三者都需要知道用户的相同信息。
当用户计划去巴塞罗那度长周末时,研究智能体开始拉取目的地、活动与街区信息,并将预算、旅行风格等偏好写入记忆库。其他智能体从同一记忆存储读取,立即掌握预算、日期和约束条件,开始收窄推荐范围。
智能体交接的本质是共享数据源
这里的“交接”不是智能体之间传递消息,而是所有智能体读取Agent Memory Toolkit中的单一事实源。酒店智能体读取研究智能体写入Azure Cosmos DB的全部内容,带着完整上下文接手工作。每个智能体各司其职,但共享同一幅用户画像。
这种设计避免了消息传递中的信息丢失和顺序依赖,也让新增智能体变得简单——只要接入同一记忆库,就能获得完整的用户上下文。
单一事实源与并发一致性
“单一事实源”(Single Source of Truth)是数据架构中的经典原则:任何数据只有一个权威副本,其他位置均为派生或缓存。在多智能体场景中,这一原则的真正挑战不在读取,而在并发写入——当研究智能体、酒店智能体几乎同时更新同一用户的预算约束时,若各自持有内存副本,就会产生写冲突与不一致。Agent Memory Toolkit依托Azure Cosmos DB的乐观并发控制(ETag机制)和可调一致性级别来化解这一问题:写入时携带版本标记,冲突则重试或合并。开发者需要为记忆条目设计合理的分区键(通常以用户ID分区),既保证同一用户的写入串行化,又让不同用户的记忆分布到不同物理分区以实现水平扩展。
跨会话状态延续与偏好更新
用户关闭应用、第二天回来时,系统不会从空白开始。Azure Cosmos DB保存了上次对话的全部内容,以及持久化的用户偏好、交互历史和其他长期上下文。
如果用户想修改此前告知应用的信息,只需用自然语言说明。当用户明确纠正或更新偏好时,变更会写入长期记忆,所有下游智能体立即看到最新信息。这一机制的关键在于:偏好更新不是覆盖某个智能体的本地状态,而是更新共享事实源,从而保证整个系统的一致性。
记忆生命周期与遗忘机制
持久记忆并非“保存得越多越好”。随着会话累积,记忆库会膨胀,检索延迟上升,过期或矛盾的旧偏好还会污染推荐结果。因此生产级记忆系统需要显式的生命周期管理:为每条记忆标注来源(用户显式陈述、系统推断、对话摘要)、置信度与时间戳,并在检索时按新鲜度和置信度加权。常见策略包括按TTL自动过期临时上下文、对语义记忆做冲突检测(新偏好与旧偏好矛盾时标记待确认)、以及定期将冗长的情景记忆压缩为摘要。这一层设计与文章强调的“用户显式修正”相辅相成:显式修正应获得最高置信度并立即覆盖推断值,而推断值则需在多次强化后才可沉淀为长期事实。
记忆优先的架构启示
这期内容传递的核心观点是:记忆不是可以日后补上的功能,而是多智能体应用的基础。Agent Memory Toolkit简化了Azure Cosmos DB中持久共享记忆的实现,让每种记忆类型都能跨多个智能体共享,并贯穿每个新会话。
对于正在构建AI应用的开发者,这意味着架构设计阶段就需要考虑:记忆如何分类、如何在智能体间共享、如何支持用户显式修正。把记忆当作一等公民,多智能体系统才能从“每次重新开始”走向“越用越懂你”。
下一期将进入生产环境,关注智能体行为的可观测性、结果验证与故障排查——那将是记忆架构之上的另一层关键能力。
相关推荐

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。