ReAct模式拆解:手搓AI Agent的实战指南

用天气查询案例拆解 ReAct 模式,讲清 LLM 决策、工具执行与循环终止的完整机制。
文章以一位海外博主的实战视频为线索,系统拆解了 AI Agent 的核心模式 ReAct(推理与行动)。ReAct 的本质是:LLM 负责判断是否需要调用工具、调用哪个工具,开发者负责执行工具并把结果返回给模型,如此循环直到任务完成。文章通过一个天气查询实验对比了"裸 LLM"与"工具增强 Agent"的差异——前者只能说"我查不了",后者能自主提取城市参数、调用 API 并总结出人类可读的回答。文章还讲解了多工具路由、状态管理、无限循环风险及调用上限设置,并强调先手搓理解底层机制、再迁移到 LangChain 等框架的学习路径。
大模型能回答问题,却查不了实时天气、订不了酒店、搜不了网页。这个能力缺口正是AI Agent要解决的核心问题。一位海外博主在B站发布的实战视频中,用ReAct模式从零拆解了Agent的构建逻辑,并用一个天气查询案例完整演示了从"裸LLM"到"工具增强Agent"的进化过程。
什么是ReAct模式
ReAct是Reason and Act的缩写,即"推理与行动"。据该博主在视频中的解释,这是构建AI Agent最核心的概念——LLM负责推理该调用哪个API或做出什么决策,开发者负责执行这些决策,结果再返回给LLM进行下一轮推理。这个循环不断重复,直到任务完成。
LangChain官方文档对此的定义更为简洁:"Agent就是一个在循环中调用工具的模型。"你发送请求给模型,模型可以访问多个工具并自主决定调用哪个,开发者执行工具调用,结果反馈给模型,如此循环直到获得满意结果。模型是大脑,工具是手脚,开发者是连接两者的桥梁。
ReAct 的学术来源:ReAct 模式最早由 Shunyu Yao 等人在 2022 年发表于 arXiv 的论文《ReAct: Synergizing Reasoning and Acting in Language Models》中提出。论文指出,传统 LLM 只做链式推理(Chain-of-Thought),容易产生事实幻觉;而只做行动(Action)又缺乏规划能力。ReAct 的核心创新是让模型交替生成"思考(Thought)"与"行动(Action)",并在每次行动后接收"观察(Observation)"作为新的上下文,从而把推理轨迹与外部工具的真实反馈绑定在一起。这一范式被后续的 AutoGPT、LangChain Agent 以及各家大模型的 Function Calling 能力广泛吸收,可以被视为现代 AI Agent 的奠基性设计之一。
Function Calling 与 ReAct 的关系:OpenAI 在 2023 年推出 Function Calling 后,LLM 能够以结构化 JSON 输出"要调用哪个函数、传什么参数",本质上是把 ReAct 中"Action"这一步标准化了。文章中的 tools 参数即是这一机制在 API 层面的体现。
从裸LLM到工具增强:一个天气查询实验
没有工具时:LLM的"无能为力"
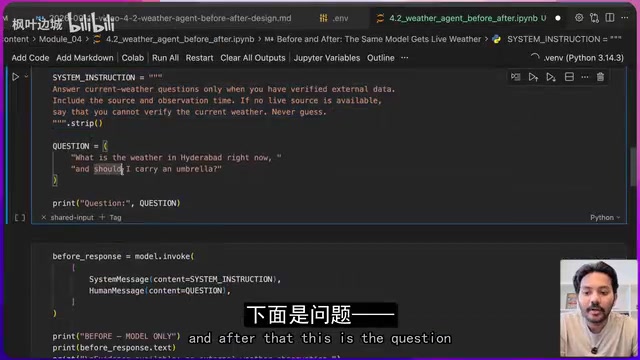
视频中的演示从最基础的情况开始。博主向GPT模型提问:"海得拉巴现在天气如何?我应该带伞吗?"没有任何工具加持的LLM给出了典型的回复——"我无法获取实时天气数据,请查看当前天气服务。"这清楚地暴露了纯API调用的局限性:模型只能依赖训练数据中的知识,对实时信息完全无能为力。
加上工具后:Agent开始"自己动手"
博主随后定义了一个Python函数,通过Open Weather API获取实时天气数据。关键的一步在于:当这个函数作为tools参数传给LLM时,它就从普通函数变成了Agent可以调用的"工具"。
再次提出同样的问题后,LLM的行为发生了根本变化。它不再说"我做不到",而是自主决定调用get_current_weather工具,自动提取城市参数为"Hyderabad",执行工具获取数据,最后将原始数据总结为人类可读的回答:"海得拉巴目前阴天,约25.8度,湿度较高,风力轻微。目前没有下雨,但考虑到阴天和高湿度……"
博主随后将城市改为伦敦,Agent同样自主完成了整个流程——识别城市变化、调用工具、返回结果。正如博主在视频中强调的:"我没有做任何事情,Agent在做每一件事。"
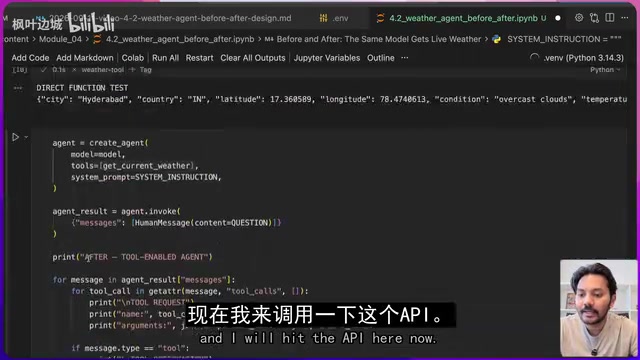
工具描述(Tool Schema)为什么重要:把 Python 函数交给 LLM 时,模型看到的不是函数体,而是函数的名称、参数说明和 docstring。这份"说明书"决定了 LLM 能否在正确场景下选中它、能否正确填充参数。例如 get_current_weather(city: str) 的 docstring 若写明"获取指定城市的实时天气",模型才能把"海得拉巴天气如何"映射为 city="Hyderabad"。因此写好工具描述、避免功能重叠、参数命名语义化,是 Agent 能否稳定工作的关键工程细节,也是实际开发中最容易踩坑的地方。
工具的本质
值得一提的是,博主特别指出:"工具本质上就是一个普通的Python函数,没什么特别的。"它可以调用API、执行计算、操作数据库——任何你能用Python实现的功能,都可以封装成工具交给Agent调用。
ReAct循环的内部机制
博主用流程图的方式拆解了ReAct循环的完整运作逻辑。
当用户发送一个prompt后,LLM首先判断:能否直接回答这个问题?如果可以,直接输出结果,流程结束。如果不行,LLM会审视自己有哪些可用工具,然后决定调用哪个。
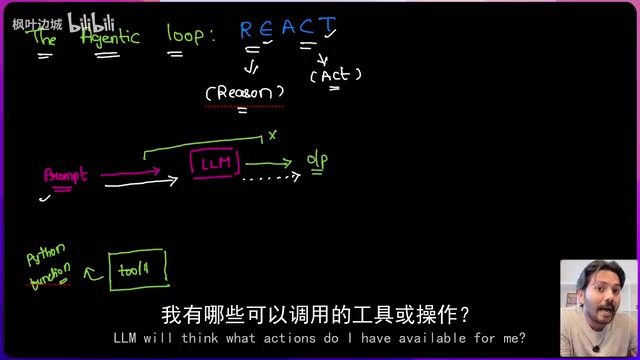
以天气工具为例:Agent决定调用该工具,开发者执行函数获取海得拉巴的天气数据,输出结果返回给LLM。LLM接下来会验证这个输出是否足以回答用户的原始问题。如果足够,总结后输出最终答案;如果不够,再次调用工具,产生新的输出,再次验证——这个"推理-行动-观察"的循环会持续到LLM判断任务完成为止。
Observation 的上下文膨胀问题:每轮工具调用返回的结果都会追加进对话历史,作为下一轮推理的输入。当工具返回大段原始数据(如整页网页 HTML、长 JSON)时,上下文会迅速膨胀,既推高 token 成本,也可能稀释关键信息,导致 LLM 判断失误。常见的缓解手段包括:在工具内部做结果裁剪与摘要、只保留最近若干轮 Observation、或引入独立的"压缩"步骤。这些优化在文章演示的单轮天气场景中并不明显,但在 Google 搜索、数据库查询等真实多轮 Agent 中几乎是必需配置。
多工具场景与状态管理
真实场景中,Agent通常需要多个工具协同工作。博主在视频中列举了四种典型工具:天气查询、酒店预订、Google搜索和图像生成。
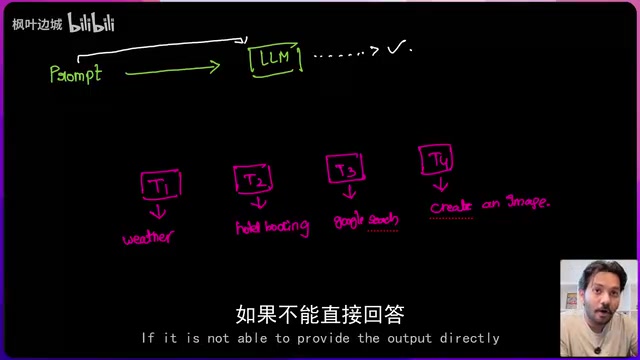
当LLM面对多个工具时,它会根据用户问题的性质选择路由:搜索类问题走向Google搜索工具,图像需求走向图像生成工具,预订需求走向酒店预订工具。每种工具的调用结果都会返回给LLM。
这里引入了一个关键概念——状态(State)。当Agent同时调用多个API时,它需要追踪每个调用的状态和输出,综合所有结果后才能生成最终的整合回答。博主强调:LLM在这里扮演的是"大脑"角色——决定调用哪个工具、如何整合多路输出,最终生成统一答案。
开发者必须关注的陷阱:无限循环
ReAct循环并非没有风险。博主在视频中特别提醒:当LLM反复调用同一个工具却始终得不到满意结果时,可能陷入死循环,甚至永远无法退出。
应对策略是设置调用上限。开发者需要预设同一工具的最大调用次数——比如5次或10次。博主给出的理由很实际:"如果调用同一个工具10次都没能得到输出,第11次也不会有什么不同。"
为什么先手搓再上框架
视频最后,博主阐明了自己的教学理念:"我不想直接在LangChain框架里教Agent。我希望你们先理解内部发生了什么,一步一步来,然后再适配框架。"
这个思路值得借鉴。LangChain等框架确实能大幅简化Agent开发,但如果开发者不理解ReAct循环的底层逻辑——LLM如何决策、工具如何执行、状态如何管理、循环如何终止——在使用框架遇到问题时将无从排查。从手搓一个天气Agent开始,逐步理解prompt、tools、tool call、observation、state等每个环节的作用,再迁移到框架,才是真正掌握Agent开发能力的路径。
ReAct模式的精髓可以归纳为一句话:让LLM做它最擅长的事(推理和决策),让代码做LLM做不到的事(执行和行动),两者在循环中协作直到任务完成。
手搓与框架的取舍:从零实现 ReAct 循环只需要几十行代码——维护一个消息列表,循环调用 LLM,遇到 tool_call 就本地执行并把结果拼回消息,直到模型返回普通文本。而 LangChain、LlamaIndex、AutoGen 等框架在此之上提供了工具注册、记忆持久化、多 Agent 编排、可观测性等能力,代价是抽象层变多、出错时堆栈难以追踪。业界普遍经验是:先用裸代码跑通最小闭环,理解每一步的数据长什么样,再根据项目复杂度决定是否引入框架;对于需要人机协作、多工具并行或生产级监控的场景,框架的收益会明显大于其学习成本。
相关推荐

强化学习通关《抡大锤》:63%进度背后的分布式训练策略
开发者用深度强化学习挑战《抡大锤》,智能体从底部攀爬至63%进度,卡在铁砧部分。项目开源,采用分治训练和CPU训练策略,寻求社区协作突破瓶颈。

AAAI 2027二审放榜在即:社区热议评审公平与投稿生态
AAAI 2027第二阶段评审结果即将公布,Reddit社区热议评审一致性与流程透明度。本文梳理放榜前的社区情绪、顶会评审的结构性矛盾,以及作者应对二审结果的务实策略。

Sigma FP2发布:全球最小全画幅相机迎来传感器与屏幕升级
Sigma发布FP2全画幅相机,延续全球最小最轻设计,带来改进型传感器、翻转LCD屏和更长续航三大升级,专为便携视频创作者打造,补齐初代fp的体验短板。