Reddit热议:模型性价比榜单是“神作”还是“ propaganda”?
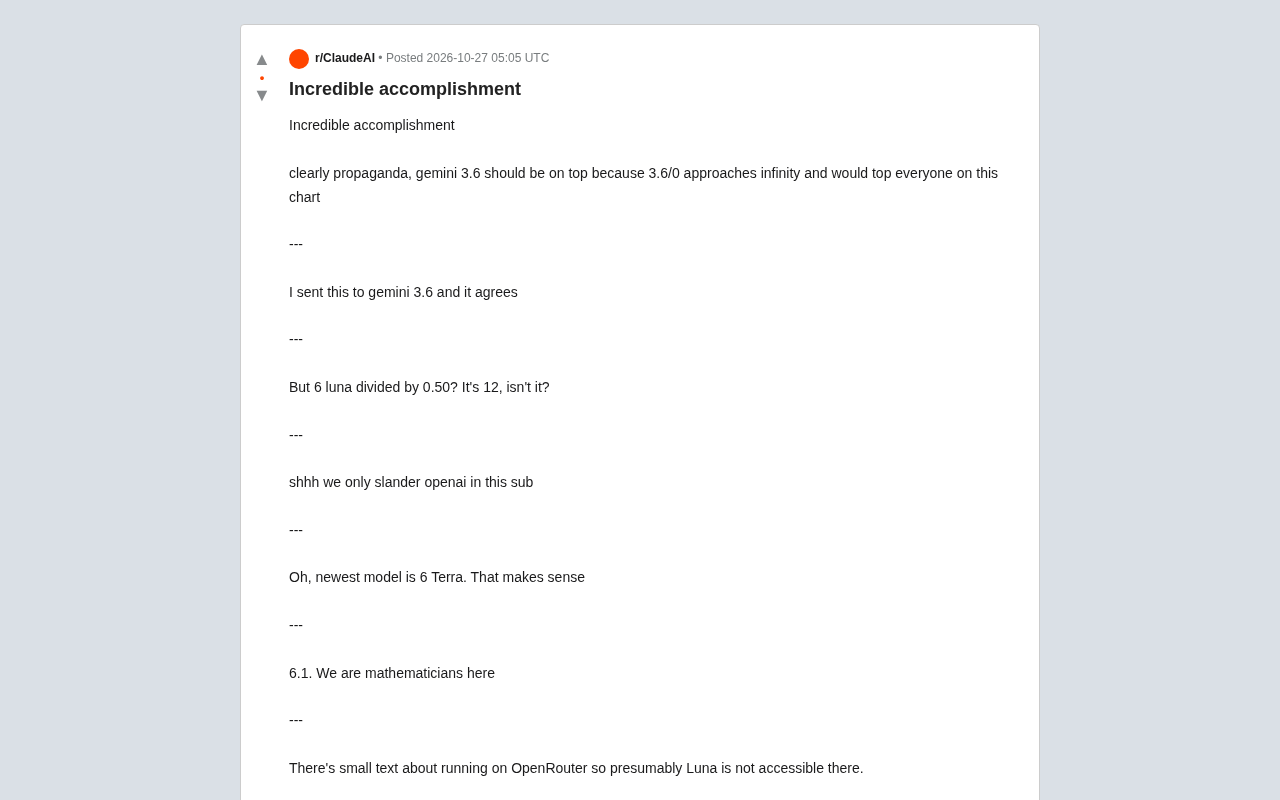
Reddit 群嘲模型性价比榜单,揭示指标定义不清与可比性缺陷。
一张据称来自 Reddit 的模型性价比排名图引发社区群嘲:用户用“3.6/0 趋近无穷大”反讽榜单指标定义不清,围绕“6 Luna 除以 0.50 等于几”展开数学梗狂欢,并调侃该 sub“只黑 OpenAI”。玩笑背后是对 AI 榜单方法论的集体不信任。少数认真评论指出两处硬伤:图表数据基于 OpenRouter,部分模型在该平台可能不可用,可比性存疑;榜单未覆盖 100k 以上上下文场景,存在误导性,且发布方未作回应。文章最终建议开发者回到自身场景,以实际压测而非榜单作为选型依据。
一张模型性价比图表在 Reddit 引发群嘲。用户调侃 Gemini 3.6 的“无限性价比”、争论 6 Luna 除以 0.50 究竟等于几,还不忘补一句:“这个 sub 只黑 OpenAI。”玩笑背后,是社区对 AI 榜单方法论的集体不信任。
一张图表引发的数学狂欢
原帖标题只有一句“Incredible accomplishment”,配图据称是某模型性价比排名。评论区很快跑偏:有人宣称 Gemini 3.6 才该登顶,理由是“3.6/0 趋近于无穷大”,按这个算法能秒杀全榜;有人接力说自己把这话发给了 Gemini 3.6,“它也表示同意”。
这种反讽指向一个真问题:榜单的分子分母定义不清,所谓“性价比”就只是个修辞。当“每美元多少模型编号”这种指标被拿来排序,评论区直接破防:“Most model number per dollar?这到底是什么意思?我们是不是彻底完了?”
“只黑 OpenAI”与命名梗
有用户提醒“小声点,这个 sub 只允许诽谤 OpenAI”,半开玩笑地揭示了社区立场对榜单解读的干扰。另一条支线则围绕命名展开:有人一本正经地算出 6 Luna 除以 0.50 等于 12,有人接话“最新模型是 6 Terra,这就说得通了”,还有人纠正“是 6.1,我们是数学家”。
这些梗说明,当模型版本号本身缺乏语义时,任何以编号为变量的指标都容易被解构成段子。榜单想传递的“技术进步”信号,在传播中被娱乐化消解。
被忽略的前提:OpenRouter 与上下文长度
少数认真讨论的评论指出了两个硬伤。其一,图中小字注明数据基于 OpenRouter,这意味着 Luna 等模型在该平台可能根本不可用,榜单的可比性存疑。其二,有人直接质问“超过 100k 上下文呢?这张图有误导性”——性价比若只按短上下文定价计算,就无法反映长上下文场景下的真实成本。
据 Reddit 用户在原帖中的交叉讨论,这两点质疑并未得到图表发布方的回应。社区共识更倾向于:榜单可以看,但不能当作选型唯一依据。
OpenRouter 是什么:OpenRouter 是一个聚合型 API 网关,开发者用一套统一接口即可调用多家厂商的模型,平台按 token 计费并在不同供应商之间路由请求。它的定价往往与实际厂商官网价格存在差异,且是否上架某个模型取决于供应商授权与平台策略,因此以 OpenRouter 数据构建的性价比榜单只反映“在该平台上可买到的那部分模型”,并非全市场横截面。
上下文长度为何影响性价比:大模型的定价通常按输入/输出 token 分别计价,且长上下文常触发阶梯定价或额外缓存成本。当上下文扩展到 100k 甚至更长时,单位 token 价格、显存占用与推理延迟都会变化,短上下文下的“每美元性能”结论无法直接外推。评估性价比时应明确标注测试所用的上下文区间。
对开发者的实际启示
与其争论“每美元几个模型编号”,不如回到自己的场景:任务需要多长上下文、调用频次多少、是否依赖特定平台可用性。榜单是营销物料,压测才是决策依据。Reddit 这场狂欢的真正价值,不在于谁该登顶,而在于提醒所有人——看不懂分子分母的排名,先当段子看。
如何自己做一次可信的性价比评估:先固定任务与评测集(如真实业务 prompt 采样 100–500 条),再在目标平台上测量三项指标——单次调用成本(输入+输出 token 实际计费)、端到端延迟(P50/P95)、任务通过率或人工评分。用“通过率 ÷ 单次成本”得到任务级性价比,比笼统的编号除法更有意义。同时记录上下文长度分布,对长上下文场景单独做一组压测,避免被短上下文榜单误导。
相关推荐
核战真能终结文明吗?科学解析常见误区
核战争会终结文明吗?本文基于核武器物理机制,解析爆炸、辐射尘与城市火灾的真实影响,区分空爆与地爆、剂量与污染,说明为何核战是巨大灾难却非文明终结,并探讨打击后社会重建的关键因素。

泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。

74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。