认知奖励形态:运动如何塑造你的职业思维
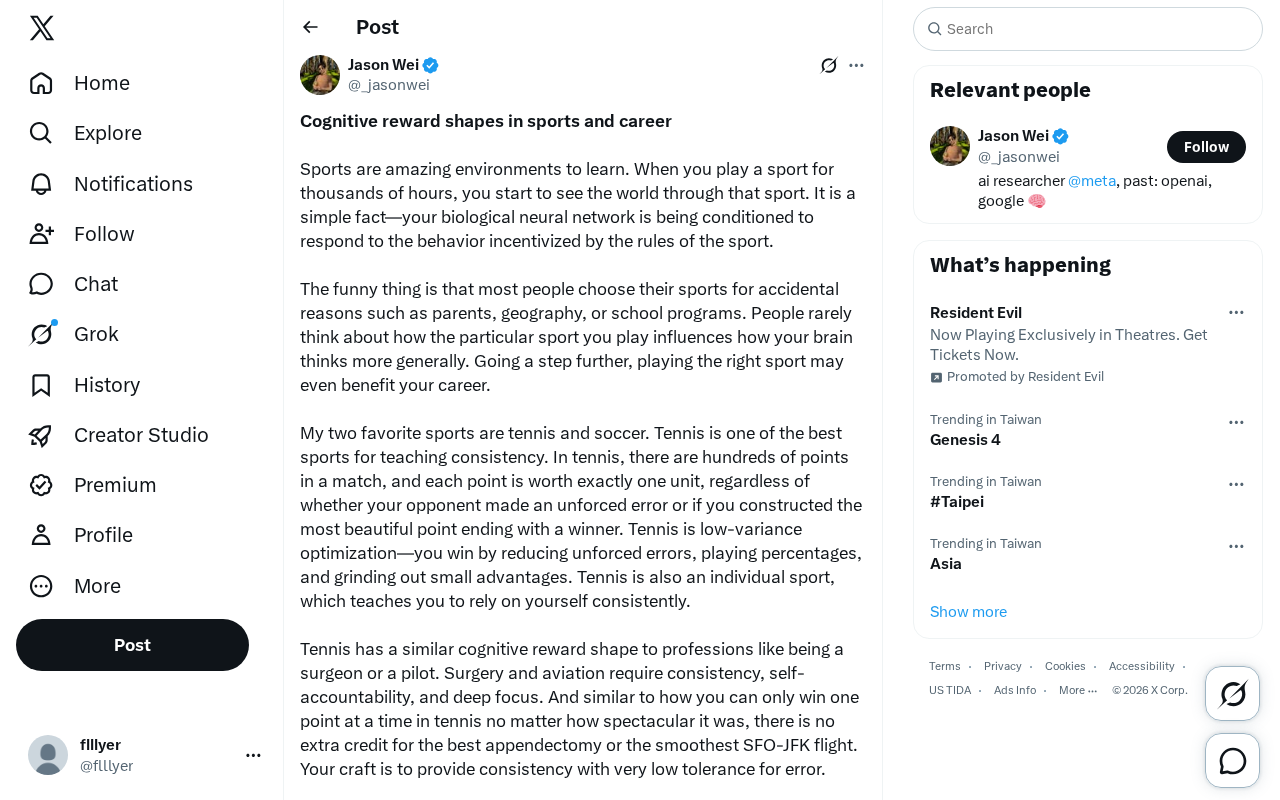
运动的规则激励结构会悄悄塑造你的风险直觉,选对运动可能是一种被忽视的职业认知训练。
文章提出一个反直觉的视角:长期从事某项运动,会通过其内置的奖惩规则反复条件化你的神经网络,进而塑造你对风险、失败与回报的本能判断。以网球为例,其"低方差优化"的本质——依靠减少失误而非追求极致来取胜——与外科医生、飞行员等要求极致一致性和低容错的职业高度匹配,却与创业所需的"拥抱失败、下注非对称回报"的心理模式存在根本冲突。相比之下,足球前锋的经历——大量触球最终无果、但少数瞬间决定比赛命运——与创业的奖励形态更为契合。文章的核心判断是:当你所练运动的认知奖励形态与你所从事职业的成功逻辑相吻合时,会产生可观的迁移价值;而这正是大多数人在选择运动时完全没有考虑过的维度。
运动是被低估的认知训练场
当你在一项运动上投入数千小时后,会逐渐开始用这项运动的视角看待世界。这并非玄学——你的生物神经网络正在被这项运动规则所激励的行为方式所塑造和条件化。运动员反复响应特定的胜负结构,久而久之,这种响应模式会内化为一种更普遍的思维习惯。
有意思的是,绝大多数人选择运动项目往往出于偶然:父母的安排、成长地域的传统、或者学校恰好开设了什么课程。很少有人认真想过,自己练的这项运动会如何长期影响大脑的思考方式。而如果把这个逻辑再推进一步——选对运动,甚至可能对职业发展产生实质性的帮助。
网球:低方差优化的思维范式
网球是训练"一致性"的最佳运动之一。一场比赛有数百个分数,每一分的价值都严格相等——无论这一分是对手的非受迫性失误送的,还是你打出一记极致漂亮的制胜球赢下的,它们都只值一分。
这决定了网球的本质是低方差优化:你通过减少非受迫性失误、打概率球、一点点磨出微小优势来取胜。同时,网球是个人项目,它教会你在任何时候都持续依靠自己。
这种认知奖励形态,与外科医生、飞行员这类职业高度相似。外科手术和航空飞行都要求极致的一致性、强烈的自我问责意识和深度专注。就像网球里再精彩的一分也只算一分一样,做出全院最漂亮的阑尾切除手术没有额外加分,飞出最平稳的旧金山到纽约航班也不会有额外奖励。你的技艺核心,是在极低容错率下持续稳定地交付。
低方差优化是概率论与决策论中的一个概念,指在期望收益相近时,优先选择结果波动更小、更可预测的策略路径。在网球语境里,这意味着职业球员大约60%-70%的得分来自对手的非受迫性失误,而非自身的制胜球——这一统计数据在ATP/WTA巡回赛中长期成立。因此,顶级球员的核心策略不是追求每拍极限发挥,而是把自己的失误率压到最低,同时通过持续施压迫使对手犯错。这种策略在认知层面会形成强烈的"规避损失优先"直觉:与其冒险博一个漂亮的穿越球,不如打一个更保险的中路深区球。长期训练会让大脑对"高风险高回报"的选项产生本能的警惕,即使理性上知道胜率还不错,身体和判断力也会倾向于保守选项。
为什么网球思维不适合创业
网球心态向创业的迁移价值相对有限。创业是一个高方差、团队协作、且容忍失败的游戏,偶发的创造力会得到指数级的回报。
在网球里拼命减少非受迫性失误,与在创业中判断是否要下一个大概率会失败、但一旦成功可能带来十亿美元回报的"登月式"决策——这是两种完全不同的思维模式。这里并不是说网球运动员当不了优秀的创业者,而是说两者背后的认知奖励结构截然不同。
足球前锋:拥抱失败与非对称回报
相比之下,足球前锋的奖励形态与创业要接近得多。一名前锋学到的核心,是创造大量微小的机会。
事实是,一场比赛的绝大部分时间里,你都不在进球——即便回看姆巴佩状态最好的比赛,他大多数触球最终都没能转化成任何结果。但真正重要的是,你只要创造出足够多的机会,抓住其中一两次进球,就能赢下比赛。
把一场90分钟的比赛拆解到前锋视角:几乎所有时间都是失败或噪音,只有几分钟具备真正的杠杆效应,而最终决定比赛命运的往往只是那几秒钟。这种长期浸泡在"失败为常态、少数瞬间定乾坤"结构里的经历,会训练一个人坦然面对失败,并习惯于非对称回报——而这恰恰是创业最需要的心理素质。
足球前锋的进球转化率数据可以为这种"失败为常态"的直觉提供量化支撑。顶级前锋每场比赛平均触球次数约为30-50次,而射门次数通常为2-4次,最终进球期望值(xG)往往不足1。即便是世界顶级射手,单赛季的射门转化率也很少超过20%。这意味着一名前锋80%以上的"尝试"以失败告终,却依然被视为成功执行了任务。这与行为经济学中"损失厌恶"的默认心理倾向直接对抗——大多数人在心理上对失败的痛苦感受约是同等收益带来的愉悦感的2倍(卡尼曼与特沃斯基的前景理论),而前锋的训练在某种程度上是对这种心理偏误的系统性矫正。
选对运动,是在训练你的风险直觉
核心观点在于:当你所练运动的认知奖励形态,与你职业的奖励形态相吻合时,可能产生可观的价值。
这里当然存在一些为了说明问题而做的挑选式论证。创业本身也需要一致性和规避错误的能力;足球里守门员的奖励形态又和前锋完全不同——守门员的一次失误可能直接葬送比赛,这反而更接近网球那种低容错逻辑。
但主线论点依然成立:如果运动确实在塑造我们如何感知风险、努力与回报,那么我们就应该更审慎地选择它。运动不只是消遣或健身,它是在悄悄给你的神经网络喂什么样的"训练数据"。理解这一点,或许能让你更有意识地去选择——无论是为孩子,还是为自己。
认知迁移(cognitive transfer)是教育心理学中描述一种情境下习得的思维模式向另一情境延伸的现象。研究表明,迁移效果最强的条件是两个领域在"深层结构"上(即奖惩逻辑、反馈机制、决策节奏)高度相似,而非表面内容相似。这也解释了为何这里的类比以"奖励形态"为核心维度,而非以运动的体能要求或协作形式。值得注意的是,这种迁移并非自动发生——大量研究同样表明,未经反思的重复经历往往只会强化特定领域的直觉,而不会自动泛化。真正产生迁移价值的,往往是那些能够有意识地将运动经历与职业决策逻辑进行映射和反思的人。
写在最后
这个"认知奖励形态"的框架提供了一个有趣的视角,去审视个人经历与职业适配之间的隐性联系。它本质上是一种类比推理:把运动规则的激励结构,映射到不同职业的成功逻辑上。
虽然作者坦承其中有选择性举例,但这个思路的价值在于提醒我们——我们长期投入精力的活动,会在潜移默化中重塑我们对风险与回报的本能判断。这对于自我认知、职业规划乃至团队用人,都是一个值得思考的切入点。
相关推荐
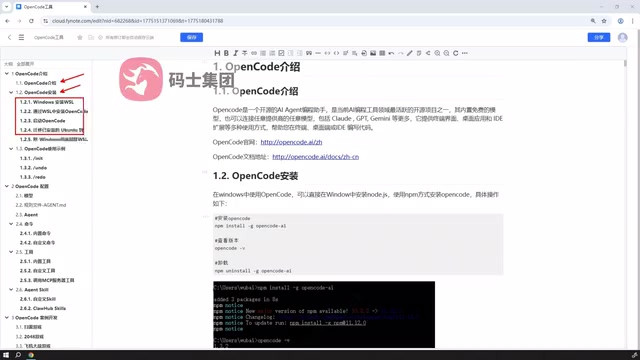
OpenCode 入门到实战全攻略:AI编程工具安装与配置指南
OpenCode 是一款开源 AI 编程工具。本文梳理其入门到实战全流程:桌面端与 WSL 两种安装方式、模型与规则配置、Agent 分类、自定义命令工具、MCP 服务集成及 SQL 复用,助你系统上手 OpenCode。
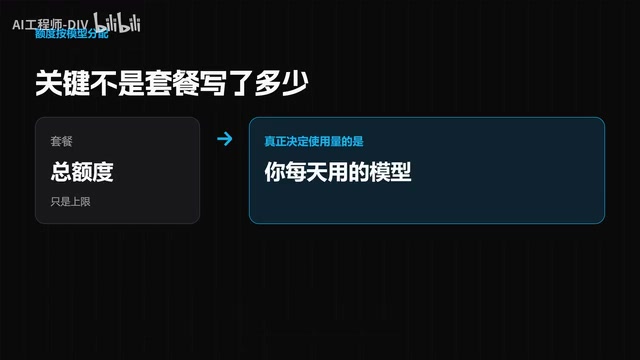
10美元AI编程套餐怎么选?Go与Code额度对比拆解
DeepSeek涨价后,10美元AI编程套餐Go和Code怎么选?本文按Mimo、千问、DeepSeek V4、Kimi等常用模型逐一对比两家额度,揭示总额度背后的选购逻辑与请求次数口径陷阱。
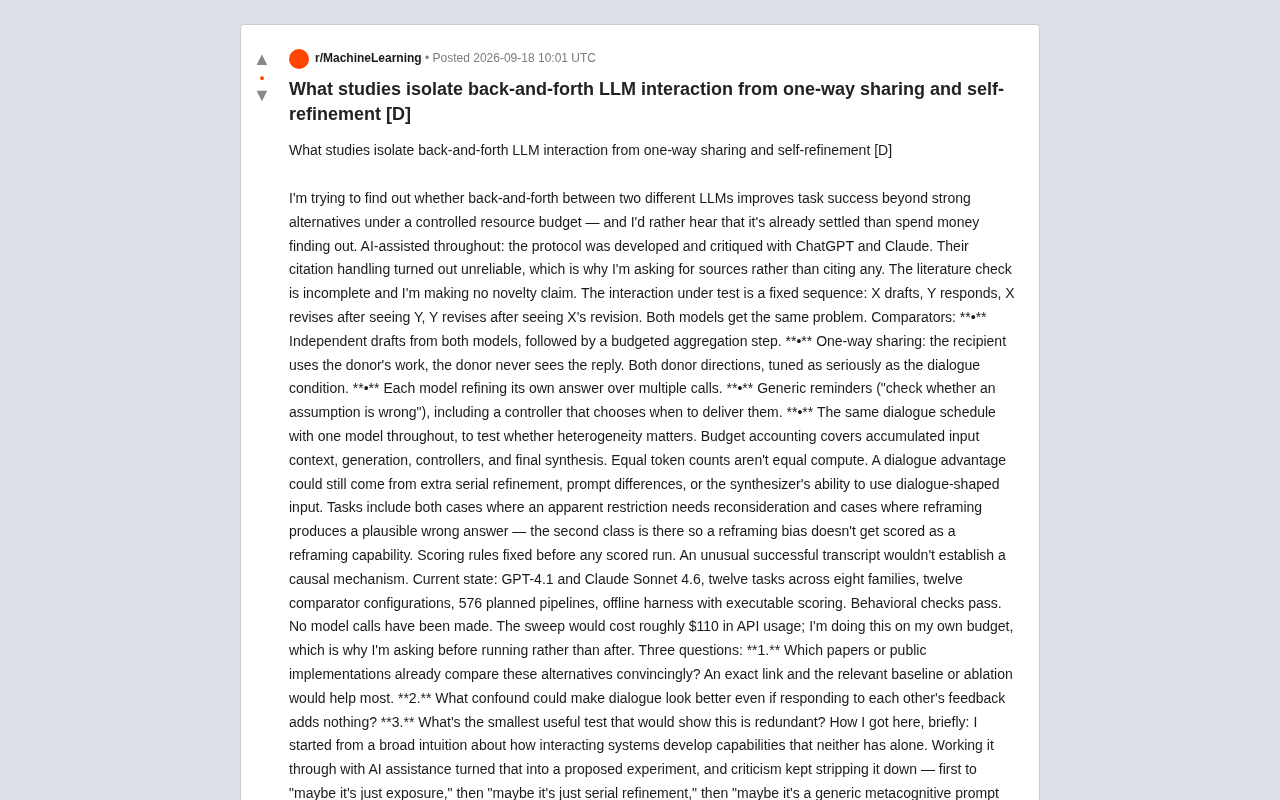
多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
一位研究者设计了一套严谨的对照实验,试图隔离多LLM来回对话与单向共享、自我精炼等机制的真实增益。本文解析其实验设计、预算核算与三个开放问题,为多智能体研究提供参考。