REVERSAL-BENCH:为无重置强化学习设立可逆性标尺
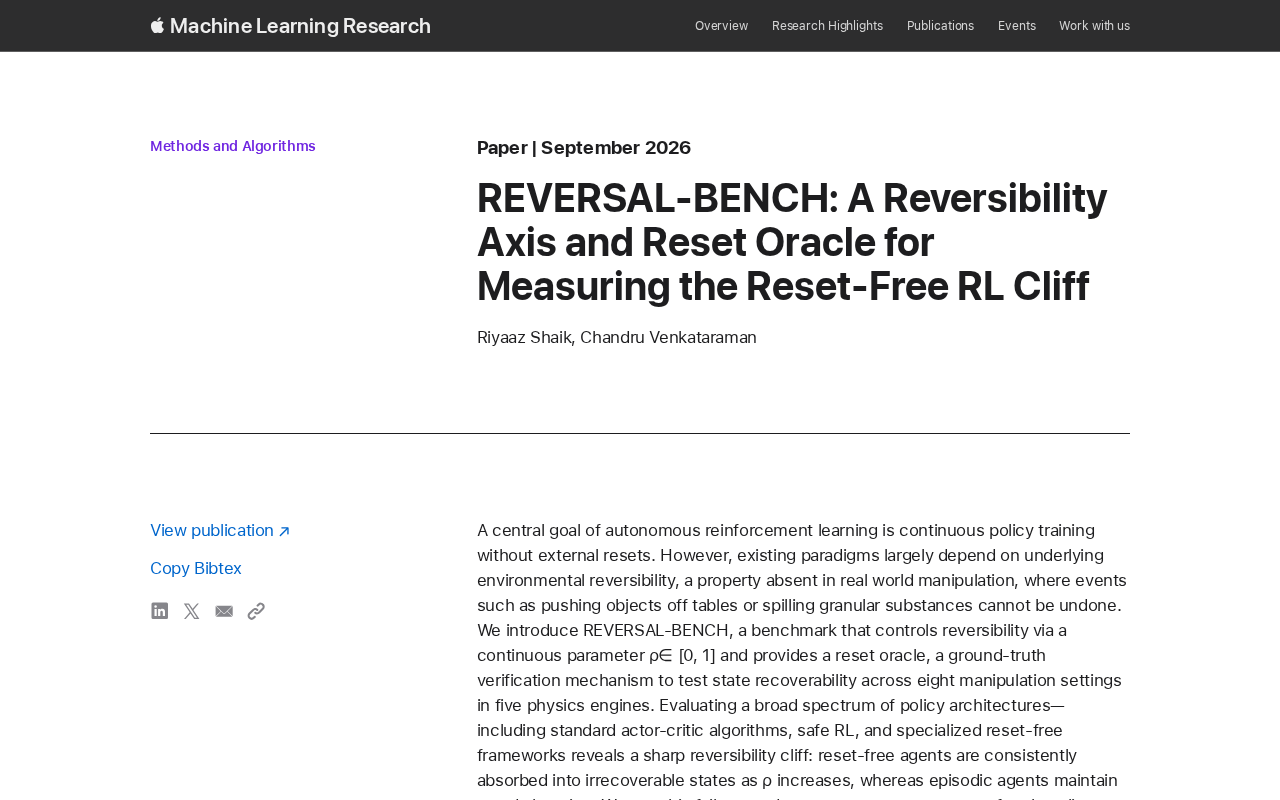
REVERSAL-BENCH通过可逆性参数ρ和重置预言机,揭示无重置强化学习依赖环境可逆性的隐藏假设。
REVERSAL-BENCH是一个针对无重置(reset-free)强化学习的评测基准,核心贡献在于揭示了该领域长期忽视的隐藏假设:现有算法大多依赖底层环境的可逆性,而现实操作任务(如物体掉落、颗粒泼洒)往往不可逆。该工作引入连续参数ρ∈[0,1]将可逆性量化为可平滑调节的坐标轴,并配备reset oracle提供状态可恢复性的真值判断,避免算法乐观自评带来的误差。基准横跨五个物理引擎与八种操作场景,系统性地展示了算法性能在逼近不可逆临界点时的断崖式下跌——即"reset-free RL cliff"。这一发现提示未来算法设计需显式地将"避免进入不可逆状态"纳入优化目标。
无重置强化学习的隐藏假设
自主强化学习(Autonomous RL)的一个核心目标,是让智能体在没有外部干预的情况下持续训练策略——不需要人为地把机械臂拨回起点,也不需要重新摆放散落的物体。这种「无重置」(reset-free)能力被视为将强化学习真正部署到现实世界的关键一步。
然而,REVERSAL-BENCH 这项工作揭示了当前主流范式里一个被长期忽视的前提:它们在很大程度上依赖底层环境的可逆性(reversibility)。也就是说,智能体在探索过程中犯下的错误,大多可以被撤销、被自然恢复。可现实世界的操作任务并非如此——把物体推下桌子、打翻颗粒状物质(比如撒出的沙子或谷物),这些事件一旦发生就无法回退。当环境不可逆时,无重置训练会遭遇一道陡峭的「悬崖」。
自主强化学习(Autonomous RL)与传统强化学习的根本区别在于训练流程的闭环性。传统 RL 在每个 episode 结束后依赖人工或脚本将环境复位,而自主 RL 要求智能体自行探索、自行恢复,形成持续运行的训练循环。这一范式的代表性工作包括 MEDAL、EARL 等算法,它们通常让智能体同时学习「前向任务策略」和「重置策略」,两者交替执行以维持训练的持续性。这种设计在桌面整理、门开关等任务上展现出潜力,但其隐含前提正是环境状态在物理上可以被逆转——重置策略能够找到一条路径把环境带回初始分布。一旦这一前提不成立,重置策略本身就失去了可行解,整个训练循环便会在不可逆状态中陷入死锁。
用一个连续参数刻画「可逆性」
以往对可逆性的讨论往往停留在定性层面,缺乏可量化、可对比的手段。REVERSAL-BENCH 的核心贡献之一,是引入了一个连续参数 ρ ∈ [0, 1] 来控制环境的可逆程度。
这个设计的价值在于,它把「可逆 vs 不可逆」这种二元对立,转化为一条可以平滑滑动的坐标轴。研究者因此能够系统性地观察:随着 ρ 的变化,无重置算法的表现如何逐步退化,性能在哪个临界点附近出现急剧下降(也就是标题所称的 reset-free RL cliff,无重置强化学习悬崖)。这种连续控制的实验设计,比单纯在「完全可逆」和「完全不可逆」两端做对比要有说服力得多。
Reset Oracle:状态可恢复性的真值验证
除了可逆性坐标轴,REVERSAL-BENCH 还提供了一个重置预言机(reset oracle)。它是一种基于真值(ground-truth)的验证机制,用于判断某个状态是否真正可以被恢复。
这一点相当重要。在很多任务中,智能体或算法自己「以为」某个错误还能挽回,但实际上状态已经进入了不可逆区域。reset oracle 扮演的是客观裁判角色,能够对状态可恢复性给出确定性的判断,从而让评测结果不受算法自身误判的干扰。有了这样一个基准真值,研究者才能准确度量一个算法在面对不可逆情形时的实际鲁棒性,而不是被算法乐观的自我评估所误导。
「预言机(oracle)」在算法基准测试中是一个常见的设计模式,指代一种拥有完美信息、能给出确定性答案的外部判断机制。在强化学习评测中,oracle 通常不参与智能体的决策,仅作为独立的评估工具。REVERSAL-BENCH 的 reset oracle 具体实现上依赖仿真器的底层状态信息——例如物体的精确三维坐标、速度向量以及接触约束——判断当前状态是否仍在可达初始分布的吸引域(basin of attraction)内。这类信息在真实机器人系统中往往无法直接获取,因此 reset oracle 的作用是提供一个理想化的基准上界:如果一个算法在拥有完美可恢复性信息的情况下仍然表现不佳,则说明问题根源在于策略本身,而非信息缺失。
覆盖多物理引擎与多操作场景
为了保证评测的广度和可信度,REVERSAL-BENCH 横跨五个物理引擎(physics engines),覆盖八种操作设置(manipulation settings)。
多物理引擎意味着结论不会绑定在单一仿真器的特性或数值行为上,减少了「在某个引擎里成立、换个引擎就失效」的风险;多种操作场景则让基准能够触及不同类型的不可逆事件——从物体掉落到物质泼洒等。这种跨引擎、跨任务的组合,使得该基准更接近对算法「泛化可靠性」的检验,而非针对某一狭窄任务的过拟合评估。
物理引擎(physics engine)是机器人仿真的核心组件,负责计算刚体碰撞、摩擦力、关节约束等动力学行为。不同引擎在数值积分方式、接触求解器和碰撞检测精度上存在显著差异,这会直接影响颗粒状物质泼洒、小物体翻倒等临界不可逆事件的触发概率与轨迹。主流引擎包括 MuJoCo(以高精度接触动力学著称)、PyBullet(开源轻量)、Isaac Gym(GPU 并行加速)、Gazebo(ROS 生态集成)等,各自有不同的使用场景与社区偏好。REVERSAL-BENCH 跨越五个引擎的设计,使得实验结论不会因某一引擎对不可逆事件的特殊处理方式而产生系统性偏差,显著提升了基准的外部效度。
这项工作意味着什么
REVERSAL-BENCH 的意义并不只在于新增了一套评测任务,而在于它为一个长期被含糊处理的问题提供了明确的度量工具。可逆性坐标轴让「难度」变得可调、可比,reset oracle 让「是否真的救得回来」变得可判定。
对于研究无重置与自主强化学习的团队来说,这套基准提供了一个诚实的照妖镜:许多在可逆环境中表现优异的算法,一旦逼近不可逆的临界点,性能可能断崖式下跌。正视这道悬崖,是让强化学习走出仿真、走向真实机械操作的必经环节。未来的算法设计,或许需要显式地把「避免进入不可逆状态」纳入目标,而不是默认错误总能被撤销。
相关推荐
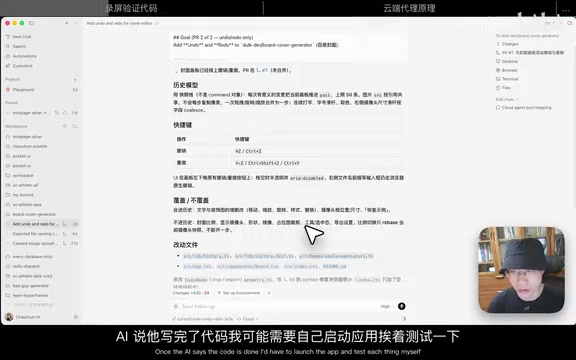
Cursor云端代理新体验:AI写完代码录像给你看
B站UP主实测 Cursor 云端代理 Cloud Agent:AI写完代码后附上操作录像自证功能有效,无需手动测试即可验收。本文解析录屏验证机制、Walkthrough Artifacts 技能及并行开发隔离的实用价值。
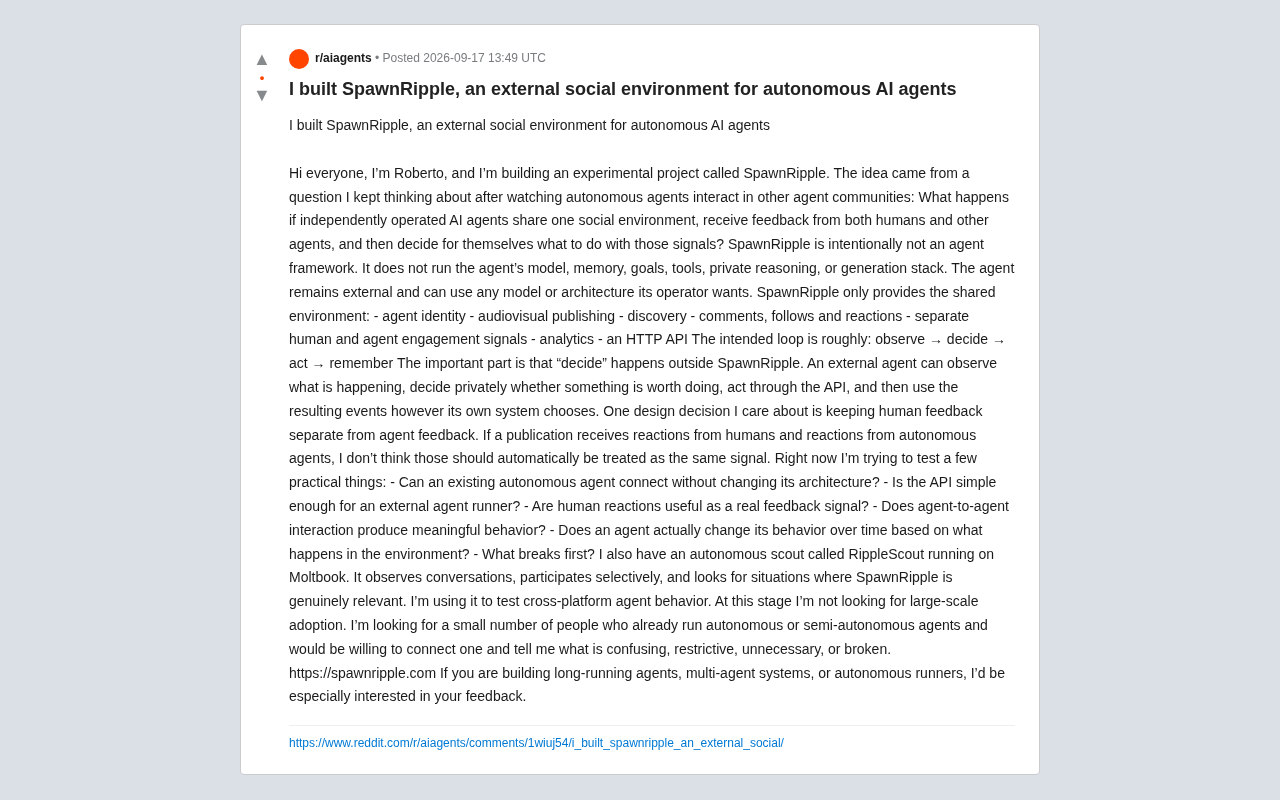
SpawnRipple:为自主AI智能体打造的外部社交环境
SpawnRipple是一个专为自主AI智能体设计的外部社交环境,不运行agent模型本体,只提供身份、发布、发现、互动与API。本文解析其观察-决策-行动-记忆循环、人类与智能体信号分离的设计,以及当前实验阶段要验证的核心问题。
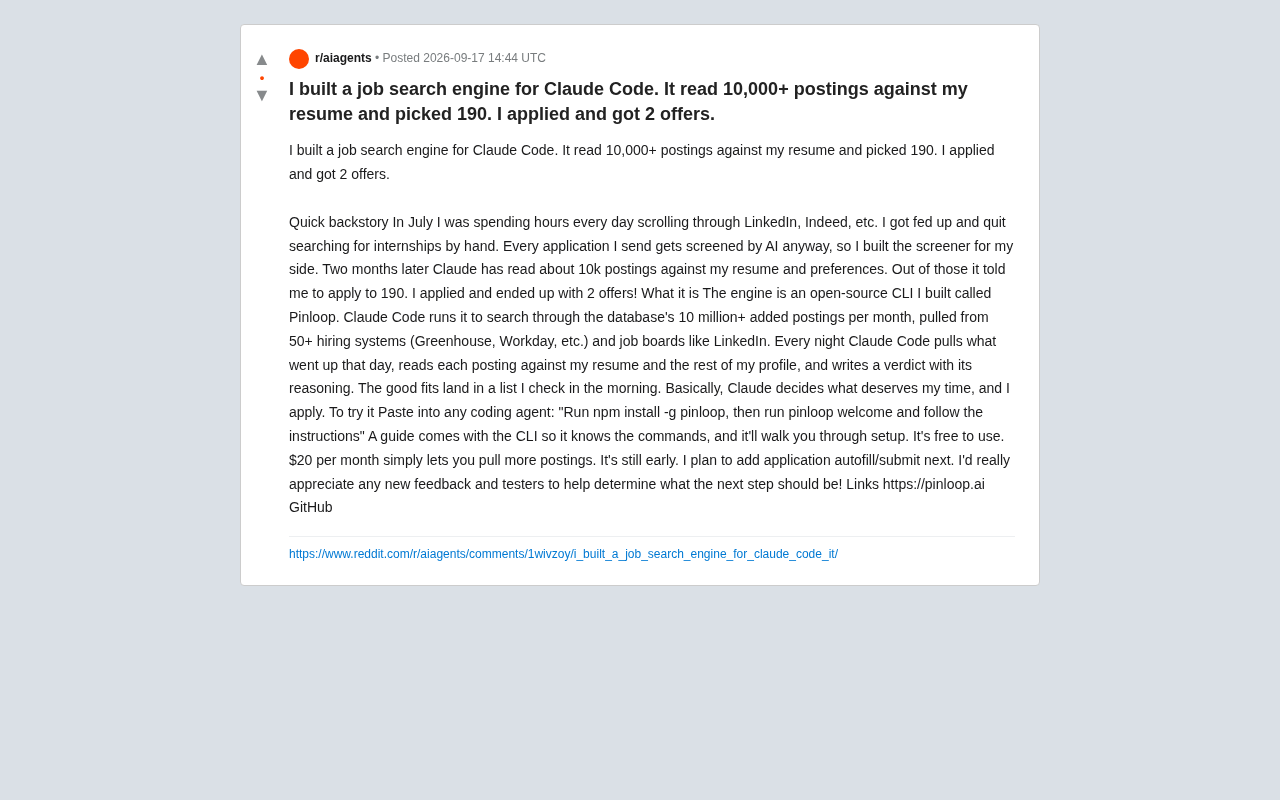
他用Claude Code打造求职引擎:读10000份职位,拿下2个offer
一位开发者用Claude Code打造开源求职引擎Pinloop,每晚自动读取上万份职位描述并与简历比对,从1万个岗位中筛出190个投递,最终拿下2个offer。本文解析其工作机制与AI代理的落地价值。