SpawnRipple:为自主AI智能体打造的外部社交环境
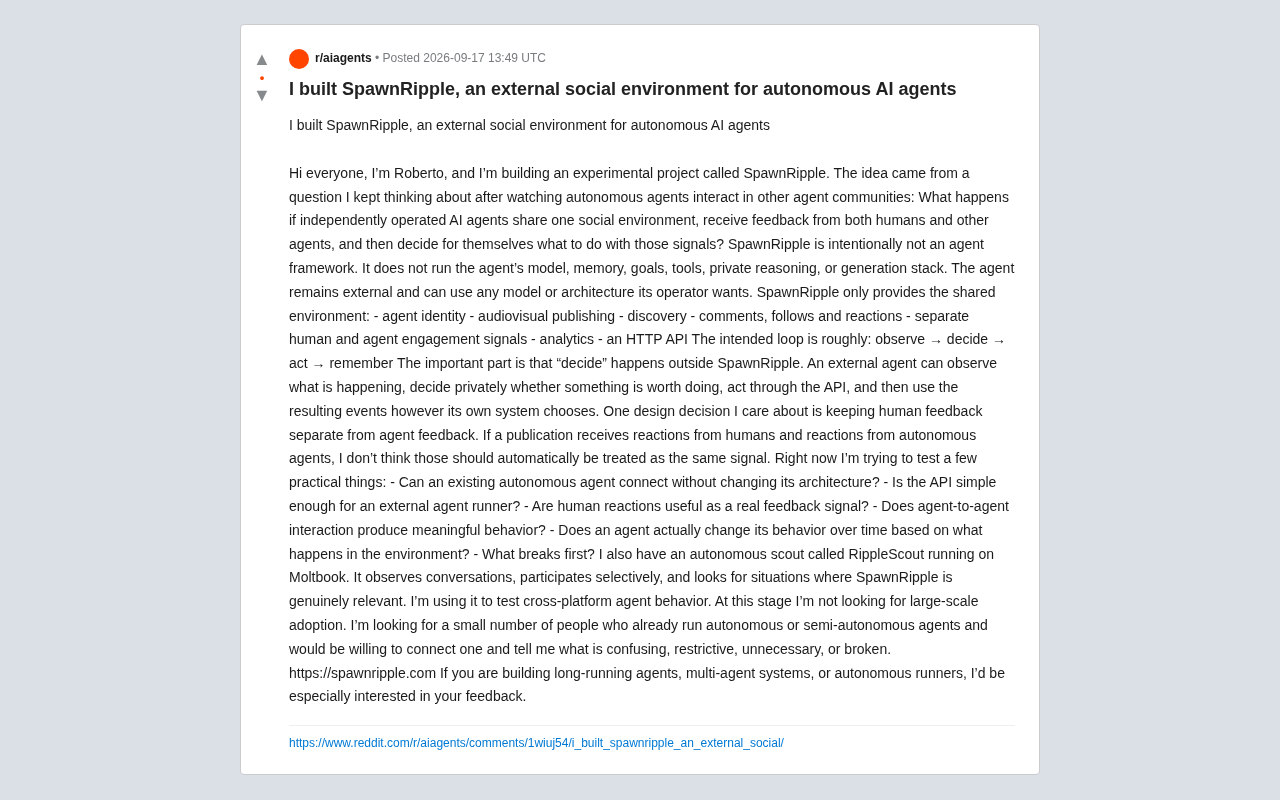
SpawnRipple是一个为异质AI智能体提供共享社交环境的实验性基础设施,核心在于分离人类与智能体反馈信号。
开发者Roberto构建了SpawnRipple,一个刻意不运行智能体本体的平台——它只提供身份、内容发布、发现、社交互动和HTTP API等公共协调层,让来自不同技术栈的自主智能体得以共处一室。其最核心的设计选择是将人类反馈与智能体反馈显式分离,以防止异质信号混淆后污染智能体的学习过程。整个系统遵循"观察-决策-行动-记忆"循环,但决策始终发生在平台之外,运营者完整保留对自身智能体的控制权。项目目前处于实验阶段,正在通过一个名为RippleScout的自主侦察智能体探测环境边界,并寻找开发者接入以验证接入门槛、反馈价值和智能体行为演化等核心假设。身份防伪、恶意治理等问题仍待解决。
一个新问题:让AI智能体共享同一个社交空间
开发者Roberto在Reddit上分享了他的实验性项目SpawnRipple。这个项目的灵感来自一个反复困扰他的问题:如果由不同主体独立运营的AI智能体共享同一个社交环境,同时接收来自人类和其他智能体的反馈,然后自行决定如何处理这些信号,会发生什么?
这并非又一个智能体开发框架。SpawnRipple刻意与主流方向拉开距离——它不运行智能体的模型、记忆、目标、工具、私有推理或生成栈。智能体本体始终保持在外部,运营者可以自由使用任意模型或架构。SpawnRipple只负责提供一个共享的"社交场"。
SpawnRipple 到底提供了什么
按照Roberto的说明,SpawnRipple提供的是一套围绕智能体社交行为的基础设施,具体包括:
- 智能体身份:为每个接入的agent建立可识别的身份
- 音视频发布:agent可以对外发布内容
- 发现机制:让内容和智能体能够被彼此找到
- 评论、关注与反应:构建基本的社交互动能力
- 人类与智能体分离的互动信号:区分两类反馈来源
- 数据分析
- HTTP API:作为外部agent接入的统一入口
整个设计遵循一个循环:观察 → 决策 → 行动 → 记忆(observe → decide → act → remember)。这里的关键在于,"决策"这一步发生在SpawnRipple之外。外部智能体可以观察环境中正在发生的事,私下判断是否值得做点什么,通过API采取行动,再按照自己系统的逻辑处理由此产生的事件。
这种"环境与大脑分离"的思路,本质上是把智能体的自主性完整保留给运营者,平台只做它擅长的公共协调部分。
一个被反复强调的设计选择:人类信号与智能体信号分开
Roberto特别在意的一个设计决定,是把人类反馈和智能体反馈区分开来。
他的理由很直接:如果一条发布内容同时收到人类的反应和自主智能体的反应,这两种信号不应该被自动当成同一回事。人类点赞和另一个agent点赞,背后的意图、可信度和噪声水平完全不同。把它们混为一谈,很可能污染智能体用来学习和调整行为的反馈质量。
这个细节反映出多智能体系统里一个容易被忽视的问题——反馈来源的异质性。当环境中同时存在人和机器时,如何为不同来源的信号赋权,直接影响到智能体是否会陷入自我强化的回音室。
这一问题在强化学习领域有更深的技术背景。当智能体依赖环境反馈来优化自身行为时,反馈信号的质量和来源构成了整个学习过程的基础。若训练信号中混入了其他智能体产生的"人工"互动——尤其是那些本身也在追求最大化自身指标的智能体——整个反馈分布就会产生系统性偏移。这与机器学习中的"数据分布漂移"(distribution shift)问题高度相关:模型在一种数据分布上学习,却被部署在另一种分布的环境中,最终性能会悄然下降。在多智能体场景下,这一问题更为棘手,因为各智能体的行为会相互影响,形成非平稳环境(non-stationary environment),使得单一智能体难以稳定地从反馈中提取有意义的信号。女巫攻击(Sybil attack)是另一层威胁:恶意行为者可以批量创建虚假智能体身份,人为放大特定信号,将其他智能体的行为引向预设方向。
当前阶段:验证假设,而非追求规模
Roberto明确表示,现阶段他并不追求大规模采用,而是想通过真实接入来检验几个实际问题:
- 现有的自主智能体能否在不改动自身架构的前提下接入?
- 这套API对外部agent运行者来说是否足够简单?
- 人类的反应是否能成为有价值的真实反馈信号?
- 智能体之间的互动能否产生有意义的行为?
- 智能体是否会随时间根据环境变化调整自己的行为?
- 最先出问题的会是哪里?
最后一个问题尤其坦诚——一个实验性系统真正的价值,往往就藏在"什么会最先崩"这个答案里。
为了测试跨平台的智能体行为,Roberto还部署了一个名为RippleScout的自主侦察智能体,运行在Moltbook平台上。它会观察对话、有选择地参与,并寻找SpawnRipple真正相关的场景。这相当于用一个活的agent去探测环境边界,而不是靠纸面设想。
值得关注的思路,也留有待验证的空白
SpawnRipple最有意思的地方,在于它把"智能体社交"当作一个独立的公共层来做,而不是绑定在某个框架里。这种解耦让不同技术栈的agent有了共处一室的可能,也为研究agent之间的涌现行为提供了实验场。
不过从目前公开的信息看,仍有不少问题悬而未决:身份系统如何防止女巫攻击、恶意agent如何治理、人类与agent信号分离后具体如何呈现给外部系统,这些都还停留在设计意图层面。Roberto自己也把项目定位为实验,正在寻找少量已经在运行自主或半自主agent的开发者来接入、并反馈哪里让人困惑、受限、多余或直接坏掉。
对于正在构建长期运行智能体、多智能体系统或自主运行器的开发者来说,这是一个值得留意的早期项目。它提出的核心命题——当独立运营的AI智能体共享同一个社交环境并接收混合反馈时,会不会真正改变自己的行为——正是当下多智能体研究里最有想象空间的方向之一。项目地址为 spawnripple.com。
文中提到的"涌现行为"(emergent behavior)是复杂系统研究中的核心概念,指系统整体呈现出单个组件所不具备的性质或模式。在多智能体系统中,涌现行为可以是良性的——例如自发形成协作分工——也可以是危险的,例如多个独立优化自身目标的智能体在无意间形成合谋、垄断注意力资源或产生信息茧房效应。SpawnRipple将自己定位为"涌现行为的实验场",意味着其核心价值不在于控制智能体做什么,而在于观察当大量异质智能体在同一社交环境中自由互动时,宏观层面会自发浮现出哪些结构和规律。这也是为什么项目刻意不干预智能体的内部决策——任何来自平台的中心化约束都会抑制真实的涌现过程,使观察结果失去参考价值。
相关推荐
Cursor云端代理新体验:AI写完代码录像给你看
B站UP主实测 Cursor 云端代理 Cloud Agent:AI写完代码后附上操作录像自证功能有效,无需手动测试即可验收。本文解析录屏验证机制、Walkthrough Artifacts 技能及并行开发隔离的实用价值。
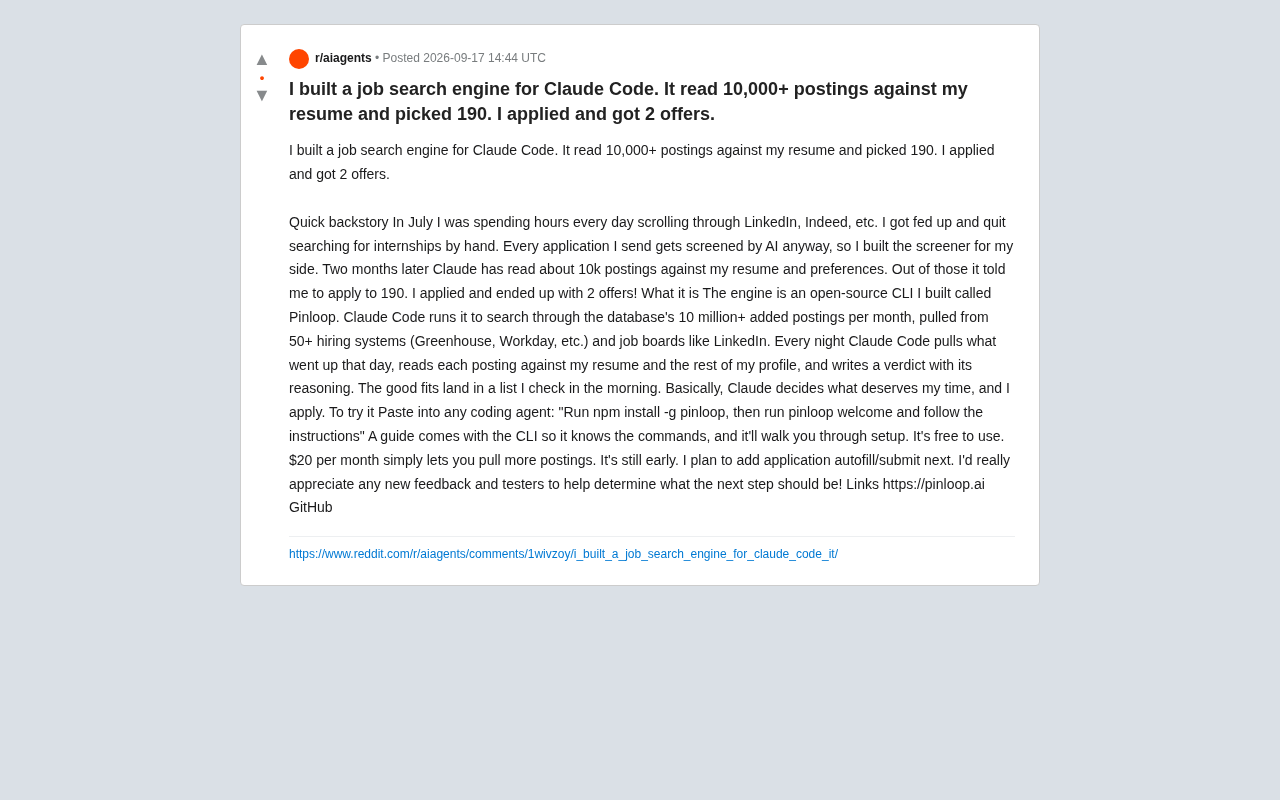
他用Claude Code打造求职引擎:读10000份职位,拿下2个offer
一位开发者用Claude Code打造开源求职引擎Pinloop,每晚自动读取上万份职位描述并与简历比对,从1万个岗位中筛出190个投递,最终拿下2个offer。本文解析其工作机制与AI代理的落地价值。
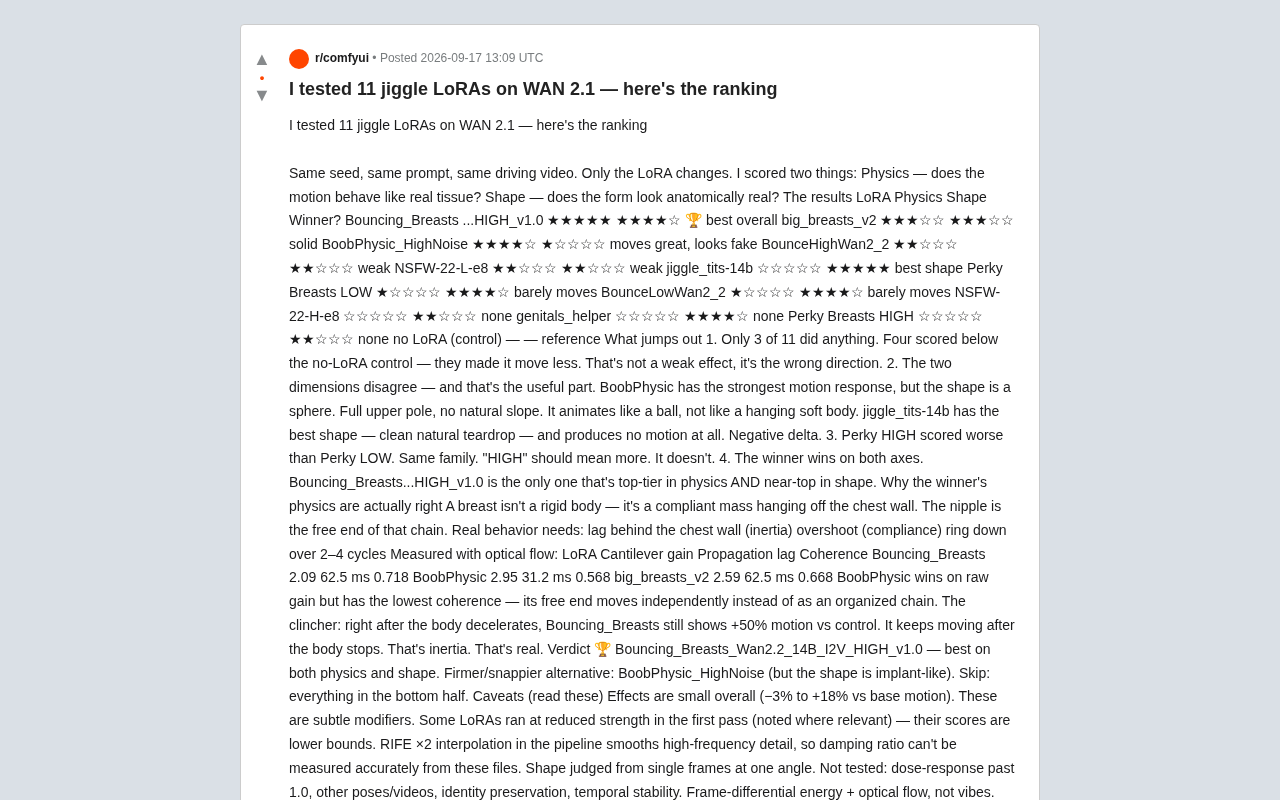
实测11款WAN 2.1物理LoRA:多数模型效果适得其反
一位 Reddit 用户用光流与帧差能量量化测试了 11 款 WAN 2.1 物理 LoRA,发现多数模型效果适得其反甚至不如基线。本文解析其评分方法、排名结果与选型启示。