日常使用AI,恰恰最需要最强模型

前沿模型真正的价值在于处理普通人模糊的日常指令,而非高难度专业任务。
文章挑战了“日常用轻量模型、专业任务用前沿模型”的流行观点。作者指出,前沿模型的“聪明”体现在处理模糊、含混的指令——而这正是普通人使用AI的常态。指令越具体,所需智能越低;专家能用轻量模型是因为他们能精确定义每一步。更关键的是,轻量模型会自信地给出错误答案,普通用户难以分辨。由于99%的AI用户是普通人,他们用模糊语言提问且缺乏验证能力,因此日常场景反而更需要最强模型。模型选择应基于指令模糊程度和用户验证答案的能力,而非任务听起来是否专业。
一个反直觉的判断
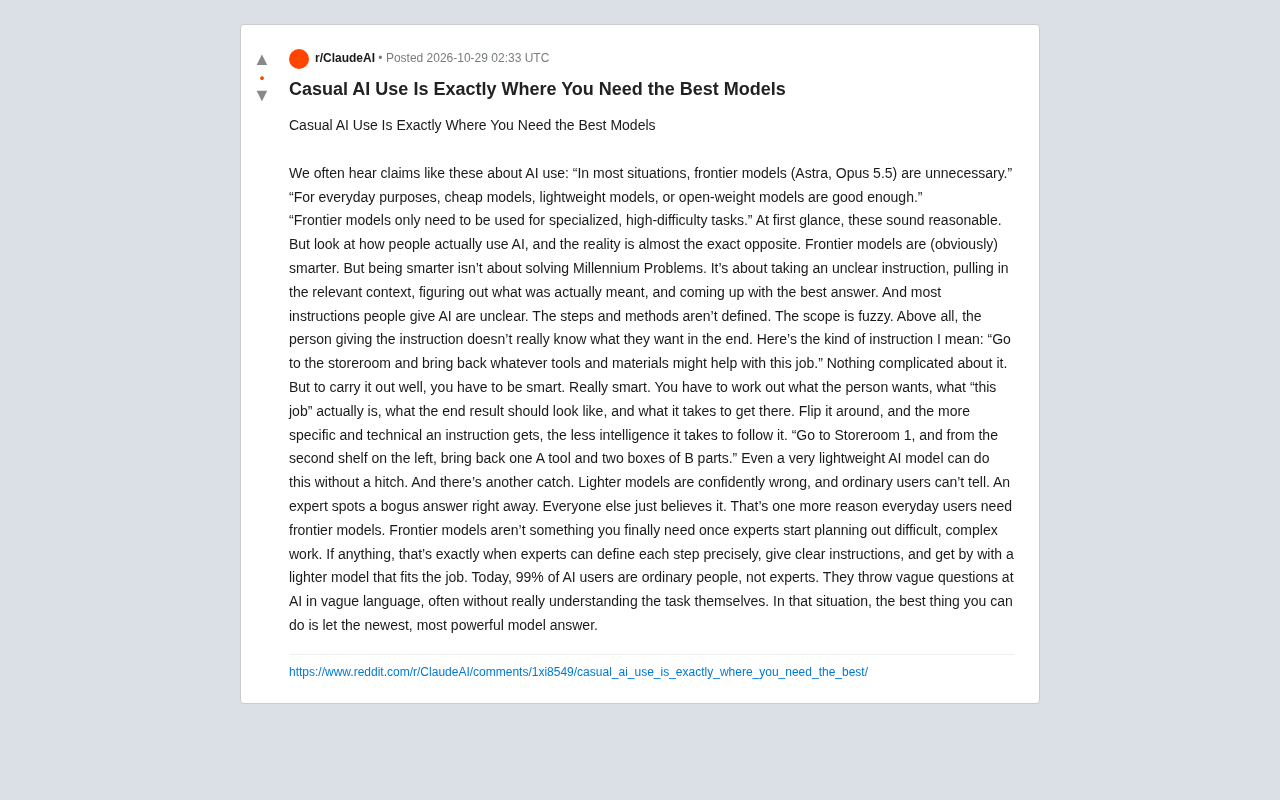
关于AI模型的选择,流行着这样几种说法:多数场景下用不上前沿模型;日常用途用便宜、轻量或开源权重模型就足够了;前沿模型只该留给高难度的专业任务。这些说法听起来很合理,但据Reddit上的一篇讨论,现实几乎完全相反。作者的核心论点是:前沿模型更聪明,而所谓“聪明”并不是用来解千禧年大奖难题的,而是用来处理那些模糊、含混、连提需求的人自己都没想清楚的指令——而这恰恰是普通人使用AI的常态。
模糊指令才是真正的难题
原文用了一个很形象的例子来说明指令的模糊程度与所需智能之间的关系。
“去储藏室,把可能对这个活儿有用的工具和材料拿回来。”这句话本身不复杂,但要把它做好,执行者必须足够聪明:得推断出对方到底想要什么、“这个活儿”具体指什么、最终结果应该是什么样、以及怎样才能达成。
反过来,指令越具体、越技术化,执行它所需要的智能反而越低。“去1号储藏室,从左数第二层货架上拿一个A工具和两盒B零件。”这样一条指令,即便是一个很轻量的AI模型也能毫无障碍地完成。
这个类比揭示了一个被忽视的事实:任务的“难度”和指令的“清晰度”是两个维度。专家之所以能用轻量模型,恰恰是因为他们能把每一步定义清楚、给出明确指令;而普通人给出的往往是范围模糊、目标不明的请求。
原文中“指令的清晰度”与“智能需求”的类比,实际上触及了自然语言处理中一个核心概念:指令歧义(instruction ambiguity)。歧义可以出现在词汇层(“工具”指什么)、句法层(“可能的”修饰范围)和语用层(说话人的真实意图)。大语言模型在处理这类指令时,需要依赖其内部的世界知识和上下文推理能力进行“消歧”。前沿模型由于参数规模更大、训练数据更广、对齐更充分,在消歧任务上表现更稳健;而轻量模型往往只能做表面匹配,容易产生偏离用户真实意图的输出。这也解释了为什么在开放域对话和模糊请求场景下,模型规模带来的能力差异会被显著放大。
轻量模型的“自信错误”更危险
原文还指出另一个关键问题:轻量模型会自信地给出错误答案,而普通用户根本分辨不出来。专家一眼就能识破胡编的答案,其他人则倾向于直接相信。
这一点构成了日常用户更需要前沿模型的第二个理由。模型能力的差距不仅体现在“能不能答对”,更体现在“答错时是否容易被识破”。对于缺乏领域判断力的普通用户,一个语气笃定但内容错误的回答,比一个明显答不上来的回答危害更大。
“自信错误”在AI研究中常被称为幻觉(hallucination),特指模型生成看似合理但事实错误或无依据的内容。幻觉并不专属于小模型,但轻量模型由于知识容量有限、推理链条较短,更容易在缺乏足够信息时“编造”答案,且语气往往同样笃定。对于专家用户,他们可以通过交叉验证或领域知识快速识别幻觉;而普通用户缺乏这种校验能力,容易将流畅、自信的输出误认为可靠答案。因此,在面向大众的日常应用中,降低幻觉率和提升不确定性表达(如“我不确定”)的能力,比单纯追求低成本更重要——这恰恰是前沿模型持续优化的方向。
99%的用户是普通人
原文给出了一个判断:今天99%的AI用户是普通人,而非专家。他们用模糊的语言向AI抛出模糊的问题,往往自己也不完全理解任务本身。在这种情况下,最好的做法就是让最新、最强的模型来回答。
这个视角值得重视,因为它颠倒了常见的成本逻辑。通常的建议是“简单任务用便宜模型省钱”,但原文认为,日常的“简单”只是表面上的简单——指令背后的意图不简单,判断答案对错更不简单。
对模型选择策略的启示
这篇讨论并没有否定轻量模型的价值。在指令可以精确拆解的场景下——流程固定的数据提取、格式转换、规则明确的操作——轻量模型完全够用,甚至更经济。
它真正质疑的是一种默认假设:把“日常”等同于“简单”。对大多数非专家用户而言,日常使用AI的场景恰恰是意图最模糊、最需要模型去补全上下文的场景。这也是前沿模型与轻量模型差距最容易被感知的地方。
选择模型的判断标准,或许不该是任务听起来是否“专业”,而该是指令本身有多模糊、以及使用者有多大能力验证答案。这两点上,普通用户的日常场景都落在需要更强模型的一侧。
相关推荐
Gemini 4 Carbon登顶智能指数 谷歌首次开放攻防模型
谷歌Gemini 4 Carbon以59分登顶Artificial Analysis智能指数,网络安全能力首次向防御方开放;OpenAI每月返还最高500美元API额度反击,开源阵营语音、小模型与智能体工程密集迭代。

Gemini 4 Carbon登顶AI基准,成本比榜首低72%
谷歌DeepMind发布Gemini 4 Carbon,在Archital Analysis Intelligence Index B5榜单以59分登顶,Arena文本榜第一1528分,中位任务成本仅80美元,比榜首Cloud Office 1.5低72%。

Gemini 4 Carbon实测:最强AI模型?对比Claude Opus 5.5
谷歌Gemini 4 Carbon发布,Artificial Analysis榜单第一,CW Bench达71%,Vending Bench登顶。实测对比Claude Opus 5.5,前端设计惊艳但Web开发略逊,价格优势明显。