如何高效啃完Sutton & Barto强化学习圣经?

分阶段阅读Sutton强化学习圣经,结合视频与代码实践,避免死磕公式。
本文针对初学者阅读Sutton & Barto《强化学习》教材的困难,提出分阶段阅读策略:先建立MDP框架,再深入动态规划、蒙特卡洛和TD等经典方法,最后攻克深度强化学习。文章建议采用视频课程与书籍交叉验证、用代码实现伪代码、组团讨论或写作输出、跳过暂时不懂的证明等技巧,并指出三大误区:必须按顺序读完、只读不练、忽视数学基础。核心观点是首遍阅读以建立知识地图为目标,通过主动输出降低枯燥感,最终能用算法解决实际问题。
为什么这本书让人又爱又恨
在强化学习(RL)领域,Sutton与Barto合著的《Reinforcement Learning: An Introduction》是公认的经典教材,甚至被称为“RL圣经”。但对于初学者来说,这本书的阅读体验并不友好——大量数学公式、伪代码和理论推导,很容易让人半途而废。一位Reddit网友的求助很典型:他已经开始看David Silver的YouTube课程,但想通过读书巩固基础,却觉得“读书有点无聊”,希望找到高效阅读的方法。
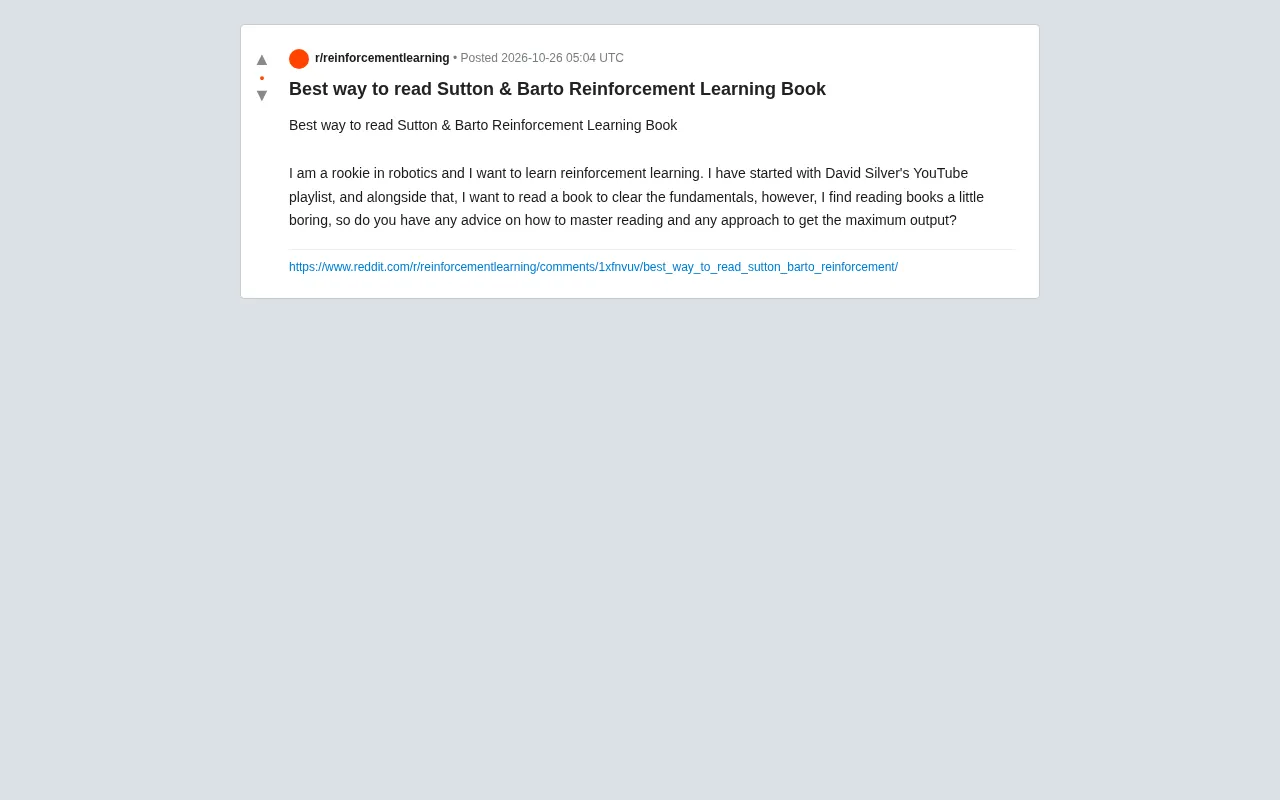
这个困境并非个例。强化学习涉及概率论、动态规划、函数逼近等多领域知识,而Sutton & Barto的书又偏向理论严谨性,缺少手把手的代码示例。直接从头啃到尾,确实容易迷失。
先搭骨架,再填血肉
读这本书最忌讳一上来就逐章逐节死磕。比较有效的策略是分阶段阅读:
第一阶段:建立地图(第1-3章)。重点理解强化学习的核心框架——智能体与环境交互、奖励、价值函数、马尔可夫决策过程(MDP)。这部分概念不多,但需要反复琢磨。可以配合David Silver的前几讲视频,把MDP、贝尔曼方程这些基础打牢。
第二阶段:经典方法(第4-8章)。动态规划、蒙特卡洛、时序差分(TD)、资格迹。这是全书最核心的部分,建议边读边用Python实现简单版本。比如用numpy实现一个Gridworld上的TD(0),代码量不大,但能极大加深理解。
第三阶段:深度强化学习(第9-13章)。函数逼近、策略梯度、Actor-Critic、深度Q网络等。这部分需要一定的深度学习基础,如果之前没接触过神经网络,建议先补一下PyTorch或TensorFlow的基础教程。
第四阶段:前沿与拓展(第14章以后)。可以选读,根据研究方向挑选章节。
马尔可夫决策过程(MDP) 是强化学习问题的数学框架,几乎后续所有算法都建立在它之上。MDP 由五元组 (\langle S, A, P, R, \gamma \rangle) 定义:状态集 (S)、动作集 (A)、状态转移概率 (P(s'|s,a))、奖励函数 (R(s,a)) 和折扣因子 (\gamma \in [0,1])。其核心假设是“马尔可夫性”——下一步状态只依赖当前状态和动作,与更早的历史无关。贝尔曼方程正是利用这一性质,把长期回报的期望拆解为“即时奖励 + 折扣后的下一状态价值”,从而将序贯决策问题转化为可迭代求解的方程。理解 MDP 与贝尔曼方程是读懂动态规划、TD 学习和策略梯度等章节的前提。
让阅读不再枯燥的四个技巧
1. 视频+书籍交叉验证。David Silver的课程和Sutton的书在知识体系上高度重合,但视频更直观。可以看完一讲视频后,立刻翻到对应章节快速浏览,重点看视频里没讲透的数学推导。这种“视频先行、书籍深化”的节奏能降低挫败感。
2. 用代码“翻译”公式。书中的伪代码是宝藏,但只看不写等于没学。每读完一个算法(比如SARSA、Q-learning),就用几十行代码实现它,跑一个简单环境(如FrozenLake)。你会发现很多细节(比如学习率衰减、探索策略)只有在动手时才会真正理解。
3. 组团阅读或输出倒逼输入。一个人读容易犯困,可以找一两个伙伴每周讨论一章,或者坚持写读书笔记发布在博客/知乎上。为了把概念讲清楚,你会主动查阅资料、画图、举例,这个过程本身就是最好的学习。
4. 跳过暂时看不懂的证明。书中有不少定理证明(如策略梯度定理、收敛性证明),第一遍读不懂很正常。可以先接受结论,继续往后读,等整体框架清晰后再回头啃证明。不要卡在一个地方超过两天。
常见误区与应对
误区一:必须按顺序读完每一页。Sutton & Barto的书更像参考书,不同章节可以独立阅读。比如第6章TD可以直接跳到第9章函数逼近,不必等第7、8章完全消化。
误区二:只读不练。强化学习是实践性很强的学科,光看书很容易产生“我懂了”的错觉。建议每学完一个算法,就在OpenAI Gym(现Gymnasium)的经典控制环境上跑一跑,观察学习曲线。
误区三:忽视数学基础。如果概率论和线性代数不扎实,读到贝尔曼期望方程、策略梯度推导时会非常吃力。花一周时间复习一下条件期望、马尔可夫链、矩阵求导,后面会顺畅很多。
总结
Sutton & Barto的书值得反复读,但第一遍的目标应该是“建立知识框架”,而不是“弄懂每个公式”。配合视频课程、动手实现、群体讨论,把阅读从被动输入变成主动输出,枯燥感会大幅降低。对于机器人背景的初学者,建议先从第1-6章入手,把值迭代、策略迭代、TD学习这些经典方法吃透,再逐步深入深度强化学习。记住:读完不是目的,能用它解决实际问题才是。
背景补充
资格迹(Eligibility Trace) 是连接蒙特卡洛与 TD 学习的桥梁,也是第 7、8 章的核心概念。它用一条随时间衰减的“痕迹”记录每个状态最近被访问的程度,从而在单步 TD 与蒙特卡洛之间连续插值((\lambda) 参数控制插值程度)。资格迹使得算法能在每一步更新时,把信用分配给最近访问过的多个状态,而不是只更新当前状态。这既能降低方差,又能保持较小的计算开销,是 TD((\lambda)) 和 SARSA((\lambda)) 等算法的机制基础。初读时若不理解其动机,可先记住“资格迹 = 近期访问的加权记忆”,后续再深入推导。
函数逼近(Function Approximation) 是打通表格型强化学习与深度强化学习的关键概念。当状态空间连续或巨大时,无法为每个状态单独存储价值,于是用参数化函数(如线性模型或神经网络)来近似价值函数或策略。第 9 章引入这一思想后,Q-learning、策略梯度等方法才能扩展到高维输入。函数逼近也带来新的挑战:函数近似误差可能导致算法不稳定甚至发散(“致命三要素”:函数逼近、自举、离策略学习同时出现时风险最高)。理解这一点,有助于明白为什么深度强化学习需要经验回放、目标网络等稳定化技巧。
相关推荐
OpenAI数学突破、Anthropic IPO与推理模型教程
OpenAI公布数学、计算机与物理三项成果,声称证明ETH不成立;Anthropic提交上市申请,披露营收与客户数据;SpaceX获400亿美元GPU融资;开源模型工具调用准确率问题与约束解码方案;8视频推理模型构建教程。

推理模型14个核心概念:从思维链到GRPO全面拆解
系统拆解推理模型14个核心概念:思维链、测试时计算、验证器、RLVR与GRPO、蒸馏与reward hacking,并给出思考token的成本控制规则,帮你判断何时值得为推理付费。

OpenAI称推翻ETH引热议,Meta豪赌AI基建
OpenAI宣布AI辅助发现,预印本声称推翻指数时间假设ETH,同时推出中端模型GPT-6.1 Tera。Cloudflare披露跨客户数据泄露复盘,Meta拟融资950亿美元投入AI基建。