如何靠项目实战成为Agentic AI求职者?
掌握LangChain等技术后,Agentic AI求职者应通过多Agent协作、自动化工作流和长期记忆Agent三类深度项目证明实战能力。
本文针对已掌握LangChain、RAG、Agent等技术栈却不知该构建何种项目的AI求职者,给出了系统性建议。文章指出,基础聊天机器人和简单RAG应用已无法体现竞争力,真正打动招聘方的是能处理真实复杂性的项目——包括多Agent协作系统、带工具调用的自动化工作流,以及具备长期记忆与自我改进能力的智能助理。除项目本身外,可观测性、评估体系和部署上线等工程能力同样不可或缺。文章强调,面对框架快速迭代的焦虑,核心应对策略是掌握Agent规划、工具使用、记忆和执行反馈的底层原理,而非盲目追逐新工具,并通过GitHub作品集和公开分享将项目转化为求职优势。
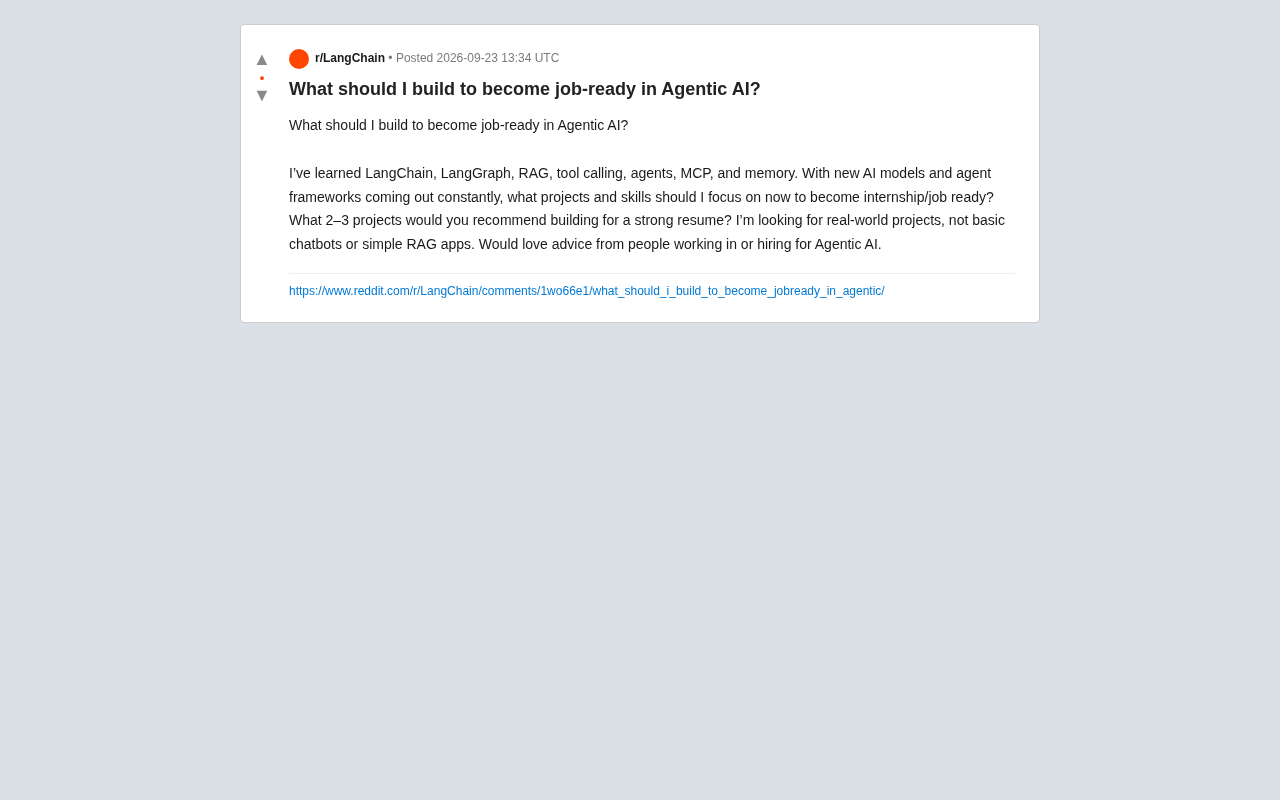
在AI求职市场,掌握技术栈只是入场券,真正让简历脱颖而出的是能拿得出手的实战项目。一位Reddit开发者的提问引发了不少共鸣:他已经学完LangChain、LangGraph、RAG、工具调用(tool calling)、Agent、MCP和记忆机制,但面对层出不穷的新模型和Agent框架,仍然困惑于该构建什么项目才能真正达到实习或就业标准。
这个问题背后反映的,是当下Agentic AI(智能体AI)领域从业者共同面临的焦虑:技术更新太快,而基础的聊天机器人和简单RAG应用早已无法证明能力。本文结合这一典型困惑,梳理出成为Agentic AI求职者应聚焦的项目方向与核心技能。
为什么基础项目不再有竞争力
提问者明确指出,他不想再做“基础聊天机器人或简单RAG应用”。这一判断相当准确。随着开源框架的成熟,搭建一个能回答问题的RAG系统门槛已经极低——几十行代码加一个向量数据库就能跑通。招聘方看到的是能力的天花板,而非项目本身。
真正区分候选人的,是能否处理真实世界的复杂性:多步骤任务编排、错误恢复、状态管理、多Agent协作,以及在生产环境中的可靠性。当一个项目开始面对这些工程挑战时,才真正体现了Agentic AI的价值所在。
应该聚焦的三类实战项目
1. 多Agent协作系统
单Agent能完成的任务有限,而真实业务场景往往需要多个Agent分工协作。可以构建一个模拟团队协作的系统,例如自动化的研究助手:一个Agent负责检索信息,一个负责分析总结,一个负责验证事实,最后由协调Agent整合输出。
这类项目能充分展示LangGraph的状态图编排能力,也能体现对Agent之间通信、任务分配和冲突解决的理解。相比单一Agent,多Agent系统更贴近企业实际需求,也更能暴露和考验工程设计能力。
LangGraph 是 LangChain 生态中专为构建有状态、多步骤 Agent 流程设计的框架,其核心抽象是有向图(DAG):节点代表 Agent 或处理步骤,边代表状态流转逻辑。与线性链式调用不同,LangGraph 支持条件分支、循环和并行执行,天然适合多 Agent 场景中的任务路由和错误重试。在多 Agent 系统中,"协调 Agent"(Orchestrator)负责分解任务并调度子 Agent,而 LangGraph 的状态图恰好提供了一种结构化方式来管理这些 Agent 之间的共享状态和消息传递,避免了手动维护复杂调度逻辑的混乱。
2. 带工具调用的自动化工作流
提问者已掌握tool calling和MCP(Model Context Protocol),这正是构建实用自动化工作流的基础。可以选择一个具体的业务场景——比如自动化的客户支持处理、代码审查助手,或数据分析管道——让Agent真正调用外部API、操作数据库、执行代码。
关键在于让项目“做真事”,而不是停留在对话层面。一个能自动拉取数据、生成报告并发送邮件的Agent,远比一个只会聊天的机器人更有说服力。MCP的引入还能展示对标准化工具接口的理解,这是当前行业关注的热点。
MCP(Model Context Protocol)是 Anthropic 于 2024 年底提出的开放协议,旨在标准化大语言模型与外部工具、数据源之间的接口。在此之前,每个 Agent 框架都有自己的工具调用格式,导致工具难以跨框架复用。MCP 定义了统一的"工具描述 + 调用 + 响应"规范,使得同一个工具服务(如数据库查询、文件操作)可以被不同的 LLM 应用接入,类似于 Web 开发中的 REST API 标准化作用。在项目中引入 MCP,不仅能展示对新兴行业标准的跟进,也意味着构建的工具模块具有更好的可复用性和互操作性,这对企业级应用尤为重要。
3. 具备长期记忆与自我改进的Agent
记忆机制是提问者提到的技能之一,也是Agentic AI从“一次性问答”走向“持续服务”的关键。可以构建一个具备长短期记忆的个人助理,能记住用户偏好、历史交互,并随着使用不断优化响应。
更进一步,可以尝试引入反思(reflection)和自我评估机制,让Agent在任务失败后能分析原因并调整策略。这类项目难度较高,但恰恰是当前研究和产业都在探索的前沿,能显著体现候选人的技术深度。
Agent 的记忆机制通常分为四类:短期记忆(当前对话的上下文窗口)、长期记忆(持久化存储的用户偏好和历史事件,通常借助向量数据库或键值存储)、情景记忆(特定任务或会话的完整记录)和程序性记忆(Agent 习得的操作规则和技能)。"反思"(Reflection)机制则是在任务完成后,让 Agent 对自身行为进行批判性回顾,生成改进建议并写回记忆,这一思路源自 Shinn 等人 2023 年的论文《Reflexion》。构建具备这些能力的 Agent 需要精心设计存储架构和触发时机,是目前学术界和工程界都在积极探索的前沿方向。
项目之外:工程能力同样关键
面对“新模型和框架不断出现”的焦虑,一个务实的建议是:不要盲目追逐每一个新框架。底层原理相通,Agent的核心始终是规划、工具使用、记忆和执行反馈的循环。掌握原理后,学习新框架只是时间问题。
招聘方看重的不只是能否调通demo,而是能否把项目做到可用、可维护、可部署。这意味着需要关注以下工程能力:
- 可观测性(Observability):为Agent添加日志、追踪和评估,能定位问题出在哪一步;
- 评估体系:建立测试用例衡量Agent的表现,而非凭感觉判断好坏;
- 成本与延迟优化:真实生产环境对token消耗和响应速度都有约束;
- 部署上线:将项目容器化并部署到云端,附上清晰的文档和演示。
一个部署上线、附带评估结果和技术文档的项目,胜过三个躺在本地跑不起来的demo。
可观测性在 Agent 系统中的重要性远超传统软件,原因在于 LLM 的调用链路长、非确定性强,单次失败可能源于提示词、工具调用、上下文截断或模型幻觉中的任意一环。LangSmith(LangChain 官方追踪工具)、Langfuse 和 Arize Phoenix 等平台可以记录每次 Agent 运行的完整轨迹,包括每步的输入输出、token 消耗和耗时。在简历项目中接入追踪工具,并能结合具体 trace 讲清楚"我如何发现并修复了某个 Agent 失控循环",往往比泛泛而谈技术栈更能打动有实际工程经验的面试官。
如何让项目转化为求职优势
构建项目只是第一步,如何呈现同样重要。建议在GitHub上维护整洁的仓库,撰写清晰的README说明设计思路和技术选型,并在博客或社交平台分享构建过程中的思考与踩坑经验。
这种“公开学习”不仅能积累作品集,还能吸引行业内人士的关注。对于Agentic AI这样快速演进的领域,展现出持续学习和独立解决问题的能力,往往比技能清单本身更打动招聘方。
结语
从提问者的技能储备看,他已经具备了扎实的基础,缺的是把这些技术整合进复杂、真实场景的实战经验。与其焦虑于框架更迭,不如选择两到三个有深度的项目——多Agent协作、自动化工作流、带记忆的智能助理——把它们做深、做透、做到能部署可演示。技术会变,但解决真实问题的能力永远稀缺。
相关推荐
Vibe Coding 深度解读:从写代码到指挥AI的一人公司实战路径
Vibe Coding 是什么?本文解读从「人写代码」到「人指挥AI」的开发新范式,涵盖Claude Code、Codex、Cursor等工具协同、全链路闭环、多端开发与AI自动化运营,剖析一人公司与超级个体的机会与误区。
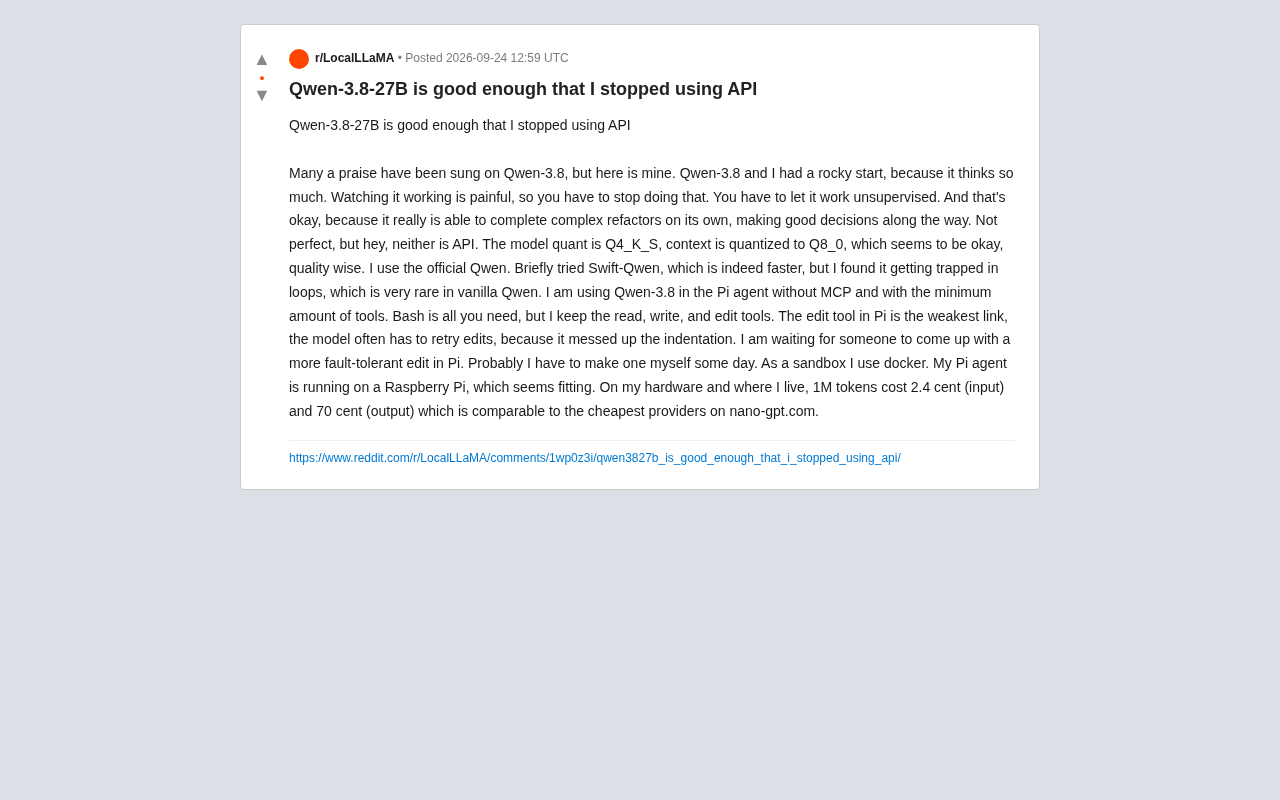
本地跑 Qwen-3.8-27B 替代 API:一位开发者的实战体验
一位 Reddit 开发者分享用本地 Qwen-3.8-27B 完全替代云端 API 的实战经验,涵盖 Q4_K_S 量化、Pi agent 极简工具链、树莓派部署与详细成本核算,探讨开源大模型「够用」的临界点。
生产环境中如何验证AI Agent的行为?运行时校验实战指南
AI Agent在生产环境代表用户执行操作时如何验证其行为?本文从非确定性输出、不可逆副作用等挑战出发,梳理策略护栏、人在回路、运行时追踪、LLM评判等验证方法,帮助团队构建分层防御体系。