如何用LLM写作:把它当校对,而非代笔
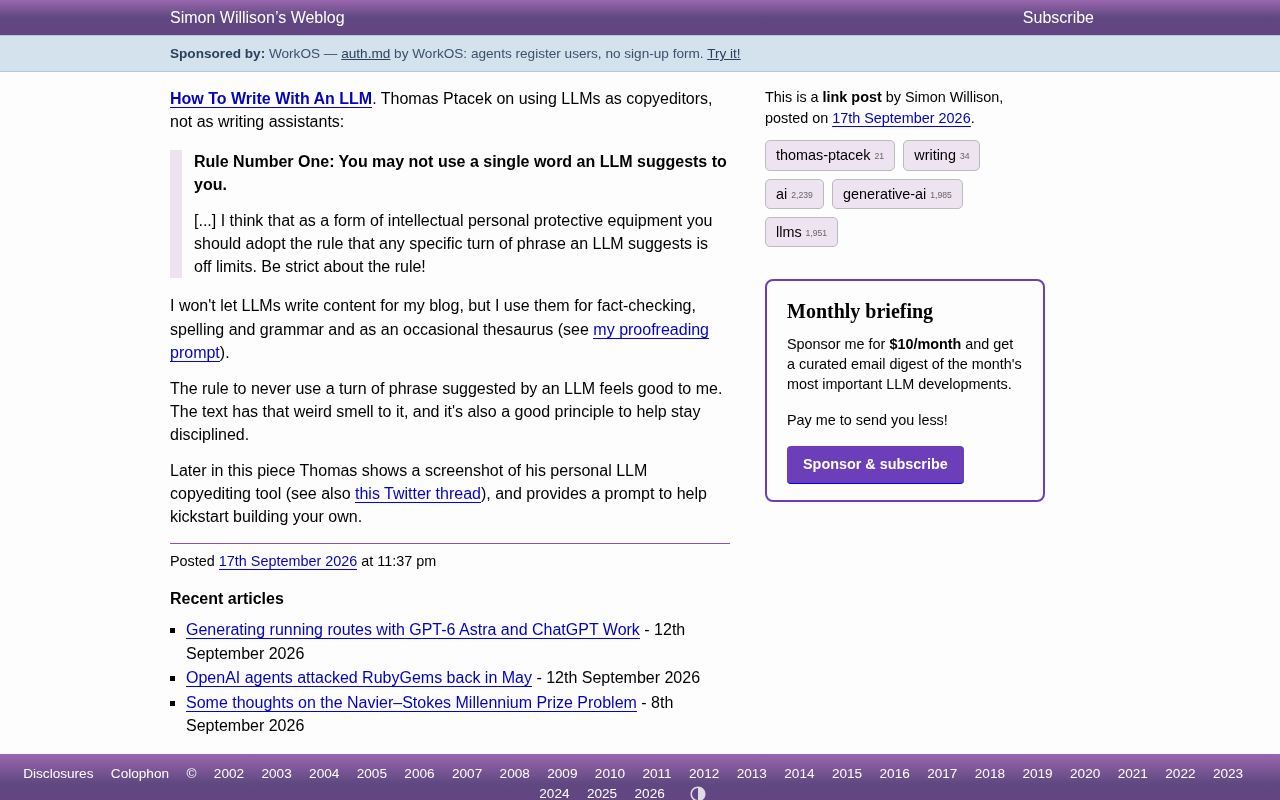
用LLM校对而非代笔:资深写作者主张禁用AI措辞、只借助其发现错误,以守护独特的个人声音。
安全研究者Thomas Ptacek与独立开发者Simon Willison分享了一套反直觉的AI写作方法论:借助大语言模型辅助写作,但绝对不采用它给出的任何一个具体词句。核心原则是把LLM定位为"校对员"而非"写作助手"——可以用它做事实核查、语法检查和查阅同义词,但具体措辞的最终决定权必须留给写作者本人。其背后的理由是,LLM生成的文本带有一种可辨识的"AI味":过度工整、模式化、缺乏真实个人经验,一旦混入文章便会侵蚀读者信任。更重要的是,"一个词都不用"是一条清晰的纪律工具,比模糊的自律更易坚持。在AI可以轻易写出通顺句子的时代,独特的观点、真实的经验和可信赖的声音才是真正稀缺的,这套"用而不依赖"的姿态或许是对待生成式AI最成熟的方式。
在AI写作工具泛滥的当下,一个看似矛盾的观点正在部分资深写作者中流行:用大语言模型(LLM)来辅助写作,却坚决不让它替你写一个字。安全研究者与知名博主 Thomas Ptacek 最近撰文分享了自己的写作方法论,而独立开发者 Simon Willison 也表达了类似的实践经验。两人的核心共识值得每一位内容创作者认真思考。
核心原则:一个词都不能用LLM的
Thomas Ptacek 给出的第一条规则极为严格:
规则第一条:你不能使用 LLM 建议给你的任何一个词。
他将这条规则形容为一种「智识上的个人防护装备」(intellectual personal protective equipment)。也就是说,凡是 LLM 提出的具体措辞、特定的表达方式,都应被划为禁区,而且要严格执行。
这个原则的价值不在于对 AI 的敌视,而在于保护写作者的独立表达。当你开始采纳模型给出的漂亮句子时,文字就会逐渐失去个人风格,滑向那种千篇一律的「AI 腔调」。Ptacek 认为,与其在事后费力清除这种味道,不如从源头上就杜绝它。
LLM 的正确用途:校对而非代笔
真正的关键区别在于:把 LLM 当作校对员(copyeditor),而不是写作助手(writing assistant)。这两者的差别决定了最终文字属于谁。
Simon Willison 分享了他自己的实践边界,很好地划清了这条线:
- 绝不让 LLM 为博客撰写内容
- 可以用于事实核查(fact-checking)
- 可以用于拼写和语法检查
- 可以偶尔当作同义词词典(thesaurus)来查阅
他甚至公开了自己使用的校对提示词(proofreading prompt)。这种用法的共同点在于:LLM 只负责发现问题、指出错误、提供信息,而具体如何修改、用什么词表达,最终决定权始终握在写作者手中。
换句话说,模型可以告诉你「这句话有语法错误」或「这个事实可能不准确」,但不能告诉你「应该这么写」。前者是工具,后者是代笔。
「校对员」与「写作助手」的区分,在人机协作语境下有更深的技术含义。大语言模型在生成文本时,本质上是在对训练语料的概率分布进行采样——它输出的是「统计上最可能出现的下一个词」,而不是「最能表达你想法的词」。这意味着模型天然倾向于生成大量文本中出现频率最高的表达方式,也就是那些读起来最「正确」却最缺乏个性的句子。当你把它用作校对工具时,它在做的是识别偏差(grammar error、factual inconsistency),这类任务的正确答案相对客观;而当你让它写作时,它填补的是你本应做出的创作决策,而这些决策恰恰构成了文字的个人风格。两种用法调用的是模型相同的底层能力,但对写作者自主权的侵蚀程度却截然不同。
为什么这条规则「感觉对」
Simon Willison 对 Ptacek 的规则给出了一个直觉性但颇具说服力的解释:LLM 生成的文本「有一种奇怪的味道」(that weird smell)。
这种「AI 味」几乎每个经常阅读网络内容的人都能隐约察觉——过度工整的排比、模式化的过渡句、缺乏真实个人经验支撑的泛泛而谈。一旦这些措辞混入你的文章,读者的信任感会悄然流失。
更重要的是,「一个词都不用」这条规则本身就是一种纪律工具。它不需要你在每次修改时判断「这个 AI 建议算不算过度依赖」,而是直接给出一个清晰的、不可逾越的边界。清晰的规则比模糊的自律更容易长期坚持,这也是它「感觉对」的深层原因。
「AI 腔调」之所以可被识别,有其语言学层面的原因。研究者观察到,LLM 生成的文本往往呈现出若干高频模式:过度使用「值得注意的是」「不可否认」「综上所述」等连接短语,句子长度趋于均匀,以及倾向于在段落末尾做出总结性收束。这些特征来自模型对大量人类写作(尤其是正式文体)的统计归纳,形成了一种「平均化的正式感」。人类写作中恰恰相反——真实的个人风格往往体现在对常规表达的有意偏离:刻意截断的短句、口语化的插入语、只有亲历者才会使用的具体细节。这种偏离是模型难以模仿的,因为它在训练数据中出现频率较低,且高度依赖写作者的具体经历和个性。"一个词都不用"的规则,本质上是在强制保留这种偏离空间。
自己动手:打造个人校对工具
在文章后半部分,Ptacek 还展示了他自己搭建的个人 LLM 校对工具的截图,并附上了相关的 Twitter 讨论线程。他提供了一段可以直接使用的提示词,帮助读者动手搭建属于自己的校对助手。
这一点其实揭示了更实用的方向:与其依赖通用聊天界面里的模糊对话,不如为「校对」这个明确的任务定制专门的工具和提示词。当工具的目标被限定为「找错」而非「改写」时,它就自然而然地被约束在了辅助者的角色里,而不会僭越成写作者本身。
给内容创作者的启示
这套方法论对所有依靠文字工作的人都有借鉴意义。AI 时代真正稀缺的不是「能写出通顺句子」的能力——那已经被模型大幅降低了门槛——而是独特的观点、真实的经验和可信赖的声音。
把 LLM 定位为校对、事实核查和查词工具,既能享受技术带来的效率提升,又能守住内容的原创性与个人风格。这种「用而不依赖」的姿态,或许是当前对待生成式 AI 最成熟的一种态度。
相关推荐
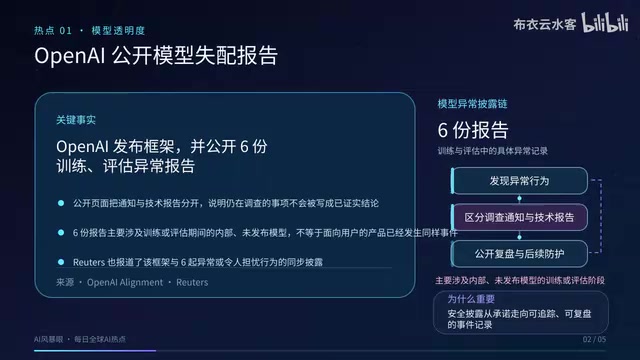
OpenAI披露模型异常、DeepMind建AGI机构、英伟达联手管电力
9月17日AI行业三大动态:OpenAI公开模型异常披露框架并放出六份报告,Google DeepMind成立AGI公共讨论平台,英伟达联合Google等发起AI电力管理联盟。深度解析AI安全、治理与基础设施三大瓶颈。
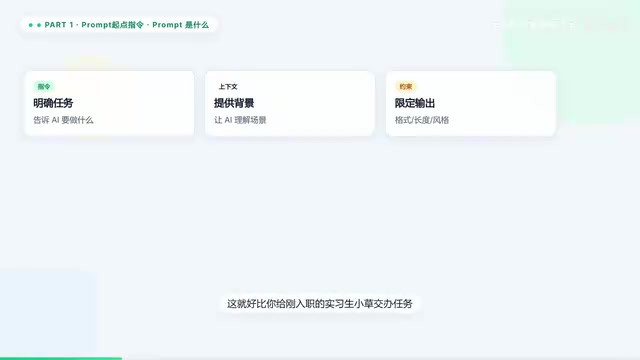
Prompt→MCP→Agent→Skill:5分钟搞懂AI术语进化链
一篇科普梳理Prompt、MCP、Agent、Skill、Cowork五大AI核心概念的递进关系。用职场类比讲透AI如何从简单指令进化到多智能体团队协作,帮你彻底告别AI术语焦虑。
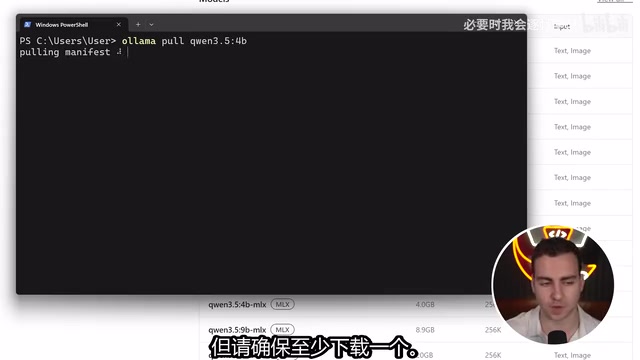
10分钟用Python搭建本地AI代理:Ollama+PydanticAI实战
一篇基于B站教程的实操指南,教你用Python、Ollama和PydanticAI在10分钟内搭建完全本地运行的AI代理。涵盖模型选择、连接推理服务器、挂载工具函数和构建对话循环全流程。