RunInfra:为AI代理打造的开源模型平价方案

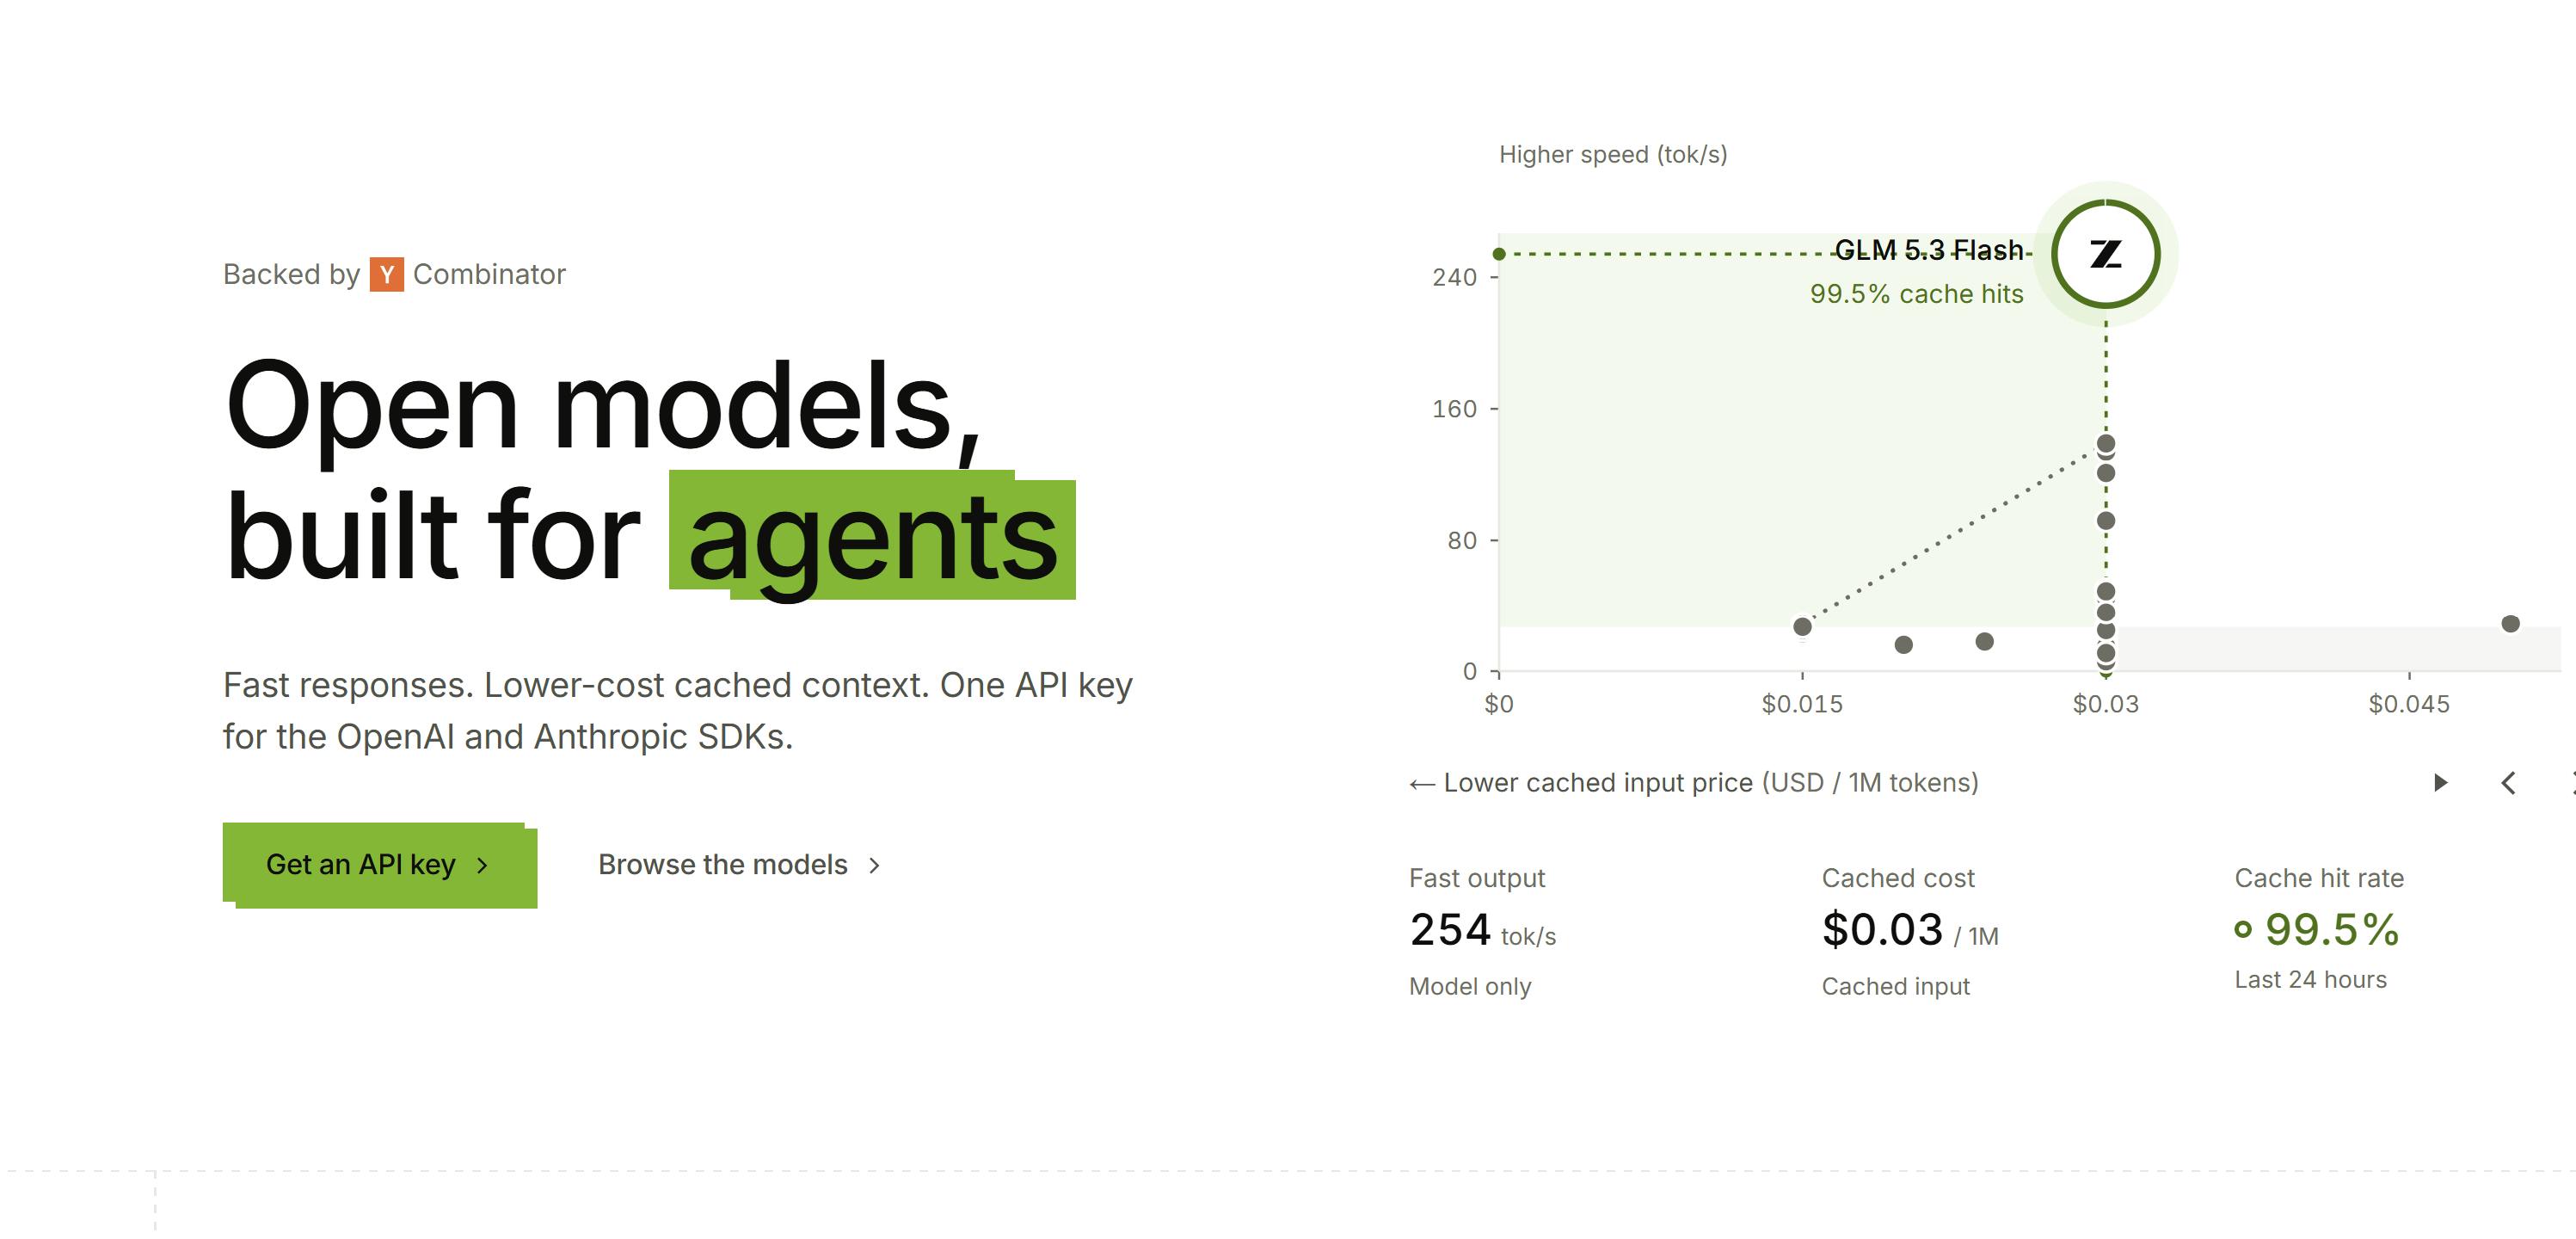
RunInfra 以月费 10 美元起的开源模型套餐,靠会话感知路由把缓存命中率推到 99.5%,为编码代理提供低成本执行层。
RunInfra 是一款面向 AI 编码代理的开源模型订阅服务,起价每月 10 美元,整合 GLM 5.3、DeepSeek V4.1 Flash、Qwen3.8 27B 等模型,通过一段提示词即可接入 Claude Code、Cline、Droid 等主流代理工具,几乎零迁移成本。其商业逻辑的核心是会话感知路由:把同一会话的连续请求绑定到同一缓存节点,宣称缓存命中率最高达 99.5%,从而把按 token 计费转为可预期的包月固定支出。产品定位并非取代闭源旗舰模型,而是承接「量大管饱」的日常编码任务。合规方面承诺零数据保留、不用于训练并持有 SOC 2 Type II 认证,但实际效果仍需第三方审计与真实负载验证。
开发者工具领域正在经历一场静默的变革:AI编码代理不再只是概念演示,而是开始真正进入日常开发工作流。但随之而来的问题是——如何让这些代理跑得又快又省?RunInfra 给出的答案是:包月订阅制的开源模型池。
一个提示词完成接入,门槛压到最低
RunInfra 最吸引人的地方在于接入流程的极简设计。官方描述是「Setup takes one prompt」——你把一段提示词粘贴进代理工具,完成一次登录授权,配置就结束了。没有繁琐的 API key 管理,没有环境变量折腾。对于已经在使用 Claude Code、Codex、OpenCode、Cline、Droid 或 Grok Build 的开发者来说,这种零摩擦的接入方式几乎不构成迁移成本。
从产品定位看,RunInfra 并不自己训练模型,而是把 GLM 5.3、DeepSeek广告 V4.1 Flash、Qwen3.8 27B 等开源模型整合成面向编码代理的套餐,起价每月 10 美元。这本质上是把「模型选型 + 推理成本 + 缓存优化」打包成一个可预期的固定支出,让开发者不用再为按 token 计费的账单焦虑。
会话感知路由:缓存命中率高达 99.5% 的技术底牌
RunInfra 宣称其会话感知路由(session-aware routing)能让缓存命中率达到 99.5%。这个数字是整套商业逻辑的关键。编码代理的工作模式是高度重复的:同一份代码库上下文、相似的提问、连续的多轮对话。如果路由层能识别出会话的连续性并把请求导向同一缓存节点,那么绝大部分推理可以直接命中缓存,边际成本急剧下降。
这也解释了 RunInfra 为什么敢做「包月不限量」式的定价。传统 API 按 token 收费,是因为每次请求都可能触发完整推理;而当缓存命中率接近满载时,套餐的经济模型就跑得通了。说个细节,99.5% 是厂商宣称的上限值,实际命中率取决于使用模式——上下文频繁变化的场景可能达不到这个水平。
KV 缓存与提示词缓存(Prompt Caching)
大语言模型推理时,会把已处理 token 的键值对(Key-Value,简称 KV 缓存)保存在显存中,避免对相同前缀重复计算。提示词缓存正是利用这一机制:当两次请求共享相同的上下文前缀(如相同的系统提示、同一份代码库片段),后续请求可直接复用已计算的 KV 状态,只需处理新增 token。对编码代理这类「同一代码库上下文 + 多轮追问」的负载,前缀复用率极高,因此缓存命中能把有效推理量压到很低。
会话感知路由(Session-aware Routing)
常规负载均衡按请求随机或轮询分发,同一会话的请求可能落到不同节点,导致各节点缓存互不共享、命中率归零。会话感知路由则依据会话标识(session ID、对话历史哈希等)把同一会话的连续请求稳定绑定到持有对应缓存的节点,从而最大化前缀复用。这也是 RunInfra「99.5% 缓存命中」在工程上得以成立的前提,代价是需要维护会话与节点的映射状态,并在节点故障时做好缓存迁移或重建。
开源模型 + 编码代理,这个组合成立吗
RunInfra 押注的核心假设是:编码场景对模型能力的要求相对聚焦,开源模型已经够用。GLM、DeepSeek、Qwen 系列在代码生成和工具调用上的表现确实在快速逼近闭源模型,而价格往往只有零头。对于追求性价比的团队,这构成了一个真实的替代选项。
但这个组合也有明显的边界。开源模型在复杂推理、长上下文一致性和生态工具集成上仍有差距,重度依赖高级推理的任务可能仍需要闭源旗舰模型兜底。RunInfra 的价值不在于取代顶级闭源模型,而在于为「量大管饱」的日常编码任务提供一个成本可控的执行层。
编码代理(Coding Agent)与工具调用
编码代理并非单纯的代码补全,而是能自主规划步骤、读写文件、执行命令、运行测试并根据报错迭代的智能体。其核心能力是工具调用(Tool Calling / Function Calling):模型输出结构化的调用指令,由代理框架执行后把结果回灌给模型,形成闭环。
这一工作模式对模型提出两类要求:一是长上下文下的指令遵循与状态保持,二是稳定的结构化输出能力。前者决定代理能否在大型代码库中不迷失,后者决定工具调用是否可靠。开源模型近两年在这两项上进步显著,但在多步复杂规划、错误自恢复和长程一致性上仍与闭源旗舰存在差距——这正是文中「开源模型够用于日常任务、复杂推理仍需闭源兜底」判断的技术依据。
数据安全承诺:零保留与 SOC 2
面向企业开发者的产品,合规是绕不过去的门槛。RunInfra 明确承诺零数据保留(Zero data retention)、不在用户提示词上训练模型,并持有 SOC 2 Type II 认证。对于把私有代码库交给代理处理的团队来说,这些条款是基本的信任前提。不过与所有此类承诺一样,实际执行情况需要依赖第三方审计和用户的独立验证,厂商单方面的声明只是起点。
SOC 2 Type II 是什么
SOC 2 由美国注册会计师协会(AICPA)制定,围绕安全性、可用性、处理完整性、保密性和隐私五项信任服务准则评估服务商的控制措施。其中 Type I 只评估某一时点的控制设计是否合理,Type II 则要求在 6–12 个月的观察期内对控制措施的实际运行进行抽样审计,因此更能反映持续合规能力。对企业客户而言,Type II 报告通常比厂商自述更具说服力,但它覆盖的是内部控制流程,并不直接等同于「数据绝不被用于训练」这类具体承诺的验证,后者仍需结合零保留条款与独立技术审计来判断。
竞争格局与观察点
在 Product Hunt 上首发当日拿到 90 票、排名第 6,说明这个方向有明确的关注度但尚未引爆。RunInfra 面临的竞争来自两侧:一边是 OpenRouter 这类模型聚合平台,另一边是各家编码代理自带的官方模型通道。它的差异化在于「为代理场景深度优化」——会话路由、缓存策略、平固定价,这些都是通用聚合平台不会专门去做的事。
后续值得关注的是:套餐的实际限速策略、缓存命中率在真实工作负载下的表现,以及开源模型版本更新时 RunInfra 的跟进速度。如果这三点能兑现,「为代理而生的开源模型层」这个定位就有机会站稳。
本文基于 Product Hunt 公开产品信息撰写,模型能力与性能数据以厂商宣称及后续实测为准。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。