三大AI编程Agent技能包实战对比:Addy、Pocock与P-Stack选型指南

三套顶级AI编程Agent技能包对比:Addy覆盖全流程、Matt主对齐、P-Stack重验证,核心是仪式感匹配风险等级。
前Google首席工程师Addy Osmani开源的Agent技能包以完整软件开发生命周期(SDLC)为骨架,设计、规划、构建、验证、评审、交付六阶段各对应一条slash命令,上线即获10万GitHub星标。创作者Rob Shocks将其与Cursor工程师Lauren Tan的P-Stack及TypeScript专家Matt Pocock的技能包进行了系统对比:Matt聚焦编码前的需求对齐,P-Stack强调事后的多模态验证,Addy则是唯一覆盖全流程的方案。三套包的技能文件本身——包括反合理化表、怀疑驱动开发、Hiram定律、Chesterton栅栏等工程原则——才是真正的价值所在。选型关键在于"仪式感匹配风险等级":小改动无需重型流程,只有涉及生产或不可逆操作时才动用完整评审体系,过多技能反而造成上下文膨胀,降低Agent效果。
AI编程Agent时代,"技能包"(Skills)正成为开发者提升代码质量的新方式。前Google首席工程师、如今加入Anthropic(Claude Code背后公司)的Addy Osmani近期开源了自己的全套Agent技能,上线不久便收获10万星标,成为GitHub上最受欢迎的AI仓库之一。
B站及YouTube创作者Rob Shocks(Switch Dimension)此前已分别拆解过Cursor的Lauren Tan所做的P-Stack,以及Matt Pocock的技能包。随着Addy的加入,"三巨头"技能包终于凑齐。本文结合这期对比视频,梳理三套技能包各自解决的问题,以及该如何按需取用。
Addy Osmani:把软件工程生命周期交给Agent
Addy Osmani在前端圈堪称传奇——他写过《Learning JavaScript Design Patterns》,主导过Chrome开发者体验与Web性能工作。如果你用过Lighthouse广告或了解过Core Web Vitals,多少都受过他的影响。正因如此,当这样一位资深工程师把"该如何让Agent做软件工程"写成Markdown时,确实值得认真对待。
Addy的方法论本质是一条生命周期:Design(设计)、Plan(规划)、Build(构建)、Verify(验证)、Review(评审)、Ship(交付)六个阶段,每个阶段都对应一条slash命令。相比Matt的"Grilling/Wayfinder"、P-Stack的"Potato Mode/Arenas"这类自造术语,Addy最贴近传统的软件开发生命周期(SDLC),无需额外学习隐喻,因此也最容易融入现有团队和企业环境。
具体流程上,spec会在写第一行代码前产出完整PRD,覆盖目标、结构、代码风格、测试与边界;plan将其拆成带验收标准的原子任务;build则一次只实现一个"薄纵切片"(thin vertical slice),实现、测试、验证、提交逐步推进。整个包共有25个技能,外加四个评审人格:资深工程师、测试工程师、安全审计员和Web性能审计员。
其中一个值得关注的模式是build auto:你只需批准一次计划,后续任务便自动运行,但验证环节并未被省略——每个任务仍走测试驱动、单独提交,一旦失败即停止。这被Rob视为"正确的自主性"实现方式。
软件开发生命周期(SDLC,Software Development Life Cycle)是软件工程领域的经典框架,描述从需求分析、设计、编码、测试到部署和维护的完整过程。传统SDLC的价值在于它为团队提供了共同语言和可预测的质量门禁,每个阶段都有明确的输入、输出和验收标准。将SDLC映射到AI Agent的操作流程,意味着Agent不再是"接一句话、出一段代码"的单步工具,而是被纳入一个有约束、可审计的工程流水线。这对企业环境尤为重要:团队成员无需理解Agent的内部机制,只需遵循熟悉的阶段划分即可协作,也便于将AI生成的产物接入已有的代码审查、CI/CD和合规流程。
技能文件里的工程智慧
Rob强调,slash命令本身并非重点,真正有价值的是技能文件——那才是工程师大脑的具象化。
Addy的每个技能都带有一张"反合理化表"(anti-rationalisation table):预先列出Agent为跳过某步骤会找的借口(比如"这太简单不用测试""我手动测过了"),并在旁边附上反驳。任何和Agent或初级工程师打过交道的人都对这些借口不陌生,提前把它们写下来是相当聪明的做法。
技能里还藏着不少工程圈的"老朋友":API设计中的Hiram定律(API的任何可观测行为终将被某人依赖)、测试里的"Beyoncé法则"(喜欢就该加个测试)、代码删除中的Chesterton栅栏原则(搞清楚栅栏为何存在之前别拆它)。
一个颇具新意的概念是"怀疑驱动开发"(Doubt Driven Development):对任何非平凡决策,系统会开启一次全新上下文评审,唯一任务就是质疑这个主张——claim、extract、doubt、reconcile、stop。这相当于在构建过程中就引入对抗性评审,而非只在最后把关。正如Rob所说,哪怕你从不安装这套技能,光是通读这些技能文件,也比大多数软件工程课程更有价值。
Hiram定律(Hyrum's Law)由Google工程师Hyrum Wright提出,完整表述为:"只要一个API有足够多的用户,接口契约本身已无关紧要——系统的所有可观测行为都会被某个人所依赖。"这条定律提醒工程师:即便某个行为从未被文档化,用户也可能已经在依赖它,因此任何变更都可能破坏你完全不知道的下游系统。Chesterton栅栏原则同样来自工程与哲学的交汇,其核心是"在搞清楚一件事存在的理由之前,不要去移除它"——这对AI Agent尤为关键,因为Agent在重构时往往倾向于删除看似冗余的代码或配置,而这些内容可能是应对某个历史边界情况而存在的。将这类原则显式写入技能文件,相当于把组织的工程记忆编码成Agent可以执行的约束。
三套技能包,三种提问角度
三位作者各自回答着不同的核心问题,这也是选型的关键。
Matt Pocock的技能包问的是"我们对要构建的东西达成共识了吗?" 他把功夫下在编码前的对齐上,最出名的技能grill me会让Agent在动笔前反复拷问你,并辅以ADR(决策记录)和术语表。Matt公开表示自己是"反框架派",认为BMAD、Spec-Kit、Superpowers这类框架会剥夺开发者的控制权,因此他的技能刻意保持小巧、可组合、可自行魔改。
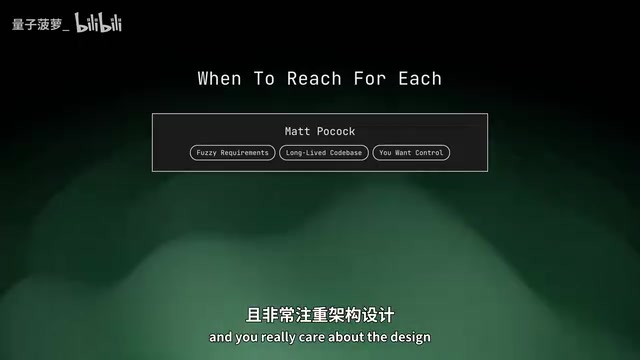
Lauren Tan的P-Stack问的是"你能证明它真的能跑吗?" 她刻意不设规划类技能,信条是"最好的spec就是代码本身"。全部重量压在事后的调查、验证与多模态评审上——构建通过并不算证据,必须真正验证出来。
Addy的技能包问的是"我们是否走完了整个流程?" 它是三者中唯一覆盖完整SDLC的,一路延伸到持续集成部署、可观测性、弃用与交付,因此最适合团队协作,可移植性也最强(据介绍可安装进约70种不同的Agent)。
Rob也指出,三套包之间存在大量重叠,但这并非互相抄袭,而是软件工程师在"如何构建软件"上本就会自然收敛。软件工程本身是有主张的,你只需挑出最好的那套主张应用到自己的工作流里。
选型建议:别盲目装满所有技能
Rob自己的做法是混用三套,但绝不同时全开,而是分成轻、中、重三档:
- 问题模糊、不确定想要什么、或长期维护的核心代码库时,找Matt Pocock,
grill me依然是他最推荐优先安装的第一个技能; - 团队协作、需要大家都认得的可预测流程、想要现成的质量门禁时,找Addy;
- **难复现的Bug、需要swarm/arena攻坚、数据迁移、需要信任的长时运行(比如过夜任务)**时,找P-Stack,它作为Cursor插件配合多模型表现尤佳。
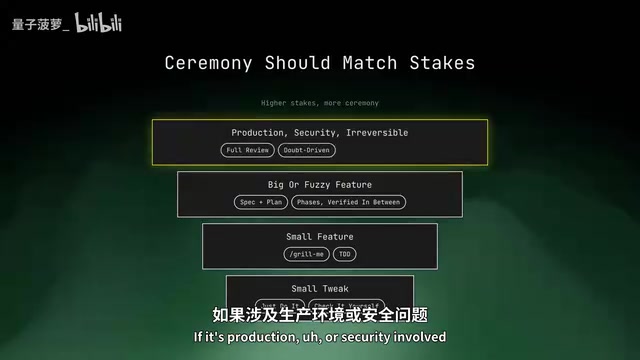
Rob最核心的观点是:仪式感应当匹配风险等级。改个按钮颜色不需要PRD、任务拆解、五轴arena评审或安全审计——直接改、自己看一眼即可;小功能走一遍grill me加测试驱动开发;大而模糊的功能才需要spec与分阶段计划;只有涉及生产、安全或不可逆操作时,才请出完整评审、怀疑驱动开发与安全加固。
连Addy本人都建议采取"渐进式、验证优先"的落地策略,不要一口气装25个技能全跑。这里有现实成本:每安装一个技能,Agent都要纳入考量,过多技能还可能被误触发,徒增上下文膨胀与困惑。更多技能并不等于更聪明的Agent。
上下文膨胀(context bloat)是当前大语言模型在实际工程使用中的一个具体限制。每个AI Agent在处理请求时都依赖一个有限的上下文窗口,其中包含对话历史、已加载的技能文件、代码片段和系统指令。当技能数量过多时,Agent需要在每次响应前处理大量与当前任务无关的指令,不仅消耗token配额,还可能导致模型在众多规则中产生歧义或误触发——例如一个本用于安全审计的技能被意外应用到日常的样式修改上。这也是为什么Rob和Addy都建议"按需激活"而非"一次性全装":精简的上下文让Agent更专注,减少噪音,实际效果往往优于堆砌规则。
技能的本质:好的工程实践与你自己的工作方式
归根结底,学习这些技能其实就是在学扎实的软件工程实践——测试驱动开发、小纵切片、构建前先对齐需求、把决策理由写下来、搞清楚栅栏为何存在之前别拆、以及真正对着现实证明它能跑(看到绿灯测试并不代表应用真的工作)。
这些都不是新东西:Matt致敬《程序员修炼之道》与领域驱动设计,Addy本质是Google的工程规范,Lauren则源自多年React与Meta经验。技能只是把这些理念变成Agent能执行的格式。
因此,不要把任何一套包当成教条,而应把它当作O'Reilly教材:安装、通读、取其所用,再在上面构建自己的技能。随着模型越来越强,Rob认为技能如今更多是在表达"我喜欢这样工作",而非真的教Agent新知识。他建议开发者定期检视并精简自己的agents.md和已有技能——你会惊讶于模型本身有多强。
每次Agent出错时,别对它发火,而是基于新认知去更新你的技能。这正是这三套包被打造出来的方式,也是你构建属于自己的"工作范式"的方式。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。