SceneBloom:智能体框架生成逼真3D室内场景
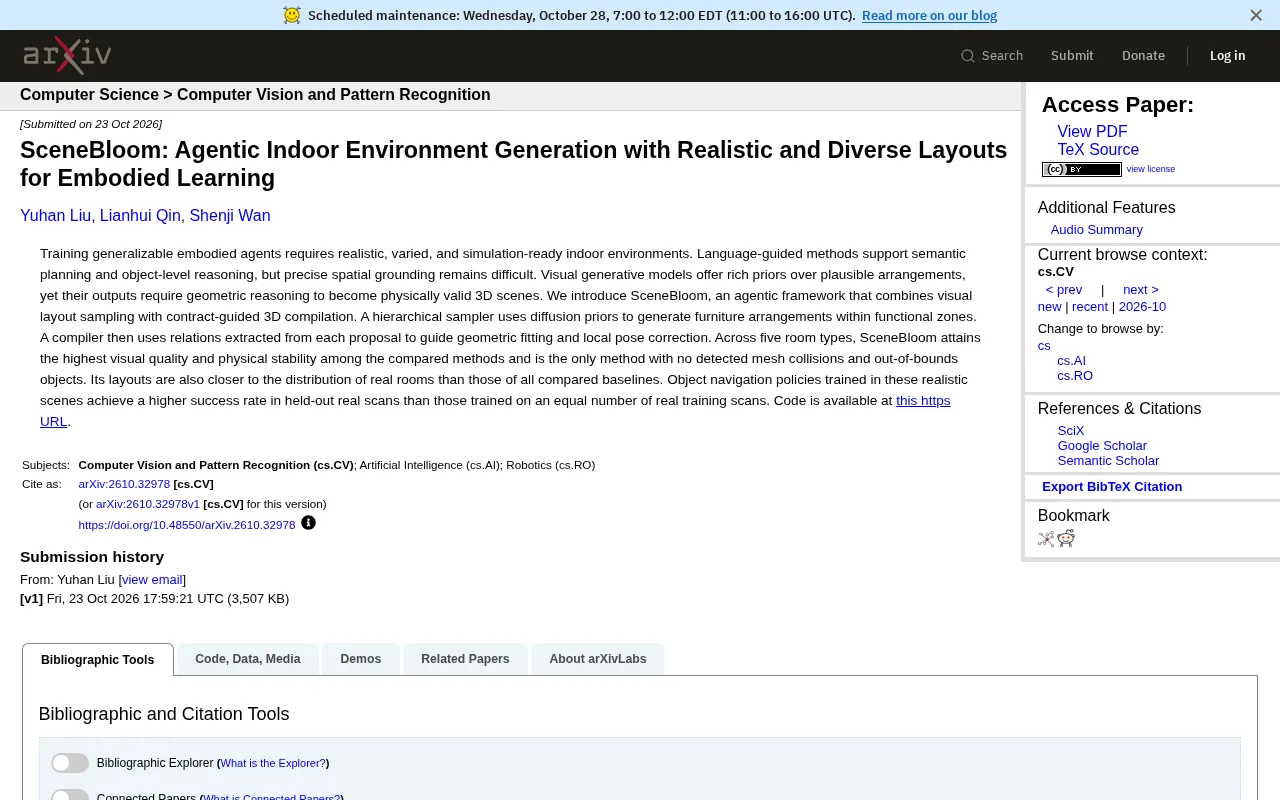
SceneBloom用扩散采样与合约编译两阶段框架自动生成物理有效的3D室内场景。
SceneBloom 是一个面向具身智能数据需求的智能体框架,旨在自动生成高质量、无碰撞的3D室内场景。它采用两阶段流程:分层采样器利用扩散模型先验,在功能区域内生成家具布局提案;合约引导的3D编译器则从提案中提取物体间空间关系,进行几何拟合与姿态修正,确保场景物理有效。实验在五种房间类型上对比现有方法,SceneBloom 在视觉质量和物理稳定性上均最优,且是唯一没有网格碰撞和越界物体的方法,布局分布也更接近真实房间。更关键的是,在其生成场景中训练的导航策略,在真实扫描数据上的成功率高于使用等量真实数据训练的策略,表明生成场景可作为具身学习的有效数据来源。
SceneBloom:智能体框架生成逼真3D室内场景
训练具身智能体需要大量真实、多样且可直接用于仿真的室内环境。然而,人工构建这样的场景成本高昂,而现有生成方法又难以兼顾视觉合理性与物理有效性。SceneBloom 提出了一种智能体框架,通过结合视觉布局采样与合约引导的3D编译,自动生成高质量、无碰撞的室内场景,为具身学习提供了新的数据来源。
为什么需要自动生成室内场景?
具身智能体(如家庭服务机器人)需要在各种室内环境中导航和操作物体。为了训练出泛化能力强的智能体,研究者需要海量、多样且物理上合理的3D场景。真实扫描数据虽然逼真,但数量有限、覆盖场景类型不均;手工搭建仿真环境则耗时费力,难以规模化。
语言引导的方法能够根据文本描述生成场景布局,支持语义规划和物体级推理,但在精确的空间定位上仍存在困难。视觉生成模型则提供了丰富的布局先验,但其输出需要进一步的几何推理才能转化为物理有效的3D场景。SceneBloom 正是为了弥合这一差距而设计。
具身智能体(Embodied Agent)指能够在物理或仿真环境中感知、决策并执行动作的智能系统,例如家庭服务机器人、自动驾驶车辆或虚拟角色。与仅在文本数据上训练的模型不同,具身智能体的能力高度依赖与环境的交互经验,因此训练数据的“环境多样性”和“物理真实性”至关重要。真实世界数据采集成本高、覆盖有限,而仿真环境可以无限生成并精确标注,但手工搭建耗时且难以规模化。SceneBloom 瞄准的正是这一数据瓶颈:用生成模型自动产出可直接用于仿真的3D室内场景,从而为具身学习提供可扩展的数据引擎。
SceneBloom:两阶段智能体框架
SceneBloom 的核心是一个两阶段流程:先由分层采样器生成家具布局提案,再由编译器将其转化为物理合理的3D场景。
分层采样器:扩散先验生成布局
分层采样器利用扩散模型的先验知识,在功能区域内生成家具排列。它将房间划分为不同的功能区域(如休息区、工作区),然后在这些区域内采样家具的位置和朝向。这种分层策略既保证了布局的多样性,又确保了功能上的合理性——例如沙发通常面向电视,书桌靠近窗户。
扩散模型(Diffusion Model)是一类生成模型,通过学习逐步去噪的过程来从随机噪声中恢复数据分布。在场景生成任务中,扩散模型可以学习大量真实室内布局的统计规律,从而在给定房间轮廓和功能区域时,采样出符合人类习惯的家具摆放方案。所谓“先验”即模型从训练数据中学到的布局分布知识,它使采样器无需显式规则就能生成多样且合理的提案。但扩散模型的输出本质上是概率性的二维或抽象布局,并不保证物体不重叠或符合物理约束,这正是后续编译器需要介入的原因。
合约引导的3D编译器:从提案到物理有效场景
采样器输出的只是2D或抽象的布局提案,编译器负责将其转化为真正的3D场景。编译器从每个提案中提取物体间的关系(如“椅子在桌子旁边”“床靠墙”),并以此为指导进行几何拟合和局部姿态修正。通过这种方式,SceneBloom 确保了生成的场景中物体不会相互穿透、不会超出房间边界,且姿态符合物理常识。
合约(Contract)在这里指从布局提案中提取出的物体间空间关系约束,例如“椅子与桌子距离在0.3至0.8米之间”“床的一侧紧贴墙面”“沙发正对电视”。这些约束将抽象的2D布局转化为可执行的几何条件,编译器据此在3D资产库中检索并拟合模型,再通过局部姿态修正满足碰撞检测和边界约束。合约引导的思路类似于程序合成中的规范驱动生成:先声明“要满足什么”,再求解“如何摆放”,从而在保持生成多样性的同时确保物理有效性。
实验结果:视觉质量与物理稳定性领先
研究者在五种房间类型上对比了SceneBloom与现有方法。结果显示,SceneBloom 在视觉质量和物理稳定性上均达到最高水平,并且是唯一没有检测到网格碰撞和越界物体的方法。此外,其生成的布局分布比所有基线方法都更接近真实房间的分布。
更关键的是,在这些生成场景中训练的物体导航策略,在未参与训练的真实扫描数据上取得了比使用等量真实训练扫描更高的成功率。这表明SceneBloom生成的场景不仅看起来逼真,还能有效用于训练具身智能体,甚至可能弥补真实数据的不足。
对具身学习的意义与展望
SceneBloom 的价值在于它提供了一条自动化生成高质量仿真环境的路径。与依赖人工搭建或有限真实扫描的传统方法相比,SceneBloom 能够按需生成多样化的场景,且保证物理有效性。这为具身智能的研究提供了可扩展的数据引擎。
当然,当前方法仍有一些局限。例如,它主要关注家具布局,对于更细粒度的物体(如桌面上的小物件)可能尚未覆盖;生成的场景多样性受限于扩散模型的先验分布;合约的提取和编译过程也可能引入误差。未来工作可以探索更丰富的场景元素、更精确的物理模拟以及与其他模态(如文本、语音)的交互。
SceneBloom 的代码已在GitHub开源,为后续研究提供了可复现的基础。随着具身智能的兴起,这类场景生成工具将变得越来越重要。
相关推荐
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。
671B开源大模型+11万条数据:AI落地门槛真降了?
671B参数顶级开源大模型开放权重与训练配方,连同11万条调优数据全部公开。本文分析这次开源对AI落地门槛的真实影响,以及转行者如何从应用层切入大模型赛道。
免费Agentic编程工具实战:让Java Web开发效率翻倍
Vodden agentic编程工具包完全免费,包含MCP文档服务器、Skills规范库、Agent Tools确定性检查和DevLoop构建验证闭环。实测显示全套工具可让AI编码代理通过基准测试,耗时减少约30%,token减少约20%。本文拆解各组件功能、实测数据与安装方式。