SFT为何比RFT更易遗忘?风格漂移揭示监督微调的隐性代价

新论文从数学上证明SFT比RFT更易遗忘,根源在于教师风格偏好引发的"离轴风格漂移",而非语义错误。
一篇arXiv论文《Learning Style, Forgetting Semantics》通过线性-softmax策略模型,将参数更新精确分解为语义分量和风格分量,从理论上解释了为何监督微调(SFT)比强化微调(RFT)更容易造成灾难性遗忘。研究发现,两种方法在语义更新方向上完全一致,但SFT会因教师示范存在非均匀风格偏好,在种群更新层面产生"离轴风格漂移",将与语义无关的风格信息写入模型参数,进而干扰已有能力。理论证明SFT的遗忘存在严格正下界,而RFT可维持零语义误差。这一结论为RLHF等基于奖励信号的方法在保持通用能力方面的优越性提供了数学层面的机制解释,对持续学习和多任务微调的方法设计具有重要参考价值。
SFT为何比RFT更易遗忘?风格漂移揭示监督微调的隐性代价
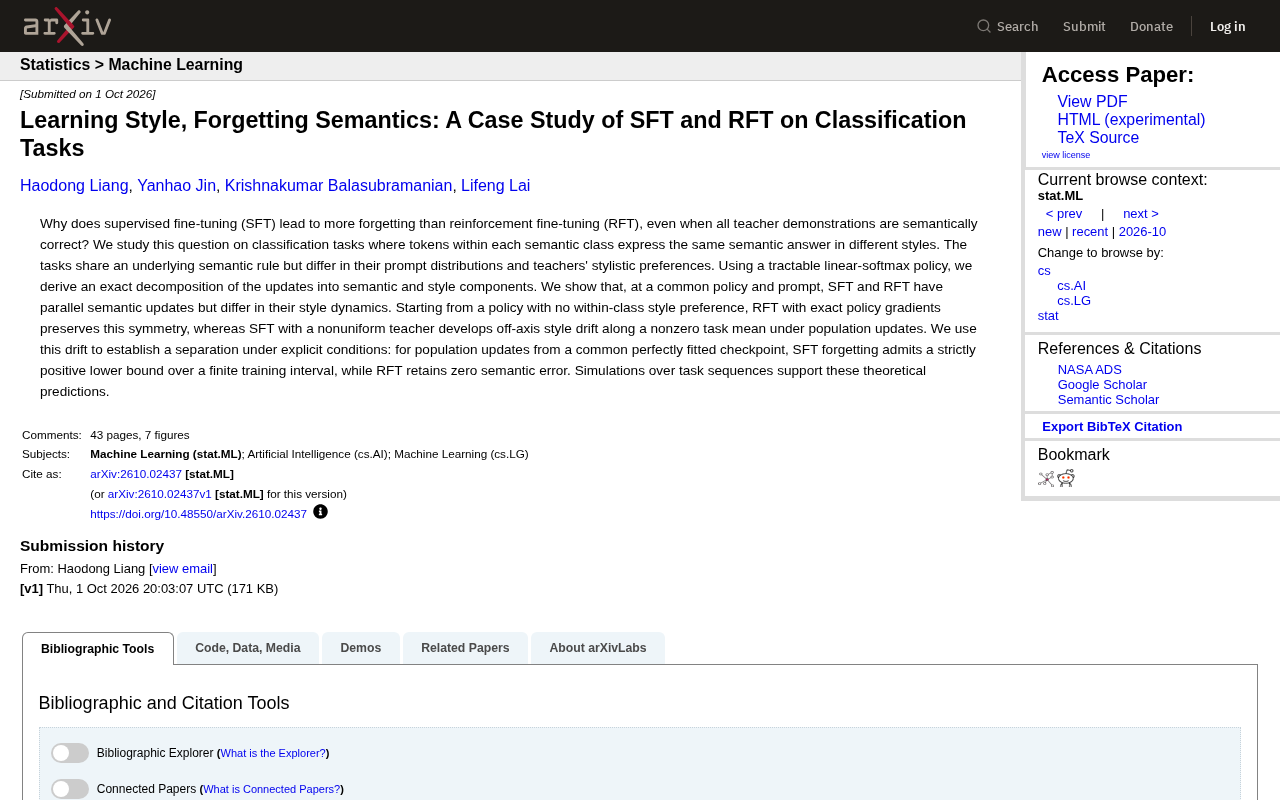
在大模型的持续训练与微调实践中,一个长期困扰研究者的现象是:监督微调(SFT, Supervised Fine-Tuning)往往比强化微调(RFT, Reinforcement Fine-Tuning)带来更严重的灾难性遗忘。这一现象的反直觉之处在于——即便教师示范(teacher demonstrations)在语义层面完全正确,SFT依然会丢失此前学到的知识。一篇新发布的arXiv论文《Learning Style, Forgetting Semantics》通过严谨的理论建模,给出了这一问题的数学解释。
问题的核心:语义正确为何仍会遗忘
论文聚焦于分类任务这一相对可控的场景。在这类任务中,同一语义类别内的不同token表达的是相同的语义答案,但呈现出不同的"风格"(style)。多个任务共享同一套底层的语义规则,差异仅在于提示分布(prompt distribution)和教师的风格偏好。
这种设定巧妙地把"语义"和"风格"这两个维度解耦开来。研究的关键追问是:当所有教师示范在语义上都正确时,遗忘究竟从何而来?答案并不在语义层面,而隐藏在风格的动态变化之中。
灾难性遗忘(Catastrophic Forgetting)是神经网络在顺序学习多个任务时的经典难题:模型在学习新任务时,旧任务的性能会急剧下降。其根本原因在于,梯度更新会覆盖对旧任务至关重要的权重。传统的缓解方案包括弹性权重巩固(EWC)、经验回放(Replay)等,但这些方法均从参数正则化或数据层面入手,并未深入分析不同训练范式(SFT vs. RFT)在更新方向上的结构性差异。本文的创新正在于此:它不问"如何防止遗忘",而是追问"为什么SFT的更新结构天然更容易遗忘",从而将问题从工程补丁层面提升到了机制分析层面。
理论工具:线性-softmax策略的精确分解
为了让问题可解,作者采用了一个可处理的线性-softmax策略(linear-softmax policy)模型。基于这一模型,他们推导出了参数更新的精确分解(exact decomposition),将每一步更新明确拆分为语义分量和风格分量两部分。
这种分解是整篇论文的分析基石。它使得研究者能够在同一策略、同一提示条件下,直接对比SFT与RFT两种方法在更新方向上的差异,而不必依赖模糊的经验观察。
线性-softmax策略是强化学习与自然语言处理交叉研究中常用的可处理近似模型:输出层将线性变换的隐状态通过softmax函数映射为概率分布。这一设定虽比完整的Transformer简化,但保留了分类决策的核心代数结构,允许对梯度进行闭式(closed-form)推导。在SFT中,参数更新的方向由教师token的对数概率梯度决定;在RFT(或策略梯度方法)中,更新方向由模型自身采样结果的奖励加权梯度决定。这种结构差异正是论文分解的出发点——两者的语义分量方向相同,但RFT的风格分量因奖励信号的对称性而相互抵消,SFT则因教师风格偏好不均匀而留下非零余项。
关键发现:语义更新一致,风格动态分道扬镳
论文得出的核心结论可以概括为一句话:SFT和RFT在语义更新上是平行的(一致的),但在风格动态上截然不同。
具体来看:
-
RFT的对称性保持:从一个没有类内风格偏好的策略出发,使用精确策略梯度(exact policy gradients)的RFT能够保持这种对称性。换句话说,RFT不会凭空引入风格上的偏向。
-
SFT的离轴风格漂移:而当教师本身具有非均匀(nonuniform)的风格偏好时,SFT会在种群更新(population updates)下沿着非零的任务均值产生"离轴风格漂移"(off-axis style drift)。正是这种漂移,成为遗忘的根源。
这一对比揭示了一个深刻的机制:SFT之所以更容易遗忘,不是因为它学错了语义,而是因为它被迫模仿了教师的风格偏好,从而在风格子空间中发生了无谓的参数偏移。
种群更新(Population Updates)指的是在多个任务或多条数据分布上取期望后的参数更新,与单样本随机梯度更新相对。论文在种群更新层面分析风格漂移,意味着结论排除了随机噪声的影响,反映的是训练范式本身的系统性偏差。"类内风格对称性"(intra-class style symmetry)是指:在同一语义类别下,不同风格token出现的频率是均匀的,模型对它们没有先验偏好。RFT在这一前提下的"对称性保持"结论说明,只要初始策略风格中性,策略梯度更新不会打破这种均匀性;而SFT因为直接模仿教师,会将教师的风格偏好"转印"到模型权重中,即使该偏好对语义正确性毫无贡献。
理论分离:SFT遗忘的严格下界
论文进一步在明确条件下建立了两种方法之间的"分离"(separation)结论。对于从同一个完美拟合的检查点(perfectly fitted checkpoint)出发的种群更新:
-
SFT的遗忘存在严格正下界:在有限的训练区间内,SFT造成的遗忘有一个严格大于零的下界——也就是说,遗忘在数学上是不可避免的。
-
RFT保持零语义误差:相比之下,RFT能够维持零语义误差。
这一分离结论从理论上证明了RFT在抗遗忘方面的优势并非偶然,而是由两种训练范式的本质差异决定的。作者还通过在任务序列上的模拟实验,验证了这些理论预测。
对实践的启示
尽管论文建立在简化的分类任务和线性-softmax模型之上,其洞见对实际的大模型训练仍有参考价值。
对于持续学习(continual learning)和多任务微调场景,这项研究提示我们:风格层面的信息,即便语义正确,也可能成为破坏已有能力的隐性因素。当教师数据存在风格偏好时,直接用SFT模仿这些示范会把不必要的风格偏移写入模型参数。
这也从侧面解释了为什么近年来RLHF、RFT等基于奖励信号的方法在保持模型通用能力方面表现更稳健——它们优化的是结果的正确性,而非对特定风格示范的逐token模仿,从而避免了风格漂移带来的副作用。
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)是目前主流大模型对齐的核心范式:先用人工标注的偏好数据训练一个奖励模型,再用该奖励模型通过PPO等算法微调语言模型。与SFT的逐token模仿不同,RLHF优化的目标是整体输出序列的奖励分数,模型可以在风格上自由探索,只要最终结果被奖励模型认可即可。本文的理论框架从参数更新的数学结构上为RLHF/RFT的通用能力保留优势提供了新的解释视角:奖励信号的结果导向使得风格分量的更新具有天然的抵消效应,而非像SFT那样将教师的特定风格偏好固化进模型权重。这一视角也提示,在设计持续学习方案时,将奖励信号引入微调流程(哪怕是规则奖励而非人工标注)可能比纯SFT更有利于能力保留。
结语
这篇论文的价值在于,它把一个被广泛观察到的经验现象,提炼成了可以用数学精确刻画的机制。"学到了风格,忘掉了语义"这一标题精准地概括了SFT的隐性代价。对于关注大模型训练方法论的研究者和工程师而言,理解语义与风格在参数更新中的解耦,有助于设计出更抗遗忘的微调策略。
相关推荐

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。

承诺的新工作室去哪了?Craft Computing用五年时间给出答案
Craft Computing主理人回应观众质疑:承诺五年的新工作室因建设成本从3万暴涨至7.5万美元而搁浅,最终改为168平方英尺车库改造空间。频道收入因算法变化下滑,内容方向也将转向更务实的项目制作。