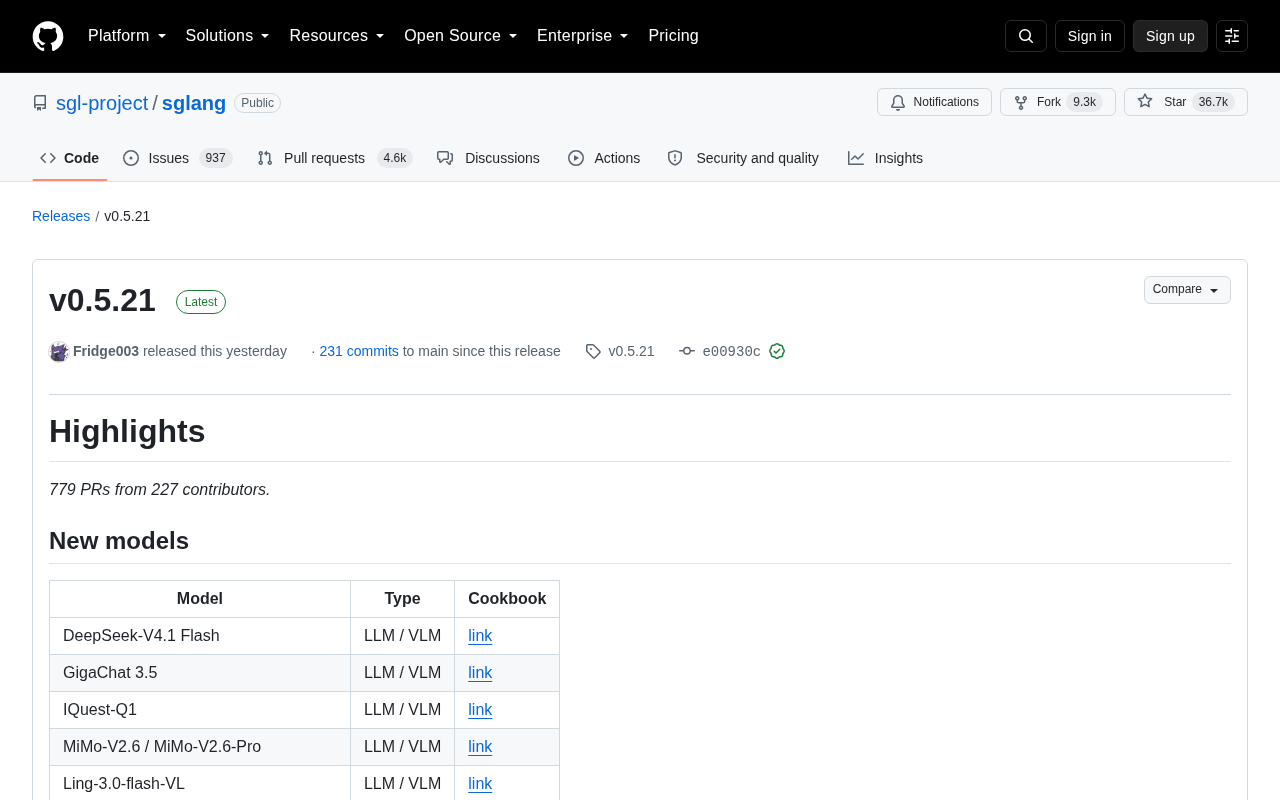
SGLang v0.5.21 发布:PD 角色热切换与 Rust 前缀缓存

SGLang v0.5.21 发布,带来PD热切换、Rust前缀缓存、新判别API及多模型多硬件支持的全链路优化。
SGLang v0.5.21 是一次覆盖推理服务全链路的系统性升级,汇集了779个PR的改动。核心亮点包括:Prefill/Decode实例支持运行时角色热切换,无需重启即可动态应对负载变化;前缀缓存核心切换为性能更优的Rust实现并设为默认;新增Decisions API与Score API,将生成式模型包装为低延迟的判别任务接口。性能层面,DeepSeek-V4.1长prompt首token速度提升22%,Kimi K3 prefill吞吐提升20.6%,agentic场景p99 token间延迟下降43.9%。此外,版本还新增了多款LLM、VLM及扩散模型的开箱支持,并覆盖NVIDIA、AMD、Intel多硬件平台,整体工程价值相当可观。
SGLang v0.5.21 发布:性能、调度与新模型全面升级
SGLang 作为当下最受关注的大模型推理框架之一,近日发布了 v0.5.21 版本。此次更新汇集了来自 227 位贡献者的 779 个 PR,覆盖投机解码、并行与分离式部署、量化、缓存系统等多个核心领域,同时新增了对一批大模型与扩散模型的支持。对于关注推理性能与部署效率的团队而言,这个版本带来了不少值得深入了解的改动。
PD 角色热切换:分离式部署更灵活
本次版本最具代表性的能力之一,是 Prefill/Decode(PD)实例可以在运行时动态切换角色,无需重启服务(#28403)。在分离式架构(Prefill-Decode Disaggregation)中,prefill 与 decode 阶段通常分配给不同实例以提升吞吐,但固定的角色分配难以应对动态变化的负载。运行时角色切换意味着集群可以根据实时请求结构调整资源分配,让计算密集的 prefill 与访存密集的 decode 更好地匹配实际流量。
围绕 PD 的改进还有一长串。例如通过 request-owned speculative KV 降低 decode 启动延迟,在 DeepSeek广告-V4-Pro 1P1D、MI355X、并发 256 的场景下,平均 TTFT(首 token 时间)从 19.4 秒降至 15.1 秒(#38978);在 Kimi Linear、8 卡 B200 并发 8 的测试中,cached-prefix 吞吐提升约 10.9 倍(#40376)。这些数据表明团队在分离式部署的调度与 KV 传输链路上投入了大量工程优化。
Prefill-Decode Disaggregation(PD 分离架构) 是大模型推理领域的一种重要优化思路。在传统部署中,同一 GPU 实例同时承担 prefill(处理输入 prompt,计算密集型)和 decode(逐 token 生成,访存密集型)两个阶段,两者的硬件需求截然不同,混合运行会导致 GPU 利用率不均衡。PD 分离架构将这两个阶段拆分到不同实例上:prefill 实例负责高并行度的矩阵运算,decode 实例专注于 KV Cache 的频繁读写,从而各自针对性地优化硬件配置与批处理策略。
TTFT(Time To First Token,首 token 时间) 是衡量用户感知延迟的核心指标,代表从发送请求到收到第一个输出 token 的时间,主要受 prefill 阶段耗时影响。ITL(Inter-Token Latency,token 间延迟) 则衡量 decode 阶段每生成一个新 token 的平均/百分位耗时,直接影响流式输出的流畅度。两者共同决定了推理服务的整体用户体验。
Rust 前缀缓存成为默认实现
缓存系统是推理框架性能的关键环节。此版本将前缀缓存(prefix cache)的核心切换为 Rust 实现,并设为默认(#39627)。Rust 版本的 TreeCore 相比原有实现在内存管理与并发安全上更具优势,同步替换默认后端反映出该实现已达到生产可用的成熟度。
统一的 Radix Cache 还新增了 Agentic-Aware 尾部优化 LRU 淘汰策略(可选开启)。在 DeepSeek-V4-Pro FP4、4 卡 B300 的 agentic 轨迹测试中,并发 32 时 p99 ITL(token 间延迟)下降 43.9%(#34012)。针对 agentic 工作负载特有的长尾缓存访问模式进行专门优化,说明框架正在主动适配智能体类应用的新型负载特征。
前缀缓存(Prefix Cache) 也称 KV Cache 复用,是推理加速的重要手段。大模型在处理每个 token 时会产生 Key-Value 张量,这些张量可以跨请求复用:若多个请求共享相同的前缀(如相同的 system prompt 或对话历史),则该部分的 KV 计算可直接从缓存读取,无需重新计算,显著降低 TTFT 并提升吞吐。Radix Tree(基数树) 是实现高效前缀匹配的核心数据结构,能以树形结构存储不同长度的前缀路径,支持 O(n) 级别的快速查找与共享节点复用。
LRU(Least Recently Used)淘汰策略 是缓存管理中最常用的策略,优先驱逐最久未被访问的缓存块。而针对 agentic 工作负载设计的"Agentic-Aware 尾部优化 LRU"对此进行了改进——智能体应用往往会在长轨迹末尾频繁追加新内容,普通 LRU 可能过早淘汰即将再次被访问的尾部缓存块,专用策略通过识别这类访问模式来提升缓存命中率。
新增分类与打分 API
除了推理性能,v0.5.21 还在接口层面扩展了 LLM/VLM 的使用场景。新引入的 Decisions API(/v1/decisions)可以将大模型变成低延迟的分类器与打分器(#41208),而 Score API(/v1/score)支持在单次请求中对所有候选项进行打分(#38965、#41188)。
这类 API 的意义在于把生成式模型的能力包装为更结构化、更可控的判别任务输出。对于需要用 LLM 做意图识别、内容审核、候选排序的场景,专用接口可以避免解析自由文本输出带来的不确定性,同时在延迟上更可预期。
投机解码与模型加速
投机解码(Speculative Decoding)在本版本有密集更新,包括 Pipeline 并行与 EAGLE/MTP 的兼容性(#30775)、XQA 后端支持(#32269),以及面向多种模型的 DFlash 草稿方案。其中 LFM2-VL 通过 DSpark 投机解码在 batch 1 下获得 1.66x 到 2.56x 的加速(#40651)。
针对具体模型的提速同样显著:DeepSeek-V4.1 在长 prompt 下首 token 速度提升 22%(#40352);Kimi K3 在 PD 服务中 prefill 吞吐提升 20.6%(#40045);GLM-5.3-Flash 已能在 AMD MI355X 上运行,并支持 FP8/MXFP4 MoE 与 MTP 投机解码(#38546 等)。多硬件平台(NVIDIA CUDA 13、AMD MI35x/MI30x、Intel GPU/CPU)的 Docker 镜像也同步提供。
投机解码(Speculative Decoding) 是一种通过"小模型猜测 + 大模型验证"来加速自回归生成的技术。其核心思路是:用一个小型草稿模型(Draft Model)快速生成若干候选 token,再由目标大模型一次性并行验证,若草稿正确则直接接受,从而将原本串行的多步解码合并为一次前向传播,大幅提升吞吐与速度。EAGLE(Extrapolation Algorithm for Greater Language-model Efficiency) 和 MTP(Multi-Token Prediction) 是两类主流的草稿生成方案:EAGLE 利用目标模型的特征层训练轻量草稿头,MTP 则通过训练模型同时预测多个未来 token 来实现免额外模型的投机推理。两者与 Pipeline 并行结合的兼容性改进,使投机解码能在多卡分布式场景下稳定运行。
新模型支持
版本新增了一批模型的开箱支持,LLM/VLM 包括 DeepSeek-V4.1 Flash、GigaChat 3.5、IQuest-Q1、MiMo-V2.6 系列、Ling-3.0-flash-VL;扩散模型方面涵盖 DiffusionGemma、Qwen-Image 2.1、Anima Base v1.0、Ming-Image 0.1 以及 FLUX 3 Action。此外,MiniMax-H3 可通过 SGLang Diffusion 在 ComfyUI 中运行(#35990),进一步打通了与现有生态工具的协作。
升级方式
升级到该版本可使用:
uv pip install --prerelease=allow sglang==0.5.21
或拉取对应平台的 Docker 镜像,例如 NVIDIA(CUDA 13)环境:
docker pull lmsysorg/sglang:v0.5.21
小结
整体来看,SGLang v0.5.21 不是单点突破,而是围绕推理服务全链路的系统性打磨:从 PD 角色热切换、Rust 前缀缓存,到数值精度正确性修复、调度策略增强,再到判别类 API 与多硬件支持。对追求高吞吐、低延迟且需要应对复杂负载(尤其是 agentic 场景)的推理部署来说,这个版本的工程价值相当可观。
相关推荐
人类能离太阳多近?帕克探测器穿越日冕的科学原理
人类能离太阳多近?NASA帕克太阳探测器曾飞至光球层上方380万英里,深入数百万度的日冕。本文解析为何探测器不会被汽化——温度与热量的区别、阳光强度及隔热罩设计的科学原理。
从空气中制造汽油:合成燃料为何尚未普及?
合成燃料能用空气中的二氧化碳、水和电力制造汽油、甲烷和火箭推进剂。本文解析萨巴蒂埃反应与费托合成的化学原理、热力学税、碳中和账本,以及合成燃料为何尚未普及、又将如何重塑能源地缘格局。
Router Rumble:用WiFi路由器演示梯度下降为何败给NSGA-II
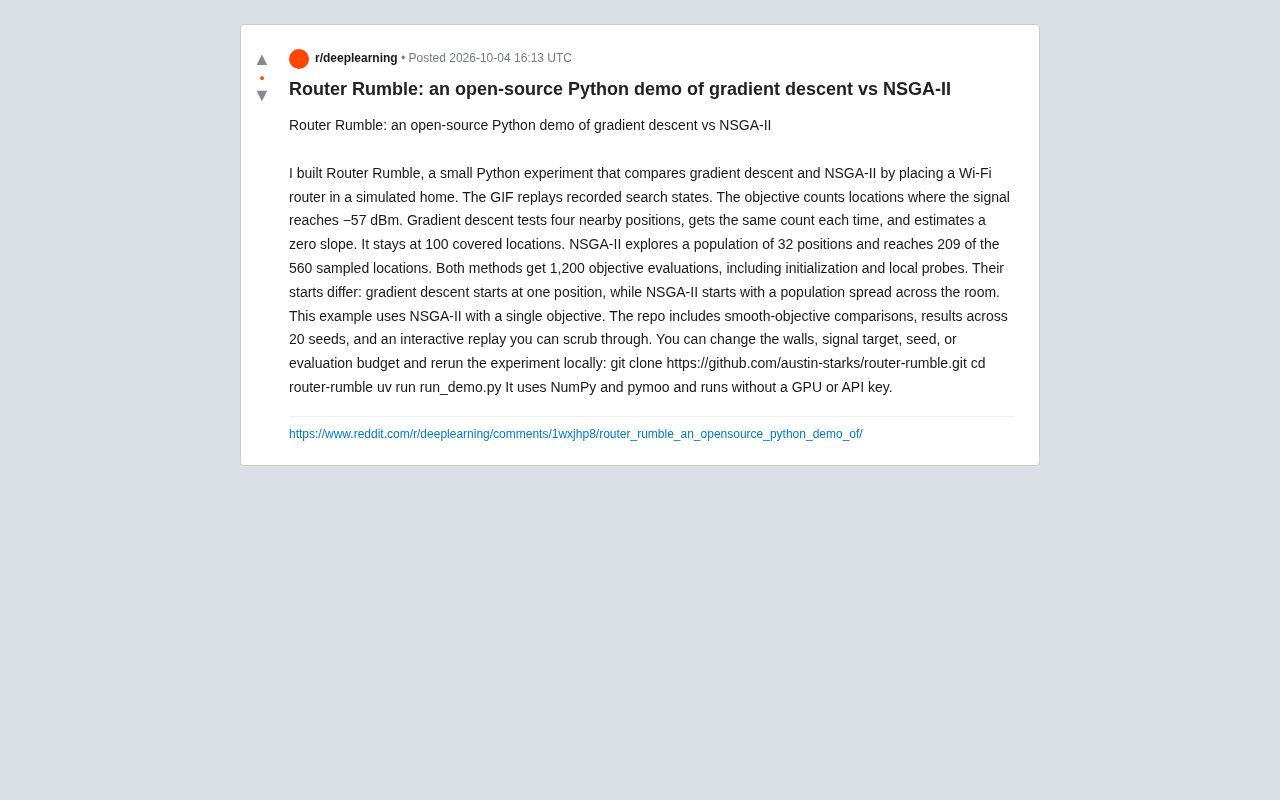
Router Rumble 是一个开源 Python 项目,通过在模拟房间摆放 WiFi 路由器,直观对比梯度下降与 NSGA-II 进化算法在离散目标函数上的表现,揭示无梯度优化方法的优势。