删权重也能微调?Deletion Tuning 新方法引关注

Deletion Tuning 仅删除不到 0.05% 的权重,即可在多种后训练任务中匹敌全量微调。
本文介绍了一种名为 Deletion Tuning 的后训练方法:它不调整大量参数,而是学习一个二值掩码,将 Transformer 块门控投影中不到 0.05% 的权重置零。在带可验证奖励的强化学习、监督微调和同策略蒸馏三种场景下,该方法性能与全量微调相当。其优势在于检查点体积比全量微调小数百到数千倍,且在持续学习中大幅缓解灾难性遗忘——强化学习设置下旧任务准确率接近基座模型,而全量微调、LoRA 和随机稀疏微调最多损失 5.4 个百分点。几何分析显示,Deletion Tuning 在稳定秩、谱漂移和主权重重叠三个指标上最接近全量微调,暗示有效微调可能集中于少数关键权重的抑制而非大规模重塑。
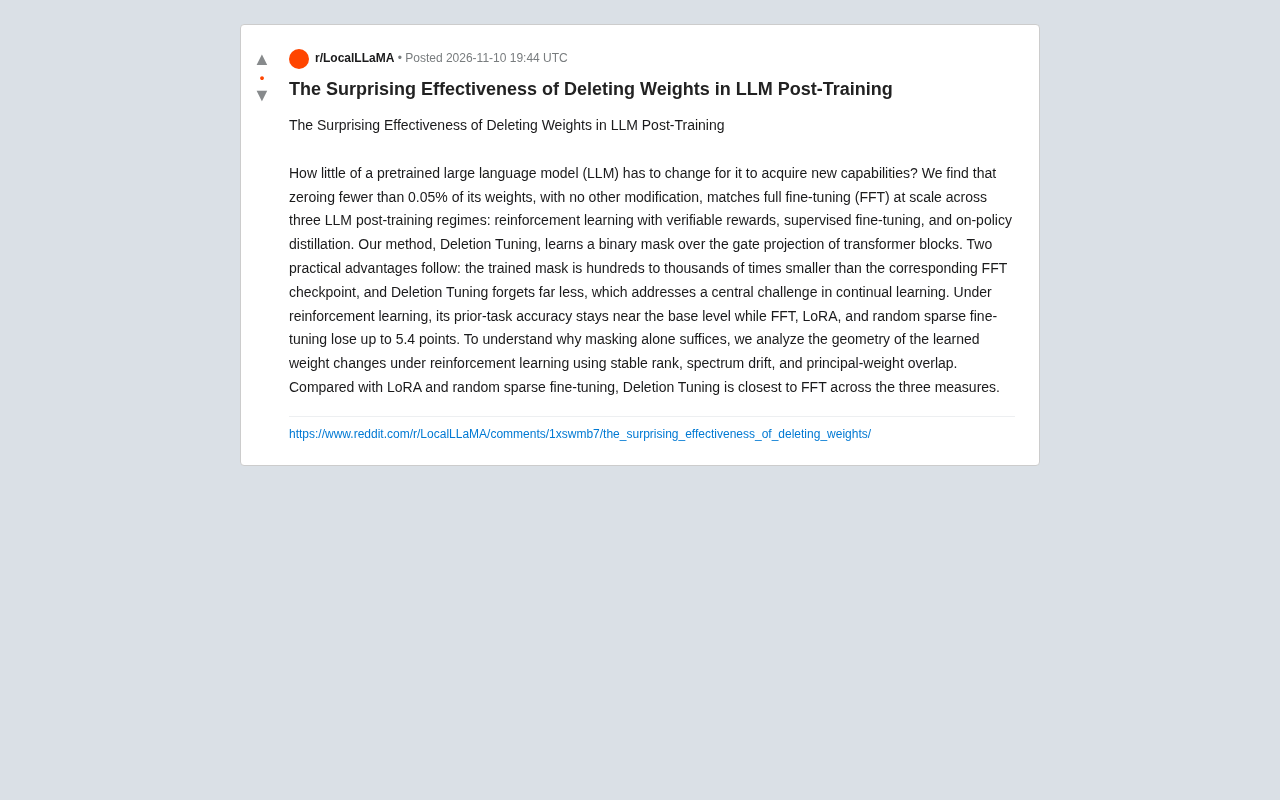
大模型后训练通常意味着调整大量参数,但一项新研究提出了截然不同的思路:只删除极少数权重,就能达到全量微调的效果。这篇来自 Reddit 的讨论聚焦于一种名为 Deletion Tuning 的方法,它通过将 Transformer 块门控投影中不到 0.05% 的权重置零,在强化学习、监督微调和同策略蒸馏三种后训练场景下,表现与全量微调(FFT)相当。
核心发现:删除比调整更有效
研究团队发现,预训练大模型要获得新能力,并不需要大规模修改权重。他们提出的 Deletion Tuning 方法学习一个二值掩码,作用于 Transformer 块的门控投影上,将选定权重置零。令人意外的是,这种极简操作在三种后训练范式下均能匹配全量微调的性能:
- 带可验证奖励的强化学习(RLVR)
- 监督微调(SFT)
- 同策略蒸馏(on-policy distillation)
这意味着,模型能力的适配可能更多依赖于抑制某些原有连接,而非重塑大量参数。该发现挑战了“微调必须大幅调整权重”的固有认知。
门控投影(gated projection)是 Transformer 块中前馈网络(FFN)或门控线性单元(GLU)结构里的关键组件。以常见的 SwiGLU 为例,FFN 包含三个投影矩阵:一个“门”投影负责产生经过激活函数的门控信号,一个“上”投影提供待门控的特征,二者逐元素相乘后再经“下”投影回到模型维度。门控投影决定了哪些中间特征被放大或抑制,对模型的表达能力和信息路由有直接影响。Deletion Tuning 将二值掩码施加于门控投影的权重上,意味着它精确干预了特征筛选环节,而非随意删除参数。这一位置选择可能是方法能以极少删除量匹敌全量微调的重要原因。
两大实用优势:存储与遗忘
Deletion Tuning 带来了两个直接的好处。
检查点体积大幅缩小
由于只学习一个二值掩码,训练得到的掩码比对应的全量微调检查点小数百到数千倍。这对于模型部署和版本管理意义重大——存储和传输成本显著降低,尤其适合需要频繁切换任务的场景。
检查点(checkpoint)是训练过程中保存的模型状态快照,通常包含全部可训练参数,因此一个全量微调检查点的体积与基座模型相当,动辄数十 GB。在多任务部署中,若每个任务都保存一份完整检查点,存储开销会随任务数线性增长。Deletion Tuning 只学习一个与门控投影形状相同的二值掩码,每个元素仅需 1 比特,因此其体积可比全量检查点小数百到数千倍。部署时只需保存基座模型和掩码,推理时按掩码将对应权重置零即可还原微调效果。这种“基座 + 掩码”的范式也便于版本管理:切换任务只需替换掩码文件,而无需搬运完整模型。
持续学习中的遗忘问题得到缓解
持续学习的一个核心挑战是灾难性遗忘。在强化学习设置下,Deletion Tuning 的先前任务准确率保持在基座模型水平附近,而全量微调、LoRA 和随机稀疏微调则最多损失 5.4 个百分点。这一对比表明,删除权重的方式对原有知识的破坏远小于传统微调。
灾难性遗忘(catastrophic forgetting)指模型在学习新任务时,其在新任务上的梯度更新会覆盖或干扰先前任务所依赖的权重,导致旧任务性能急剧下降。在持续学习场景中,模型需要依次适应多个任务,遗忘问题尤为突出。传统全量微调因大幅改动权重,对旧知识的破坏最大;LoRA 虽只更新低秩适配器,但适配器与原权重叠加后仍可能偏移原有表示。Deletion Tuning 只将少量权重置零,相当于在原有网络中做“减法”,对未删除权重的保留更为完整,因此在强化学习设置下旧任务准确率能维持在基座模型附近。这提示我们,微调对旧知识的破坏程度与权重改动幅度并不总是成正比,改动的“位置”和“方式”同样关键。
几何分析:为何掩码就足够?
为了理解掩码为何能替代权重更新,研究者从几何角度分析了强化学习下学习到的权重变化。他们使用了三个指标:
- 稳定秩(stable rank)
- 谱漂移(spectrum drift)
- 主权重重叠(principal-weight overlap)
与 LoRA 和随机稀疏微调相比,Deletion Tuning 在这三个指标上都最接近全量微调。这暗示,全量微调的有效变化可能集中在少数关键权重上,而删除这些权重恰好模拟了这种集中调整。
稳定秩(stable rank)是矩阵奇异值的一种归一化度量,定义为矩阵的 Frobenius 范数平方与谱范数平方之比。与普通秩不同,它反映奇异值分布的“有效维度”:若少数奇异值远大于其余,稳定秩会显著低于矩阵的维度,说明矩阵的能量集中在少数方向上。在分析微调时,稳定秩可用来判断权重更新是否集中——稳定秩越低,更新越集中于少数主方向。
谱漂移衡量微调后权重矩阵的奇异值谱相对预训练权重的整体偏移程度,通常以奇异值向量的距离来量化。谱漂移小,意味着微调没有大幅重塑矩阵的谱结构,原有信息通道基本保留。
主权重重叠关注微调前后主导奇异向量(即最大奇异值对应的方向)之间的对齐程度。重叠高说明微调主要沿预训练已存在的主方向进行微调,而非开辟全新方向。这三个指标共同刻画了权重变化的“集中性”与“连续性”,正是 Deletion Tuning 最接近全量微调的原因所在。
对微调实践的启示
这项研究为参数高效微调提供了新视角。传统方法如 LoRA 通过低秩适配器调整权重,而 Deletion Tuning 则直接删除权重,两者思路迥异。但前者需要引入额外参数,后者仅需一个掩码,在存储和遗忘控制上更具优势。
不过,该方法目前仍处于研究阶段,其通用性和在不同模型规模上的表现有待进一步验证。对于关注持续学习和高效微调的从业者,这无疑是一个值得跟踪的方向。
总结
Deletion Tuning 用不到 0.05% 的权重置零,在多种后训练任务中匹敌全量微调,同时大幅减少检查点体积和灾难性遗忘。几何分析进一步支持了其有效性。这项来自 Reddit 讨论的研究,为高效微调开辟了一条反直觉却颇具潜力的路径。
相关推荐
英伟达CEO黄仁勋绯闻风波:AI泡沫会被刺破吗?
英伟达CEO黄仁勋被曝与疑似中国间谍的女性有染,引发国家安全担忧和AI泡沫破裂风险。The Vergecast深入讨论事件细节、英伟达公关危机及对AI生态的潜在冲击。

英伟达CEO间谍丑闻:一场撼动AI帝国的风波
英伟达CEO黄仁勋承认与疑似中国间谍的女性有婚外情,事件涉及美国芯片出口限制与国家安全。本文分析其与特朗普的密切关系、英伟达的内部调查及国会简报要求,探讨AI巨头个人危机如何演变为系统性经济风险。

X-energy获批建首批小型模块化核反应堆
X-energy获得美国核管理委员会建设许可,将在得克萨斯州建造四座小型模块化核反应堆。本文分析该许可对SMR商业化部署的意义、从建设到发电的剩余环节,以及小型模块化反应堆面临的成本与供应链挑战。