上海AI Lab开源Sage-A1.5:35B MoE模型获vLLM首日支持,本地部署智能体
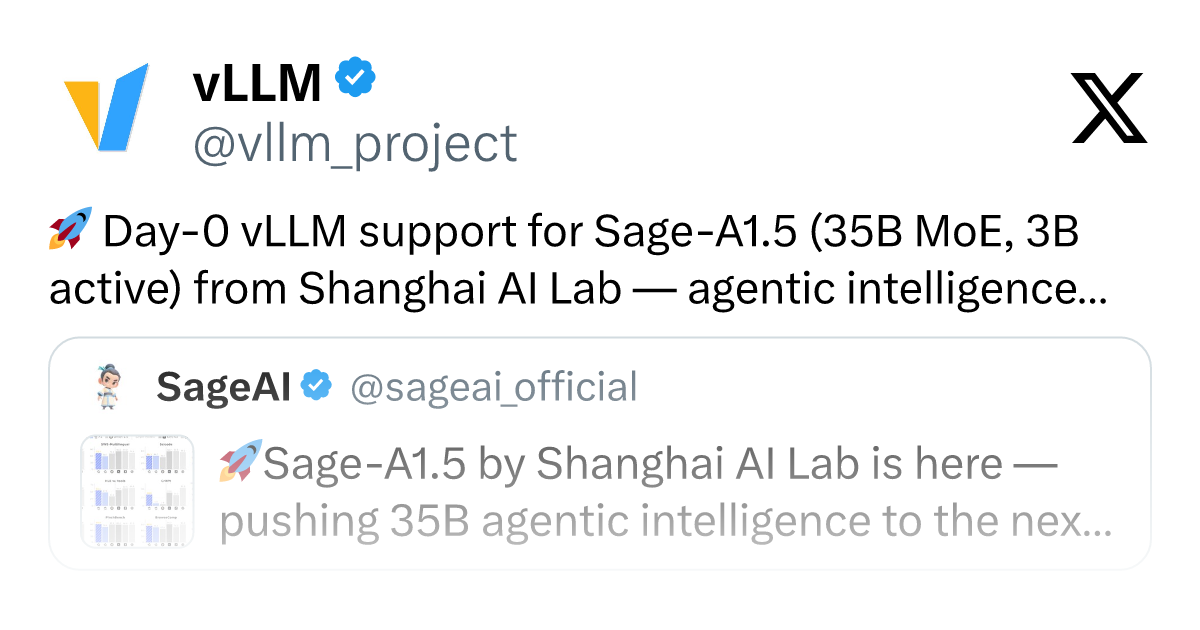
上海AI Lab发布35B总参数、3B激活的MoE模型Sage-A1.5,主打智能体场景与本地部署,获vLLM首日支持。
上海人工智能实验室推出开源模型 Sage-A1.5,采用 35B 总参数、仅激活约 3B 的混合专家(MoE)架构,在模型知识容量与单次推理开销之间取得平衡,使本地部署成为可能。模型定位为“智能体智能”(agentic intelligence),面向多步推理、工具调用等 agentic 场景。发布当天,主流推理引擎 vLLM 即宣布 Day-0 支持,开发者只需一行 `vllm serve` 命令即可启动兼容 OpenAI 接口的本地服务,无需等待社区适配。文章认为,模型发布与推理框架的同步适配正成为开源模型竞争的隐性标准;MoE 稀疏激活降低了硬件门槛,但 35B 权重体积与专家并行效率仍决定实际吞吐,需开发者结合自身硬件实测验证。
上海人工智能实验室(Shanghai AI Lab)在开源模型领域再落一子。其最新推出的 Sage-A1.5 模型以 35B 总参数、3B 激活参数的混合专家(MoE)架构亮相,主打“智能体智能”(agentic intelligence),并强调可在本地环境直接部署运行。更关键的是,推理框架 vLLM 在模型发布当天即宣布支持,开发者只需一行命令即可启动服务。
模型架构:35B 总参数,3B 激活的 MoE 设计
Sage-A1.5 采用 MoE(Mixture-of-Experts)架构,总参数量为 35B,但每次推理仅激活约 3B 参数。这种设计在模型容量与推理成本之间取得平衡:总参数规模决定了模型的知识容量和表达能力,而激活参数较少则意味着单次前向计算的开销显著降低。
对于本地部署场景,这一特性尤为重要。传统稠密模型若达到 35B 级别,推理时需加载全部权重并完成全量计算,对显存和算力要求较高。MoE 架构通过稀疏激活,让开发者在消费级或单卡工作站上跑起更大规模的模型成为可能。Sage-A1.5 的 3B 激活量级,大致相当于在推理开销上接近一个小型稠密模型,却能调用 35B 参数所承载的知识。
MoE(Mixture-of-Experts,混合专家)架构的核心思想是将模型的前馈网络拆分为多个并行的“专家”子网络,并引入一个路由(router/gating)机制,对每个输入 token 动态选择其中少数几个专家参与计算。因此“总参数”是所有权重之和,而“激活参数”是单个 token 实际经过的参数量。这种稀疏激活让模型可以在扩大参数规模(提升知识容量)的同时,把单次前向的 FLOPs 控制在远小于总参数的水平。代价是显存仍需容纳全部专家权重,且路由负载是否均衡、专家并行如何切分,会显著影响实际吞吐。DeepSeek广告、Mixtral 等模型均采用类似思路,Sage-A1.5 的 35B/3B 属于激活比很低的配置。
Day-0 vLLM 支持:一行命令启动服务
模型发布当天,vLLM 即宣布完成对 Sage-A1.5 的支持。开发者可以通过以下命令直接启动推理服务:
vllm serve InternScience/Sage-A1.5
vLLM 是目前开源社区广泛使用的高吞吐推理引擎,以其 PagedAttention 和连续批处理等优化著称。Day-0 支持意味着模型权重发布的同时,推理侧的工具链已经就绪,开发者无需等待社区适配或自行编写推理代码。对于希望快速验证模型能力、构建智能体应用的团队来说,这大幅降低了上手门槛。
从生态角度看,模型发布与推理框架的同步适配,正在成为开源模型竞争的一个隐性标准。一个模型能否在发布首日被主流推理框架支持,直接影响其被采用的速度。Sage-A1.5 在这件事上开了个好头。
vLLM 是加州大学伯克利分校团队发起、现由社区维护的开源大模型推理与服务引擎。其关键创新 PagedAttention 借鉴操作系统虚拟内存分页思想,把 KV Cache 切分为固定大小的块并按需分配,大幅减少显存碎片,从而显著提升并发吞吐;连续批处理(continuous batching) 则在序列级别动态调度,让新请求随时插入正在执行的批次。这些优化使 vLLM 成为生产环境部署的主流选择。所谓 Day-0 支持,指模型权重公开的当天,vLLM 已合入对应模型结构、tokenizer 与对话模板的适配代码,用户无需修改源码即可用 vllm serve 拉起兼容 OpenAI 接口的服务。
智能体智能:定位 agentic 场景
从官方描述看,Sage-A1.5 的定位是“agentic intelligence”——面向智能体场景的智能能力。这一定位与当前大模型应用的趋势吻合:越来越多的开发需求不再是单轮问答,而是让模型在环境中多步推理、调用工具、完成复杂任务。
智能体场景对模型的要求与聊天模型有所不同。它需要模型具备较强的指令遵循能力、多步规划能力,以及对工具调用格式的稳定性。Sage-A1.5 是否在这些维度上做了针对性优化,目前公开信息有限,但从其命名与宣传口径来看,智能体能力是核心卖点。开发者可以借助 vLLM 本地部署后,自行在工具调用、任务规划等场景中做验证。
Agentic intelligence(智能体智能) 通常指模型在“感知—规划—行动—观察”循环中自主完成长程任务的能力,而不只是生成单轮回复。其典型技术形态包括:以结构化格式(如 JSON)稳定输出工具调用请求、在多轮交互中维护任务状态、根据工具返回结果进行反思与纠错,以及在 ReAct、函数调用(function calling)等范式下做多步规划。评估此类能力常用的基准有工具调用类(如 BFCL)与交互式环境类(如 WebArena、SWE-bench)任务。这类场景对模型的要求不同于聊天:格式稳定性、长上下文状态保持和错误恢复能力往往比单纯的知识广度更关键。
本地部署的意义与局限
“you can serve locally today”是这次发布强调的重点。本地部署意味着数据不出内网、推理成本可控、延迟可预期,对隐私敏感或需要深度定制的团队有吸引力。结合 MoE 的稀疏激活特性,Sage-A1.5 在本地硬件上的可行性比同参数量的稠密模型更高。
不过,35B 总参数仍意味着模型权重文件体积不小,加载时需要足够的显存或内存。MoE 架构在不同硬件上的实际吞吐表现,也取决于专家并行策略和批处理配置。vLLM 的支持解决了“能不能跑”的问题,“跑得多快、多省”还需要开发者结合自身硬件实测。
在本地运行 35B 级别 MoE 模型时,显存需求需分两部分看:权重存储约与总参数量成正比(以 FP16 计,35B 大致需要数十 GB 量级,量化后可显著压缩),而计算开销只与激活参数相关。因此常见做法是使用 AWQ、GPTQ 等训练后量化把权重压到 4bit 左右,再用单卡或双卡工作站承载。专家并行(expert parallelism) 指把不同专家分布到多张卡上,路由时跨卡通信,会引入额外延迟;批大小较小时 MoE 的算力利用率也可能偏低。这些因素共同决定了“能跑”与“跑得高效”之间的差距,实际吞吐需结合硬件与批处理配置实测。
开源模型竞争的新变量
上海 AI Lab 在开源模型上持续投入,Sage-A1.5 是其面向智能体场景的一次布局。35B MoE 加 3B 激活的组合,瞄准的是“能力够用、成本可控”的中间地带。Day-0 vLLM 支持则显示出发布流程的成熟度——模型团队与推理生态的协同正在变得更紧密。
对开发者而言,这意味着多了一个可本地部署的智能体基座选项;对开源模型格局而言,MoE 架构与推理框架的快速适配,正在把“发布即可用”变成新的默认期待。Sage-A1.5 能否在智能体任务上拿出有说服力的表现,将决定它能否从众多开源模型中脱颖而出。
相关推荐
WorkBuddy AI智能体实战:从大模型到Agent的落地差异
通过批量转PDF实战对比,解析WorkBuddy AI智能体与大模型产品的本质差异,涵盖授权执行、积分消耗、场景适配与落地认知,帮你判断Agent工具是否适合当前工作流。
GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景AI工程师分享GrokBot工作流:一个月合入约千个PR,智能体自动合并20个。核心方法论围绕验证技能、EVAL测试、Dune架构与硬性CI约束,揭示如何从本地信任走向云端代理自动化。
Bright Data评测:免费额度、AI智能体MCP服务器与定价
Bright Data 提供免费 5000 额度、开源 MCP 服务器及代理/抓取 API。了解其定价模式、AI 助手集成方式和合规注意事项。