上下文投毒:长上下文模型为何被干扰信息拖垮

论文提出"上下文投毒"概念,证明决定长上下文检索退化的是有效干扰项数量而非上下文长度。
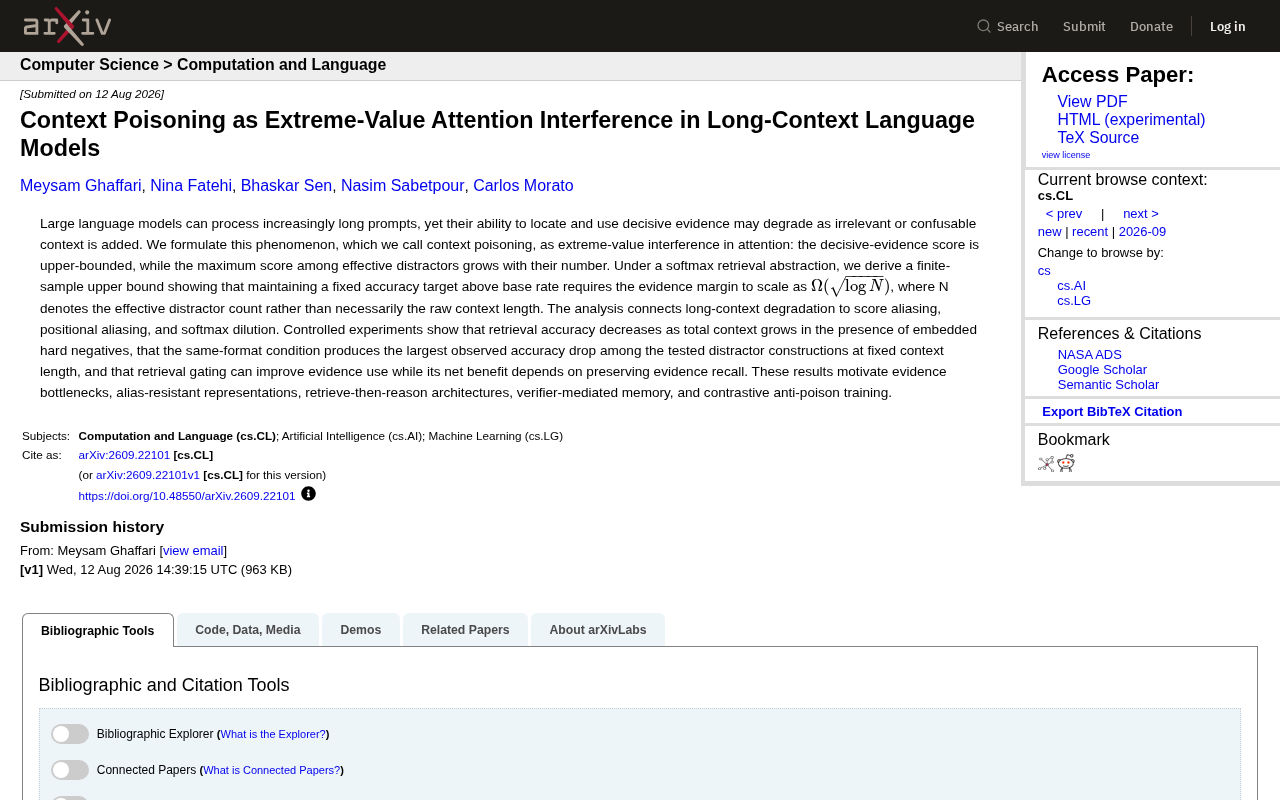
这篇 arXiv 论文将大语言模型长上下文性能退化现象形式化为注意力机制中的"极值干扰"问题,并命名为"上下文投毒"。核心理论结论是:维持固定检索准确率所需的证据注意力边际必须随有效干扰项数量 N 以 Ω(√logN) 的速度增长,真正的决定因素是格式相似、语义接近的有效干扰项数量,而非原始上下文长度。论文将退化归因于得分混叠、位置混叠和 softmax 稀释三种机制,并通过受控实验证实:同格式干扰项造成最大准确率下降,硬负例随上下文增长持续恶化检索。针对上述问题,论文提出了证据瓶颈、抗混叠表征、先检索后推理、验证器记忆和对比抗投毒训练等缓解方向,为 RAG 与长文档系统设计提供了理论依据。
长上下文能力的隐忧
大语言模型处理超长提示的能力正在快速提升,但一个容易被忽视的问题随之浮现:当输入中混入大量无关或易混淆的内容时,模型定位和使用关键证据的能力会明显退化。这篇发表于 arXiv 的论文把这一现象命名为上下文投毒(context poisoning),并从注意力机制的数学结构出发给出了系统性的解释。
与直觉不同,问题的根源并不完全在于上下文有多长,而在于其中"有效干扰项"的数量。换句话说,塞进去的字符越多不一定越糟,真正致命的是那些格式相似、语义接近、足以以假乱真的干扰内容。
把问题形式化为极值干扰
论文的核心贡献,是把上下文退化现象抽象成注意力中的**极值干扰(extreme-value interference)**问题。
关键证据 vs 干扰项的博弈
作者指出一个不对称的结构:关键证据的注意力得分存在一个上界,而所有有效干扰项中的最大得分会随着干扰项数量的增加而增长。这意味着,随着干扰项越来越多,总有某个干扰项的得分逼近甚至超过真正的证据得分——这正是模型"被带偏"的数学根源。
这里的「有效干扰项」(effective distractors)是论文中的核心概念,指那些在语义或格式上与真实证据足够接近、能够在注意力竞争中产生实质威胁的干扰内容,区别于随机噪声或明显无关的文本。注意力机制本质上是在所有 token 之间做 softmax 归一化的竞争:每个 token 的最终权重取决于它与查询的相似度得分相对于其他所有 token 的得分之比。当干扰项的得分分布与证据得分重叠时,softmax 输出就会被「平均化」,导致真正有用的证据无法获得足够高的注意力权重。极值统计理论告诉我们,从 N 个独立同分布的随机变量中取最大值,其期望大约以 $\sqrt{\log N}$ 的速度增长——这正是 $\Omega(\sqrt{\log N})$ 边际要求的直觉来源:证据得分必须跑赢干扰项中的「幸运儿」。
$\Omega(\sqrt{\log N})$ 的证据边际
在 softmax 检索的抽象框架下,作者推导出一个有限样本上界:若想在高于基准率的水平上维持固定的准确率目标,证据得分相对于干扰项的边际(margin)必须以 $\Omega(\sqrt{\log N})$ 的速度增长,其中 N 是有效干扰项的数量,而非原始上下文长度。
这个结论很关键——它把注意力从"上下文太长"的粗糙叙述,转向了"有效干扰项数量"这一更精确的度量。
三种失效机制
论文将长上下文退化与三种具体机制联系起来:
- 得分混叠(score aliasing):干扰项的注意力得分与真实证据难以区分;
- 位置混叠(positional aliasing):位置编码在长序列下的表征模糊;
- softmax 稀释(softmax dilution):注意力权重被大量候选项摊薄,真正重要的证据得不到足够权重。
这三种机制共同解释了为什么长上下文场景中模型会"看得到却用不上"关键信息。
位置混叠(positional aliasing)值得进一步说明。现代大模型普遍使用旋转位置编码(RoPE)或类似的相对位置编码方案,这些方案通过旋转变换将位置信息注入注意力得分计算中。然而,当序列极长时,相邻远距离位置的旋转角度差异趋于周期性重叠,不同位置的编码向量在高维空间中变得难以区分,模型对「这段证据在上下文中处于哪个位置」的感知能力随之下降。这也是「lost in the middle」现象的编码层面解释:模型对上下文首尾位置的感知相对清晰,中间位置的信息则容易被位置编码的模糊性进一步掩盖,与得分混叠和softmax稀释形成叠加效应。
实验验证了哪些结论
作者通过一系列受控实验对理论进行了检验,主要发现包括:
- 在嵌入了**硬负例(hard negatives)**的情况下,检索准确率随总上下文增长而下降;
- 在固定上下文长度下,**同格式(same-format)**的干扰项构造造成了所测试各种干扰方式中最大的准确率下降——也就是说,与目标证据格式一致的干扰最难被识别;
- **检索门控(retrieval gating)**能改善证据的使用效果,但其净收益取决于是否能保持证据召回率。
第二点尤其值得实践者警惕:干扰内容越"像"正确答案,模型越容易被误导,这对 RAG 系统中检索结果的排布提出了直接挑战。
「硬负例」(hard negatives)在信息检索领域特指那些与查询高度相关、但并非正确答案的候选项,是训练检索模型时常用的数据构造手段。在本论文的实验语境中,硬负例作为干扰项被插入上下文,模拟现实 RAG 系统中检索器返回相关但不准确文档的情形。这类干扰之所以危险,正是因为它们在表征空间中靠近正确证据,会触发前述的得分混叠现象。值得注意的是,「同格式干扰」与硬负例是两个维度:前者强调结构外观的相似(如相同的表格格式、问答格式),后者强调语义内容的接近——两者叠加时对模型的混淆效果最强。
对系统设计的启示
基于这些分析,论文提出了若干可能的缓解方向,为长上下文与检索增强系统的架构设计提供了思路:
- 证据瓶颈(evidence bottlenecks):主动收窄进入推理阶段的信息通道;
- 抗混叠表征(alias-resistant representations):让真实证据与干扰项在表征空间中更可分;
- 先检索后推理(retrieve-then-reason)架构:将检索与推理解耦;
- 验证器中介的记忆(verifier-mediated memory):引入验证机制过滤记忆内容;
- 对比式抗投毒训练(contrastive anti-poison training):通过对比学习提升模型对干扰的鲁棒性。
「先检索后推理」(retrieve-then-reason)架构与当前主流 RAG 管线的区别在于推理阶段的隔离程度。标准 RAG 通常将所有检索到的文档直接拼接进提示,让模型在同一次前向传播中同时完成「找到证据」和「基于证据推理」两个任务,这正是上下文投毒发生的场所。解耦架构的思路是先用轻量检索或重排序模块将候选集压缩到极小范围(证据瓶颈),再将精炼后的证据送入推理模块,从架构层面减少推理阶段面对的有效干扰项数量,而非依赖模型自身从大量混杂内容中甄别证据。这与「验证器中介记忆」方向相互补充:前者减少干扰进入推理的概率,后者在推理后对输出结果做二次核验。
为什么这项研究值得关注
随着模型上下文窗口不断扩大,业界往往默认"塞入更多上下文"就能提升表现。这篇论文提供了一个冷静的理论视角:真正决定检索质量的不是原始长度,而是有效干扰项的数量与相似度。对于构建 RAG、长文档问答和智能体记忆系统的工程团队来说,这意味着优化重点应从"能塞多长"转向"如何减少和抵御混淆性干扰"。
需要说明的是,本文的结论建立在 softmax 检索抽象和受控实验之上,实际大模型的行为可能更为复杂,但其提出的度量视角和缓解方向具有明确的工程指导价值。
相关推荐

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。

OpenSOP:用Git管理多语音Agent提示词的开源方案
OpenSOP 是一个开源工具,用 Git、YAML 和 Markdown 管理多个AI语音Agent的提示词,解决提示词重复、漂移和手动同步难题,支持改动影响预览和一键回滚。
AI代购时代来临:Shopify开放Agent结账,抢占万亿新市场
AI代购时代来临:Shopify开放Agent结账,抢占万亿新市场
Shopify开放AI代理结账功能,允许Agent读取、更新并提交订单。本文解析AI代购时代的平台分化、结构化数据的重要性与agent-assisted安全机制,并给出商家应对策略。