上下文优化的隐藏风险:被丢弃的证据谁来测试?
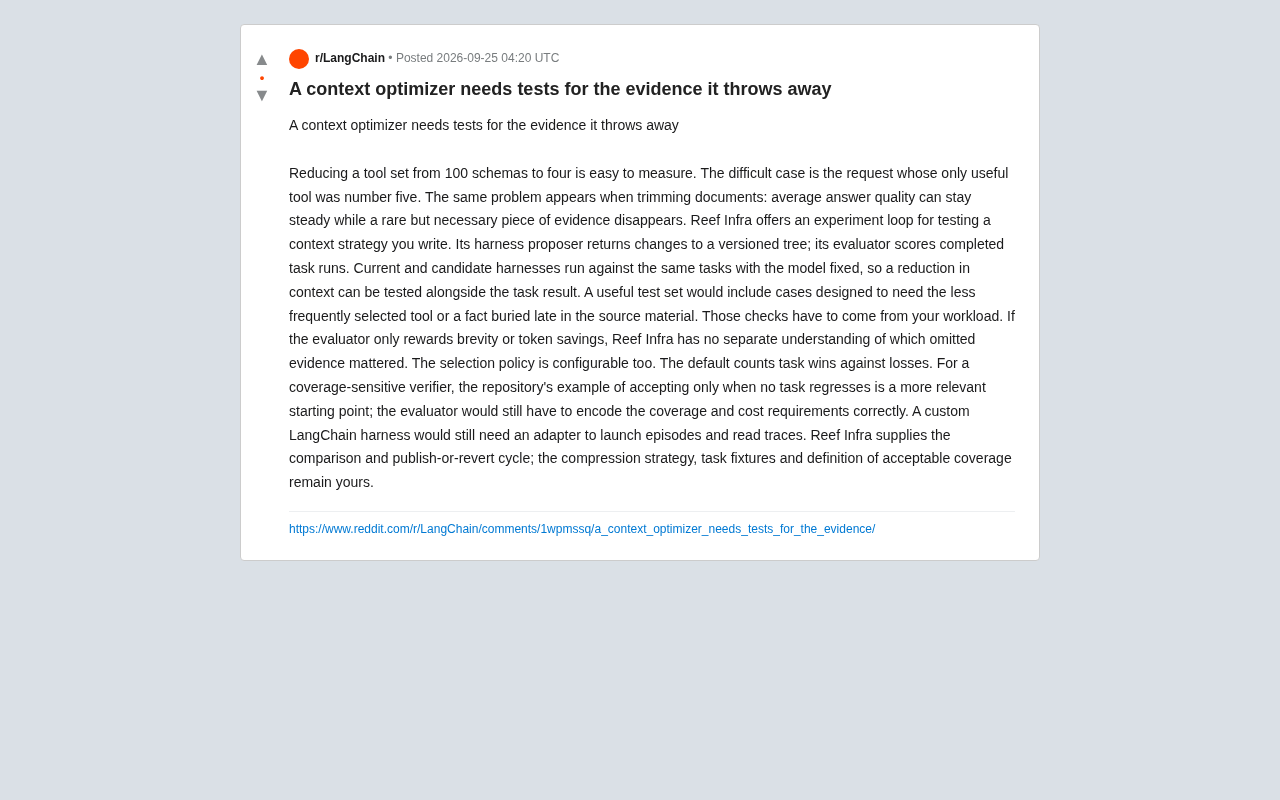
上下文裁剪的收益易量化,但丢失关键证据的隐性损失常被平均指标掩盖,需用覆盖率优先的实验闭环来弥补这一盲区。
在大模型应用工程化中,上下文压缩(裁剪工具集、过滤文档块)能显著降低 token 消耗,但其隐性风险常被忽视:平均准确率保持稳定,并不意味着低频但关键的场景没有受损。文章指出,一个只奖励简洁性的评估器天然对"被丢弃的证据是否重要"视而不见。Reef Infra 提出的实验循环通过固定模型、相同任务集的对照运行,将压缩程度与任务结果放在同一实验中比对,并提供发布/回滚机制。但工具本身并不能替代人工设计的测试集——那些覆盖低频工具和埋藏证据的长尾用例,必须来自团队自身的真实工作负载。覆盖率敏感的场景应采用"零退化才接受"的保守采纳策略,而非默认的胜负计数策略。文章最终强调:上下文优化器的成熟度,不体现在能砍多少内容,而体现在对被丢弃内容的检验有多严格。
在大模型应用工程化的过程中,上下文优化(context optimization)几乎是每个团队都会面对的课题。把一个包含 100 个工具 schema 的集合裁剪到 4 个,看起来是一次干净利落的性能优化。但真正棘手的情况是:那个请求所需要的唯一有效工具,恰好是被砍掉的第五个。
这篇来自 Reddit 的讨论,点出了上下文压缩里一个被普遍低估的盲区——我们能轻松衡量裁剪带来的收益,却很难衡量裁剪造成的隐性损失。
平均值掩盖了长尾的失败
工具集裁剪只是问题的一个侧面。同样的困境也出现在文档裁剪上:当你压缩输入内容时,平均答案质量可能保持稳定,但某一条罕见却必要的证据可能已经悄然消失。
这里的核心矛盾在于评估指标的选择。如果一个上下文策略的整体准确率没有明显下滑,团队往往就会认定优化是成功的。然而平均指标天然会稀释长尾场景的失败——那些低频但关键的请求,正是被平均值掩盖掉的受害者。
换句话说,减少 token、缩短上下文带来的确定性收益很容易量化,而丢失关键证据带来的偶发性损失却难以捕捉。一个只奖励简洁性或 token 节省的评估器,本质上对"哪些被省略的证据其实很重要"一无所知。
这一现象在统计学上有时被称为"辛普森悖论"的工程变体:聚合指标在子群体间的表现可能截然相反。对于 LLM 应用而言,长尾场景的特殊性在于其低频但高价值——一个法律合同分析系统中,99% 的查询可能只用到 5 个常规工具,但那 1% 涉及特殊条款解释的请求,可能恰恰需要被裁剪掉的第 6 个工具。在 RAG(检索增强生成)系统中,类似的问题体现为"幸存者偏差":留存下来的文档块在平均水平上质量良好,但被过滤掉的那些块里,可能藏着某条罕见查询的唯一正确答案。这也解释了为什么仅靠 BLEU、ROUGE 或整体准确率等聚合指标来评估上下文压缩策略是不充分的——这些指标的设计初衷是衡量"典型情况下的平均表现",而非"最坏情况下的覆盖保障"。
Reef Infra 提供的实验闭环
针对这个问题,讨论中提到的 Reef Infra 给出了一套实验循环(experiment loop)的思路,用于测试你自己编写的上下文策略。
它的工作机制大致分为几个部分:
- Harness proposer(方案提议器):针对一个带版本的策略树返回修改建议;
- Evaluator(评估器):对完成的任务运行结果进行打分;
- 对照运行:当前 harness 与候选 harness 在固定模型、相同任务集下并行运行。
这种设计的价值在于,它把"上下文的削减程度"和"任务结果"放在了同一次实验里进行对照测试。你不再是单独看压缩率,而是同时观察压缩后任务表现是否退化。这让优化决策从"感觉更省"变成了"有数据支撑的取舍"。
关键在于测试集怎么设计
但工具本身并不能替你解决根本问题。Reef Infra 提供的是比较机制和 publish-or-revert(发布或回滚)循环,而压缩策略、任务夹具(task fixtures)以及可接受覆盖率的定义,仍然完全掌握在你自己手里。
一个真正有用的测试集,必须包含那些专门设计来需要低频工具、或需要埋藏在原文靠后位置的事实的用例。这些检查项无法凭空生成,只能来自你自己的真实工作负载。如果你的测试集里根本没有覆盖这些长尾场景,那么再精巧的评估器也无从判断哪条被丢弃的证据是致命的。
任务夹具(task fixtures)是软件测试领域的概念,指为特定测试场景准备的固定输入数据和预期输出的组合。在 LLM 工程语境中,task fixtures 通常包含:一个具体的用户请求、运行该请求所需的工具集或文档语料、以及判断输出是否正确的 ground truth。构建高质量 task fixtures 的难点在于"已知未知"——团队容易为自己熟悉的场景写测试,却天然忽视那些尚未出问题的边缘场景。一种实践上可行的方法是从生产日志中挖掘:对历史请求做聚类分析,找出分布尾部的低频请求类型,再针对这些类型手工构造或半自动生成 fixtures。另一种方法是"失败驱动测试"(failure-driven testing):每当线上出现一次因上下文裁剪导致的错误答案,立刻将该用例提炼为一个永久性的回归测试用例,确保同类问题不再复现。
选择策略与覆盖率的博弈
Reef Infra 的选择策略(selection policy)是可配置的,这一点对覆盖率敏感的场景尤为重要。
默认策略统计任务的胜负比——只要候选方案赢的次数多于输的次数就采纳。这对追求整体质量的场景没问题,但对一个覆盖率敏感的验证器来说风险很大:它可能为了整体多赢几个案例,而牺牲掉那几个至关重要的长尾案例。
讨论中提到,仓库里有一个更保守的示例策略——只有在没有任何任务出现退化时才接受候选方案。对于覆盖率敏感的需求,这是一个更合适的起点。不过即便如此,评估器仍然需要正确地把覆盖率要求和成本要求编码进去,否则依然无法真正保护那些关键证据。
工程集成的现实成本
值得工程团队注意的是集成成本。如果你使用自定义的 LangChain harness,仍然需要一个适配器(adapter)来启动 episode 并读取 trace。Reef Infra 负责的是对照比较与发布/回滚的循环,而链路的接入、轨迹的读取这些工程细节,还是得自己动手打通。
这里涉及的"发布或回滚"(publish-or-revert)模式是持续交付(CI/CD)思想在 LLM 上下文策略管理中的具体应用。其核心思想是:每一次上下文策略的变更都被视为一次可测量的实验,而非一次不可逆的部署。候选策略在影子环境(shadow environment)中与当前生产策略并行运行,只有当候选策略在预设指标上通过门槛,才会被真正推送为新的生产版本;否则自动回滚,保留原策略。"零退化才接受"的保守策略在形式上类似于软件工程中的"零容忍回归"原则——任何已覆盖的测试用例不得因新变更而失败。这种策略在医疗、金融、法律等高风险领域尤为适用,因为这些场景中单次关键信息缺失的代价,远超通过更激进压缩换来的 token 节省收益。
对 AI 工程实践的启示
这场讨论虽然聚焦于一个具体工具,但它揭示的原则具有普适意义:上下文优化不应只被当作一个压缩问题,而应被当作一个带有明确覆盖率约束的取舍问题。
对于正在构建 RAG 系统、Agent 工具调用或长上下文应用的团队,有几点值得落到实处:
- 不要只用平均准确率评估压缩效果,要为长尾、低频、埋藏证据的场景单独构建测试用例;
- 评估器的奖励函数决定了它"看见"什么——如果只奖励简洁,它就会对隐性损失视而不见;
- 采纳策略要与业务的容错等级匹配,覆盖率敏感的系统应采用"零退化才接受"的保守策略;
- 工具能提供实验框架,但测试用例的设计始终是团队自己的责任。
归根结底,一个上下文优化器的成熟度,不体现在它能砍掉多少内容,而体现在它对"被丢弃的东西"有多严格的检验。
相关推荐
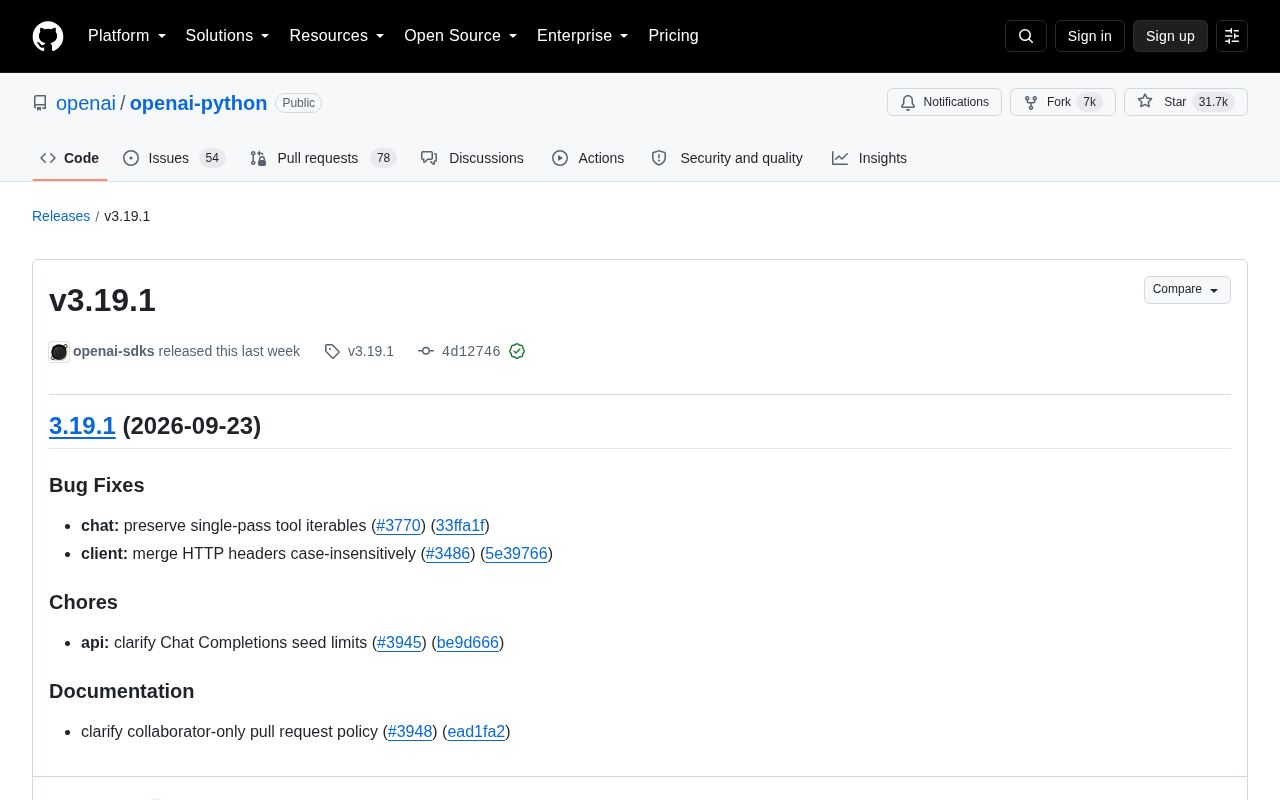
OpenAI Python SDK v3.19.1 发布:修复工具迭代与请求头问题
OpenAI Python SDK v3.19.1 发布,修复了单次调用工具迭代对象丢失、HTTP 请求头大小写合并等问题,并澄清了 Chat Completions 的 seed 参数限制。面向开发者的低风险维护性升级指南。
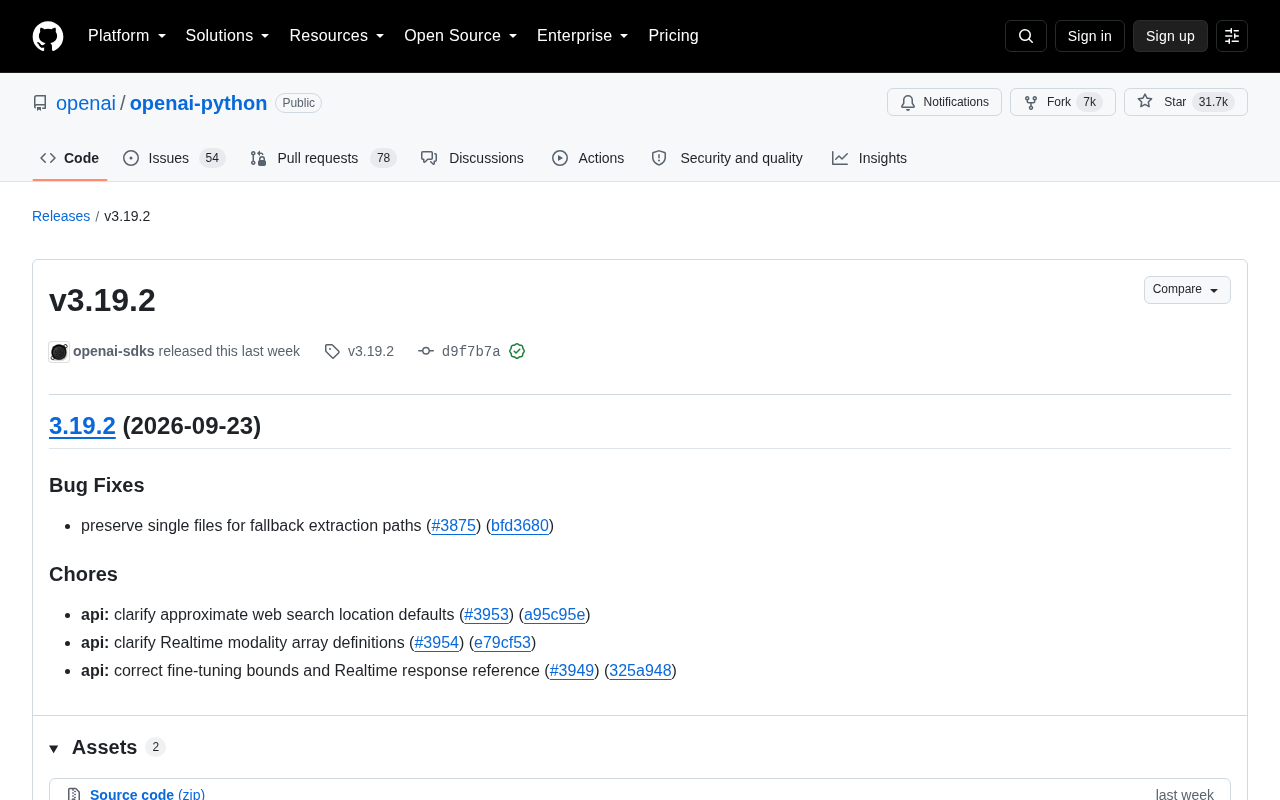
OpenAI Python SDK v3.19.2 发布:修复文件回退与API文档澄清
OpenAI 官方 Python SDK 发布 v3.19.2 版本,修复文件回退提取路径问题,并澄清 web search 位置默认值、Realtime 模态定义及 Fine-tuning 边界等多项 API 文档。本文解析更新要点与升级建议。
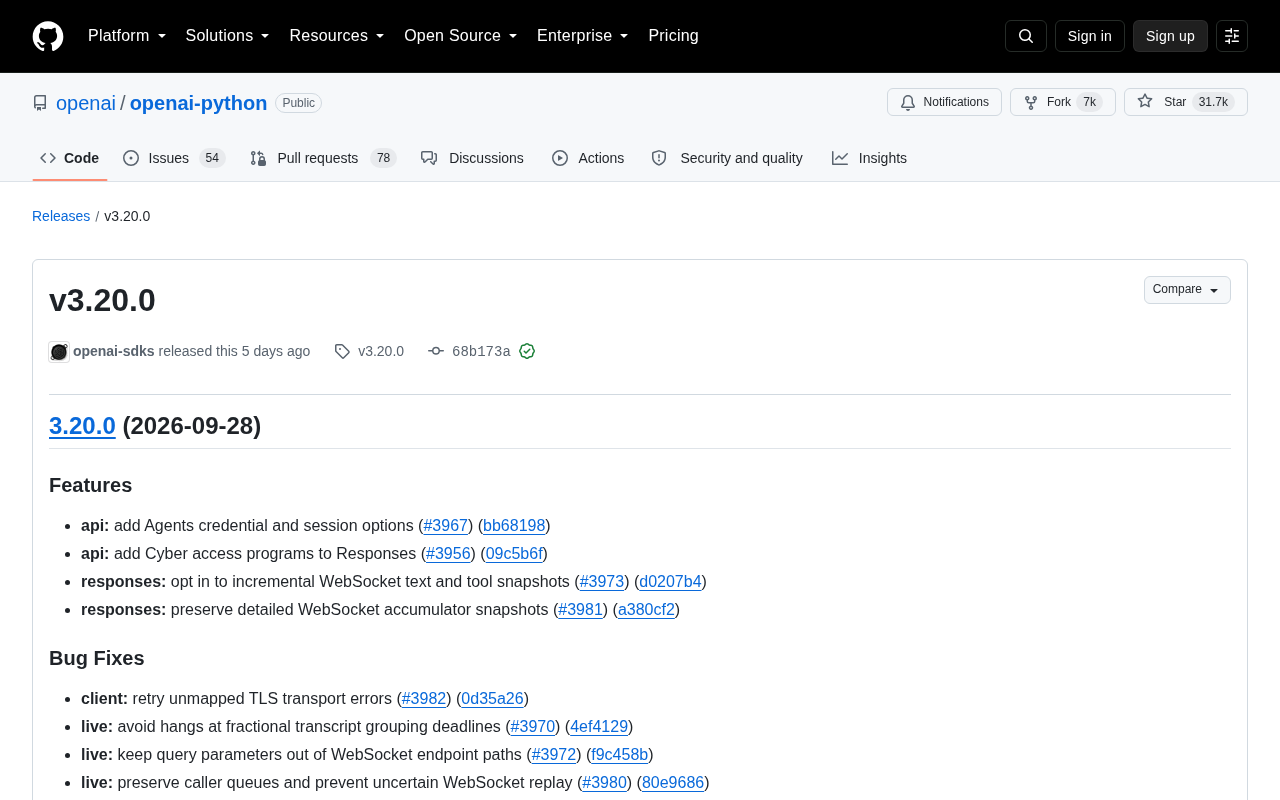
OpenAI Python SDK v3.20.0发布:Agents凭证与WebSocket增强
OpenAI 官方 Python SDK v3.20.0 正式发布,新增 Agents 凭证与会话选项、Responses WebSocket 增量快照,并集中修复实时连接稳定性问题,同时完善 API 错误响应文档。