上下文越大AI智能体越不可靠?4种失效模式与修复方法
上下文窗口越大智能体越不可靠,四种失效模式需靠主动丢弃来修复。
文章介绍了一项覆盖18个前沿模型的研究结论:上下文窗口越大,模型利用其中信息的可靠性反而越低,研究者称之为"上下文腐化"。文章剖析了窗口的填充结构——工具结果与运行日志占据大头,任务描述占比极小,导致关键信息被稀释;并从注意力总量有限的角度解释了机制根源。在此基础上归纳出四种失效模式:污染(错误结论被当成事实)、分心(历史模式压过当前任务)、混乱(工具过多难以选择)、冲突(新旧矛盾信息并存)。对应给出验证、压缩、筛选、清理四种修复方法,共同点是主动丢弃部分上下文。文章最后指出,上下文工程的核心不是塞入更多,而是在正确时机移除无关或过时信息。
上下文越大AI智能体越不可靠?4种失效模式与修复方法
过去一年,AI智能体的上下文窗口从几千token膨胀到几十万甚至上百万token。直觉上,这意味着智能体可以记住更多指令、更多工具返回结果、更多项目文档,长期任务应该完成得更稳。但一项覆盖18个前沿模型的研究给出了相反的结论:随着上下文窗口变大,所有模型的可靠性都在下降。研究者把这种现象称为「上下文腐化」——窗口里的token越多,模型越难可靠地利用其中任何一种。
这引出一个反直觉的命题:智能体怎么会因为「记得更少」而变得更好?答案藏在上下文工程(context engineering)里——在智能体运行的每一步,主动决定哪些内容应该进入上下文,哪些应该被丢掉。
上下文窗口里到底装了什么
要理解失效,先得看清填充物。以一个「把老旧代码库迁移到新数据库驱动」的智能体为例:
- 系统提示词:放在窗口最前面,定义它总体上应该如何工作的长期指令;
- 任务描述:可能只有几行字,告诉它迁移目标;
- 项目说明:智能体框架自动读入的 agents.md 之类的文件,说明项目如何构建;
- 工具定义:每一种可调用工具的名称与说明;
- 运行日志:智能体每一步做了什么,其中工具结果占大头——读到的文件内容、测试输出、错误日志、数据库结构。
一个运行了一小时的智能体,消息历史可能已经相当庞大。而任务描述本身只占极小一部分,其余几乎都是执行过程中一点点堆积出来的。这正是问题的结构性根源:窗口在不断膨胀,但其中真正与「下一步该做什么」相关的内容比例在持续稀释。
更关键的是模型的注意力机制。模型处理上下文不像数据库查询那样能精确定位某一行只读那一条,窗口里每个token都在竞争有限的注意力。正如原视频所指出的:窗口也许能装下一百万个token,但注意力总量有限,只能分摊到这些token上。
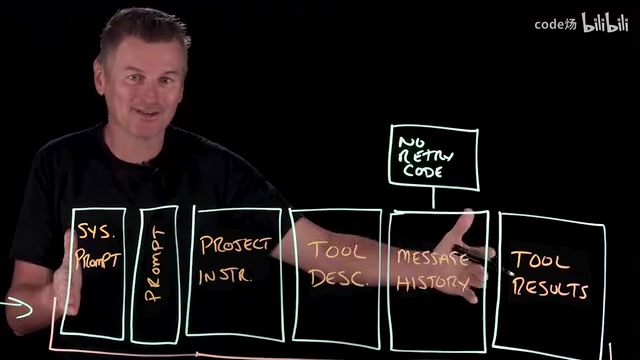
上下文窗口(context window) 指模型单次推理时能够读取的token总量上限,它决定了系统提示词、对话历史、工具返回结果等所有输入的总容量。需要注意的是,窗口大小与模型能有效利用的信息量并不等价:窗口是"能装多少"的物理容量,而注意力是"能关注多少"的计算资源。当窗口内token数量增长时,注意力权重需要在这些token之间分配,单个token获得的平均关注度随之下降。这就是为什么扩大窗口并不能线性提升智能体的任务能力——容量扩张了,但有效注意力被摊薄了。理解这一区分,是理解"上下文腐化"现象的前提。
四种失效模式:污染、分心、混乱、冲突
上下文污染:错误结论被当成事实
回到迁移案例。智能体粗略看了驱动文档,读错了,写下一条笔记:「新驱动会自动重试失败的连接,所以旧的重试代码可以删掉。」这条结论完全错误,但它进入了上下文,并被模型当作可靠依据——对模型来说,自己的笔记看起来和事实没有区别。于是智能体开始逐个文件删除本来完全正确的重试代码。错误一旦进入上下文,就会像污染源一样扩散到后续所有决策。
注意力机制(attention mechanism) 是Transformer架构的核心组件,它让模型在处理每个token时,根据相关性对上下文中其他所有token分配权重。这种机制是全局的、软性的:模型无法像数据库那样精确"只读某一行",而是对窗口内所有内容做加权求和。因此,当上下文中混入错误或过时的信息时,它们并不会被自动屏蔽,反而会以一定权重参与后续所有token的计算。token数量越多,注意力被稀释得越严重,关键指令和事实获得的相对权重就越低。这从机制层面解释了为什么"塞得越多"不等于"用得越好",也为后文"主动丢弃"的修复策略提供了理论依据。
上下文分心:历史压过当前任务
语言模型本质上是延续已有模式的机器。如果窗口里积累了一小时的过往操作,这段历史会成为非常强烈的模式,甚至盖过模型在训练中学到的推理能力。它可能不再问「这项任务下一步真正需要做什么」,而是被自己的消息历史牵着走,反复做已经做过的事,在旧路上打转。
上下文混乱:工具太多,选不对
智能体往往连接了多个系统——版本控制、数据库控制台、工单系统。无论这些工具是否真的会用到,它们的定义都得塞进上下文。工具种类越多,从中选出最适合当前任务的那一个就越困难。原视频引用了一项基准测试:模型被提供46种工具时没能完成任务,同一个任务工具缩减到19种后反而通过了。
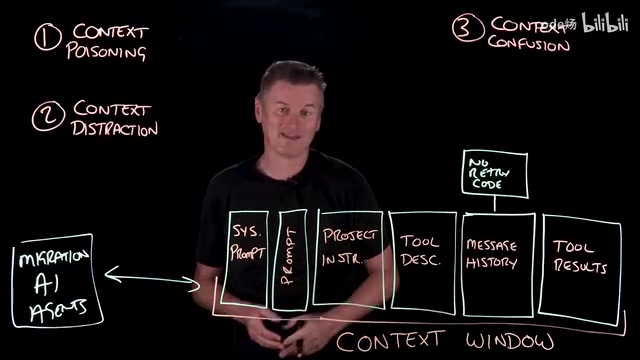
上下文冲突:两个版本同时存在
智能体迟早会发现重试并没有发生,意识到笔记错了,也可能把正确情况写进消息历史。问题是,现在上下文里同时保留着两个互相冲突的版本,模型需要在矛盾信息中自行判断,可靠性随之下降。
四种修复方法:主动丢掉一些信息
针对四种失效,原视频给出了对应的修复路径,共同点是主动删除。
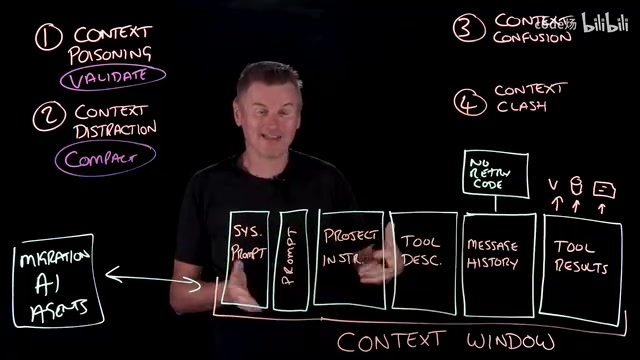
验证:结论进上下文前先核实
针对污染,办法是在结论写进上下文之前先拿真实信息做一次简单验证。比如跑一次连接测试,智能体就不会写下那条「新驱动无需重试代码」的错误笔记。验证的成本远低于被污染后逐个文件回滚的成本。
压缩:摘要替代完整日志
针对分心,关键是压缩。历史变得特别长时,先把它总结成摘要,再丢掉完整日志。但压缩是有损的:摘要里的一些细节会消失,如果对摘要再做摘要,信息会像复印件一代代复印那样逐渐偏移。因此更稳妥的做法是把能移除上下文的内容放进长期文件保存,详细资料留在文件里,只有任务真正需要时才重新读入。
长期文件(long-term file) 在这里指智能体框架维护的、位于上下文窗口之外的持久化存储,例如项目中的笔记文件、进度文档或结构化状态记录。与窗口内的消息历史不同,长期文件不受token上限约束,也不会持续占用注意力资源。智能体可以在需要时通过工具调用读取其中某个片段,用完即可不再保留在上下文中。这种"外置记忆"模式把"存储"与"当前工作集"分离:详细日志留在文件里作为可检索的档案,窗口内只保留当前决策真正需要的少量信息。它是压缩策略的补充——摘要负责压缩窗口内历史,长期文件负责把不宜压缩的细节移出窗口。
筛选:只给当下真正需要的工具
针对混乱,这是信息整理问题。数据库迁移任务不需要46种工具,只提供眼下真正需要的几种即可;需要时智能体还可以再去动态获取其他工具。工具集按任务阶段裁剪,比一次性全量挂载更可靠。
清理:旧版本不与新结论并存
针对冲突,信息被新结论取代后就删掉旧版本,别让两者并存。也可以进一步开启一个全新的窗口,只写明当前正确状态,把之前错误的、过时的信息留在外面。
为什么「记得更少」反而更可靠
把这四种修复放在一起看,逻辑是一致的:
| 失效模式 | 表现 | 修复 |
|---|---|---|
| 污染 | 错误结论被当成事实 | 验证 |
| 分心 | 历史压过当前任务 | 压缩 |
| 混乱 | 工具多过任务所需 | 筛选 |
| 冲突 | 上下文互相矛盾 | 清理 |
四项修复的共同动作都是丢弃。这挑战了「信息越多越好」的默认假设:在注意力总量有限的前提下,无关或过时的token不是资产而是负债,它们稀释了模型对关键信息的注意力分配。上下文工程的核心,不是往窗口里塞更多东西,而是持续判断什么东西此刻不该在窗口里。
对开发者而言,这意味着智能体框架的设计重点会从「如何读入更多上下文」转向「如何在正确的时机移除上下文」。工具调用的动态加载、历史摘要的分层策略、结论写入前的验证步骤,都会成为智能体可靠性的关键工程点。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。