烧3亿Token实测DeepSeek搜索API:与Claude搜索五轮对决

B站UP主自费3亿Token实测DeepSeek与Claude搜索API,五轮对决揭示各自优劣。
本文介绍了一场由B站UP主发起的开源评测,对比DeepSeek搜索API与Claude自带搜索的性能。测试采用闭卷/开卷五轮制,覆盖中英日韩泰等多语种,从准确率、速度、成本、诚实度等维度展开。结果显示:DeepSeek搜索在小语种场景优势明显,单价仅为Claude的十三分之一,但返回资料量大导致处理成本更高;Claude搜索在诚实度上更优,幻觉更少。最终,DeepSeek搜索在四轮搜索比拼中赢三轮平一轮,而Claude模型在附加赛和诚实度上全赢。评测提供了可复现的框架,强调综合权衡搜索质量、成本与诚实度的重要性。
AI回答准不准,一半看模型本身,一半看它背后调用的搜索能力。模型是答题的脑子,搜索则是替它翻资料的助手。当DeepSeek开始单独售卖自家搜索API,且定价仅为1000次5元时,一个关键问题浮出水面:它真的比Claude自带的搜索更好用吗?
B站UP主「懒得理你」自费消耗3亿Token,做了一场全网首个将DeepSeek广告搜索与Claude搜索放在一起对比的开源评测。测试不仅覆盖中英文,还延伸至日语、韩语、泰语等小语种,从准确率、速度、成本到诚实度五个维度展开五轮对决。本文将结合实测数据与截图,拆解这场搜索API之争的真实结果。
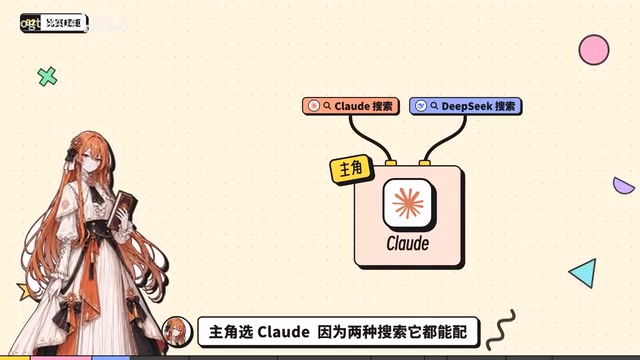
测试设计:公平比卷与开卷规则
为了公平对比,评测设定了一套类似考试的规则:每个模型先闭卷答题一遍(不允许搜索),再开卷答题一遍(允许搜索)。开卷时最多搜索五次,只能查看搜索返回的结果和摘要,不能点进原网页,以此纯粹比拼搜索本身递回的信息质量。算分规则为:答对加5分,答错硬交扣3分,不答不扣分,从第二次搜索起每搜一次扣1分。
主角选择Claude,因为它是当时最强档位的模型,且能同时配置两种搜索——Claude的搜索不对外提供,而DeepSeek的搜索可以外带给任何模型使用。测试派出Claude Sonnet和Opus,对比DeepSeek的Flash和Pro两档,共十组考题一百道题,中英文各半,大部分来自谷歌和阿里淘天公开题库,其余为自拟冷知识和近期新闻。判卷采用盲判,由Claude、DeepSeek各出一位裁判,再请OpenAI的GPT一位,三票两胜,连考试程序也是GPT写的。
开卷/闭卷测试:借鉴教育评估中的开卷与闭卷考试形式,闭卷指模型仅凭内部知识作答,开卷则允许模型调用搜索工具获取外部信息。这种设计能分离模型固有知识与其利用外部信息的能力。盲判:指裁判在不知道答案由哪个模型生成的情况下进行评分,以避免偏见,类似于学术评审中的双盲实验。三票两胜:采用多数投票机制,由三个独立裁判(Claude、DeepSeek、GPT)分别评判,取多数结果作为最终判定,提高评分的客观性。
第一轮:准确率——开卷后差距悬殊
剔除八道答案模糊的题后,按92道计算。闭卷时,四个模型答对60到73道,最近一个月的新闻题全军覆没得0分。一开卷,所有模型答对87道以上。最便宜的Flash开卷后,比最贵的Opus闭卷还多对18道。
同一个Sonnet,用自家搜索有五道没答对,换上DeepSeek搜索后全部答对。其中一道题问「给小桃的信的导演是谁」,Claude的搜索翻回来的是情书相关内容,没答出来;DeepSeek搜索一次就找到了导演冲浦启之。不过两边只差这五道,还不能排除运气。高档的Opus更干脆,两种搜索都是全对。但Claude的搜索平均要多搜几次,一算分,DeepSeek小胜。
为什么Claude要多搜?因为Claude的搜索会先交给自家一个小模型读一遍,只递回两千来字的摘要;DeepSeek直接递回十条结果,一万多字。资料少,自然要多搜几次。只是第一轮题太简单,开卷几乎全对,分差未能拉开。
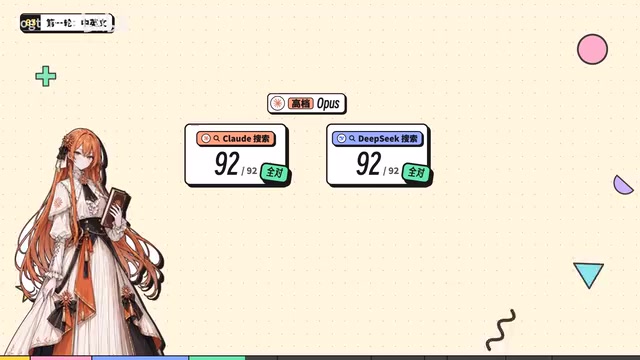
搜索API的返回机制差异:Claude的搜索会先由内部小模型对搜索结果进行摘要,仅返回约2000字的浓缩信息;而DeepSeek搜索直接返回十条原始结果,总计约一万多字。这种差异导致Claude搜索需要更多次调用才能获取足够信息,但摘要可能丢失细节;DeepSeek搜索单次信息量大,但可能包含冗余内容。Token消耗:在AI模型中,Token是文本处理的基本单位,搜索返回的字数直接影响Token消耗,进而影响处理成本和速度。
第二轮:小语种——DeepSeek搜索优势明显
第二轮换上难度更高的多语种题库,来自当年七月公开的多语种数据集,照当地资料出题而非从英文翻译,覆盖日语、韩语、泰语、印尼语、俄语、西班牙语,每种二十道。试跑时DeepSeek账户曾因余额不足报错一次,可见消耗之大,正式开考前只好请GPT来当裁判。剔除二十五道模糊题后按95道计算。
结果难度陡增:开卷时四个模型只答对36到56道。给Claude开卷,Sonnet用自家搜索答对73道,换上DeepSeek搜索后飙到85道;Opus从83道涨到90道。差距最大的是日语:用DeepSeek搜索的四个考生二十道全对,用Claude搜索的只对了十五、十六道。Sonnet的分数几乎翻了一倍。
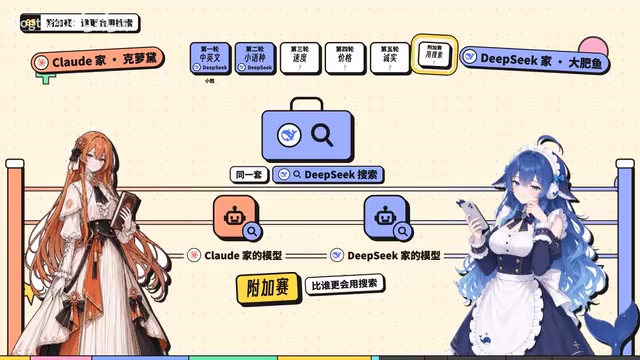
第三轮:速度与成本——各有胜负
同一套DeepSeek搜索交给两家的模型,又是另一场比赛。高档对高档、小语种场景,Claude的Opus答对90道,DeepSeek自家Pro答对83道;中档Flash还多对三道。但Flash平均搜两次半,Sonnet只搜一次半,算分后Sonnet赢。四场算分全是Claude的模型赢,其中DeepSeek搜索赢的那一场只有一位裁判,UP主随后又用多个Agent复核了两轮。
速度上,同一个Sonnet用Claude自家搜索每道题要二三十秒,换上DeepSeek搜索只要十秒出头,原因是Claude搜索多了小模型写摘要的步骤。这一轮DeepSeek赢。
成本上,按标价,同样搜一次Claude搜索的价钱是DeepSeek的十三倍。但Sonnet换上DeepSeek搜索后,一道题反而贵了两成多——因为开发者用Claude是按读进去的字数付费,DeepSeek递来的资料多了好几倍,搜索省下的钱全花在读资料上。换成Opus,贵了一半还多。更便宜的组合是DeepSeek模型配DeepSeek搜索:Sonnet一道题五毛多,Flash只要四分钱。这一轮打平——DeepSeek搜索单价便宜但处理贵,Claude搜索单价贵但处理便宜。
第四轮:诚实度——Claude更少幻觉
最后一轮比诚实:不会的题是直说不知道,还是硬编一个?开头那道「给小桃的信」的导演题,Claude搜索没找到就直说没查到,没用别的片子充数。闭卷时评测方交代过不知道就说不知道,但答错也分几种:直说不知道、答了一半猜了一个又说不一定对、以及斩钉截铁答错——最后这种就是常说的幻觉。
两轮加起来,斩钉截铁答错的次数:Opus一道、Sonnet四道、Flash十八道、Pro二十六道。这一轮Claude赢。
幻觉(Hallucination):指AI模型生成看似合理但实际错误或虚构的信息,是评估模型可靠性的关键指标。在搜索增强的场景下,模型可能因搜索结果的误导或自身知识缺陷而产生幻觉。诚实度评估:通过区分模型在不确定时的回应类型(直接承认不知道、猜测但声明不确定、斩钉截铁答错)来量化模型的诚实性,斩钉截铁答错即典型幻觉,对用户体验危害最大。
五轮总结与不可测的边界
五轮比完:比搜索的四轮,DeepSeek以几分钱优势赢三轮、平一轮;比模型的附加赛和诚实度,Claude全赢。两轮的最高分都由Claude的Opus搭配DeepSeek搜索取得。
UP主也澄清了测不出来的部分:小语种题有些出处其实是中英文网页,说明不了DeepSeek小语种网页收得更全;两家的模型和搜索都在更新,这只是十月的一次结果,每道题也只考了一次;不许点开网页其实对Claude搜索不利,平时它会自己点开网页读原文;论价位Flash更接近Claude的Haiku,但Haiku已经在Claude搜索里帮忙写摘要,这次没让它单独考。
全部题目、考试程序和原始记录均已开源,链接在视频置顶评论。这场评测的价值不在于给两家搜索下定论,而在于提供了一套可复现的评测框架——在AI搜索API逐渐成为基础设施的当下,开发者需要的不只是单价,更是搜索质量、处理成本与诚实度的综合权衡。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。