深入理解大模型推理:为什么生成如此之慢,又该如何加速
系统梳理大模型推理为何内存受限,以及从架构到系统层的完整加速优化方法。
本文基于斯坦福大模型课程第10讲,深入解析大语言模型推理的性能瓶颈与优化全景。推理因顺序生成的特性导致算术强度接近1,天然内存受限,KV缓存进一步加剧了这一问题。优化路径从架构层面展开:GQA、MLA、局部注意力削减缓存大小;SSM和扩散模型则从根本上绕开Transformer的自回归约束,实现并行或常数级内存推理。量化、剪枝、投机解码是通用加速手段,其中投机解码通过拒绝采样机制在不损失精度的前提下实现约2倍加速。系统层的连续批处理和PageAttention则解决了真实服务场景中的动态调度与内存碎片问题。文章最终指出,真正的性能突破源于架构层面的根本变革,而非单纯的系统调优。
推理(Inference)是大语言模型落地应用中最容易被学术界忽视、却对工业界至关重要的环节。斯坦福大学这门课程的第10讲专门讨论了推理的工作负载特征以及一系列加速手段。本文基于该讲座内容,梳理推理为何是内存受限(memory-limited)的,以及从架构、量化、剪枝到投机采样的完整优化图谱。
推理无处不在,成本正在超越训练
推理的定义很简单:给定一个训练好的固定模型,根据提示词生成响应。但它出现的场景远比想象中广泛——聊天对话、Cursor 这类代码补全、批量数据处理、模型评估、测试时计算(test-time compute),乃至强化学习训练本身都需要采样响应。换言之,推理是语言模型几乎所有基础功能的底层支撑。
讲师引用了几个直观的数字说明推理规模之大:OpenAI 每天生成约 1000 亿个词,Cursor 每天被接受的代码据称达到 10 亿行。训练是一次性成本,而推理会被反复执行,因此推理成本相对训练正在持续上升。这也解释了为什么真正部署模型的团队会投入大量工程精力优化推理,而这恰恰是只做训练、跑分、发论文的学术研究者容易忽略的部分。
衡量推理质量有三个关键指标:首个 token 时间(TTFT)、延迟(latency,token 到达速度)以及吞吐量(throughput,整体 token 生成量)。交互式应用关注前两者,批处理应用则更看重吞吐量。需要注意的是,高吞吐量并不意味着低延迟——某些请求可能耗时很久,但整体吞吐仍然很高。
为什么生成是内存受限的
训练与推理的根本区别在于并行性。监督训练时你能看到全部 token,可以在序列维度上完全并行,这正是 Transformer 大量利用的特性。但推理的核心特征是必须顺序生成:每个 token 的生成都依赖于之前所有的 token,无法并行。这使得推理很难充分利用可用算力,并成为内存受限的瓶颈。
讲师用算术强度(arithmetic intensity)这一概念解释了背后的数学。以矩阵乘法 X×W 为例,X 是 B×D,W 是 D×F。计算 FLOPs 与内存读写字节数的比值,在 batch size B 远小于 D 和 F 的假设下,算术强度约等于 B。对于 H100,其加速器强度约为 295——当 B 大于这个值时是计算受限(能用满 GPU),小于则是内存受限(效率低下)。
极端情况下,当 B=1(相当于矩阵向量乘积)时,算术强度约为 1,这非常糟糕。因为你读取整个 D×F 矩阵却只做了几乎等量的 FLOPs,内存读取又非常慢。而这正是逐 token 生成时发生的情况——算术强度接近 1,导致生成天然内存受限。
算术强度(arithmetic intensity)是衡量计算与内存访问比例的指标,单位是 FLOPs/Byte。GPU 硬件存在一个"屋顶线"临界值:当算术强度高于该值时,瓶颈是计算单元(compute-bound),GPU 的矩阵运算核心被充分利用;低于该值时,瓶颈是内存带宽(memory-bound),大量时间浪费在等待数据从显存传输到计算单元。H100 的峰值算术强度约为 295 FLOPs/Byte,意味着每从显存读取 1 字节,需要配套 295 次浮点运算才能让 GPU "不闲着"。批量训练时,巨大的矩阵乘法很容易超过这个门槛;但推理时 batch size 往往很小甚至为 1,导致整个推理过程绝大多数时间都在等待内存,而非真正在做计算,GPU 的峰值算力被严重浪费。
KV 缓存:解药与新瓶颈
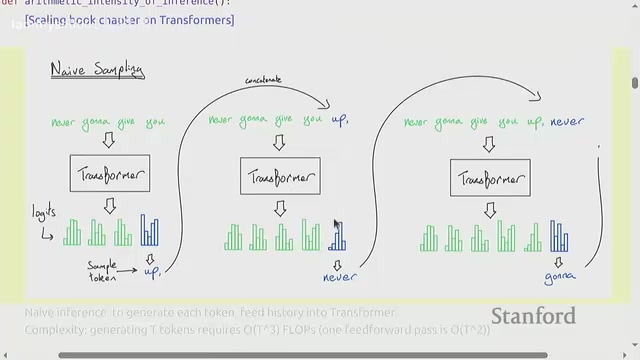
最朴素的生成方式是每生成一个 token 就把整个序列重新喂进 Transformer,复杂度是 T 平方级别,且存在大量冗余计算。对于自回归因果 Transformer,前缀的编码结果其实可以复用,解决方案就是 KV 缓存(KV cache)。
推理由此分为两个阶段:**预填充(prefill)**将提示词并行编码并计算出 KV 缓存,这一步可并行、速度快、计算受限,"日子很好过";**生成(generation)**则逐个 token 顺序产出,正是效率问题的根源。
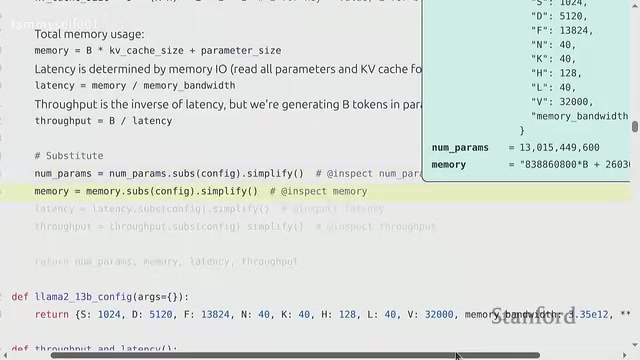
通过对 MLP 层和注意力层分别计算,讲师得出了关键结论。MLP 层的算术强度是 B×T,生成时 T=1,所以需要足够大的 batch size(即并发请求数)才能提升效率。而注意力层的算术强度是 S×T/(S+T),生成时约等于 1,且完全不依赖 batch size。原因在于:MLP 层中每个序列都命中相同的权重,可以批处理复用;而注意力层中每个序列都有自己独有的 KV 缓存,就像"每个序列都是独一无二的雪花",批处理无法带来节省。
延迟与吞吐的权衡
以 Llama 2 13B 在 H100 上为例进行"餐巾纸估算":batch size 为 1 时,延迟约 8 毫秒每 token,吞吐约 124 tokens/秒;batch size 增大到 16、64 时,延迟上升但吞吐显著提高;到 256 时吞吐增长开始出现边际递减,而且需要约 240GB 内存,单张 H100 根本放不下。
这揭示了核心权衡:小 batch 带来更好的延迟,大 batch 带来更好的吞吐,但 batch size 的上限受制于内存。相比训练时复杂的并行策略,推理有一种极其简单的并行方式——直接启动 m 份模型副本,无需通信,延迟不变,吞吐提升 m 倍。当模型大到单卡放不下时,才需要对模型和 KV 缓存进行分片。
削减 KV 缓存的架构技巧
既然推理是内存受限、瓶颈在 KV 缓存,那么减小缓存就是加速的关键,前提是不能过度损害精度。讲座系统梳理了多种从架构层面缩减 KV 缓存的方法:
分组查询注意力(GQA):介于多头注意力和多查询注意力之间,减少键值头的数量,多个查询头共享一组键值。实验显示在 Llama 2 13B 上采用 1:5 的比例后,内存下降、吞吐大幅提升,精度基本不变。Llama 3 正是因推理成本考量普遍采用了 GQA。
多头潜在注意力(MLA):来自 DeepSeek广告 V2,不改变键值数量,而是将其投影到低维空间,从 16000 维激进压缩到 512 维。唯一的问题是与 RoPE 不兼容,需额外增加少量维度。
跨层注意力(CLA):GQA 在头之间共享,CLA 则在层之间共享同一个键值投影,改善了精度与缓存大小的帕累托前沿。
局部注意力(Local Attention):只关注过去 K 个 token,使 KV 缓存大小保持常数而非随序列增长。但纯局部注意力会损害长程依赖建模能力,因此通常与全局注意力交错使用——Character AI 采用每 6 层配 1 层全局注意力的混合方案,并叠加缓存共享。
走出 Transformer:状态空间模型与扩散模型
更激进的思路是跳出 Transformer 框架本身。**状态空间模型(SSM)**源自信号处理和控制论,最初为解决长上下文的平方级开销,早期的 S4 兼具 RNN 和卷积的解释。但它在语言建模上表现不佳,症结在于"关联召回"(associative recall)任务——需要精确定位某个键值对并取出答案。Hyena、H3、Mamba 等工作逐步改进,Mamba 已被 AI21 扩展到 52B 的 MoE,不过仍需每 8 层保留一个 Transformer 层。
线性注意力近期迎来复兴,通过对注意力核做泰勒展开,将计算改写为非线性映射的点积,使其像 RNN 一样在序列长度上线性而非平方。Minimax 已用该思路训练出 456B 参数的 MoE,虽仍需偶尔使用全注意力,但大部分层已被更高效的线性或局部注意力替代。
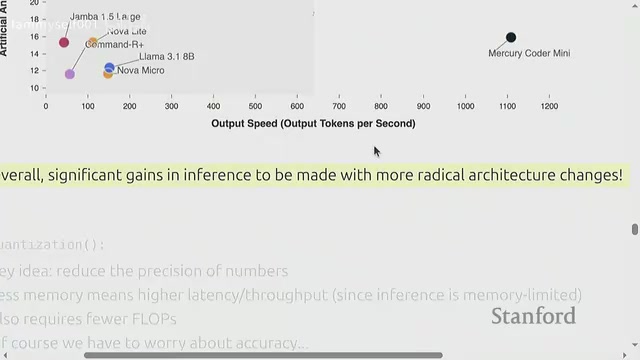
扩散模型则彻底摆脱自回归约束,并行生成所有 token 并反复迭代精炼。Inception Labs 的模型在代码任务上的 tokens/秒远超任何 Transformer 甚至 Jamba 这类混合架构。讲师认为,即便扩散模型存在精度损失,凭借速度上的巨大领先,也有足够空间通过增加计算来弥补。
状态空间模型(SSM)的核心思想来自经典的线性动力系统:用一个隐状态向量 h 来压缩整个历史信息,每步只需根据当前输入更新 h,再由 h 映射到输出。这使得推理时内存占用和计算量均为 O(1)(只存当前状态,不需要 KV 缓存),而 Transformer 的 KV 缓存随序列长度线性增长。训练时 SSM 又可以等价改写为卷积形式,从而并行处理整条序列,兼顾效率。Mamba 的关键改进是引入"选择性"机制(Selective State Space),让状态转移矩阵依赖输入内容动态调整,从而突破早期 SSM 对内容检索能力不足的局限。其代价是在需要精确的多跳推理或超长距离信息检索时,仍不及全注意力机制,这也是为何现有混合架构保留少量 Transformer 层的原因。
量化、剪枝与投机解码
除了改架构,还有几类通用手段。量化降低数字精度,FP32 用于训练,BF16 是推理默认,进一步可到 FP8、INT8 乃至 INT4。难点在于大网络中的离群值(outlier)会破坏低精度表现,LLM.int8 的做法是将大离群值单独用 16 位处理、其余用 INT8;激活感知量化(AWQ)则根据激活值判断哪些权重值得保留精度。
模型剪枝先用小规模校准集识别重要的层、头或隐藏维度,移除不重要部分,再通过蒸馏从原模型修复剪枝后的模型。有工作将 15B 模型剪到 8B 几乎无精度损失,剪到 4B 才出现一定下降。
**投机解码(Speculative Decoding)**是最优雅的方案,能"鱼与熊掌兼得"。它利用了检查(prefill)比生成更快这一非对称性:用一个廉价的草稿模型(draft model)超前生成 K 个 token,再用目标模型并行验证,以 Q/P 的概率接受每个 token(本质是拒绝采样/Metropolis-Hastings 思想)。这保证了得到的样本与目标模型精确一致,实践中通常带来约 2 倍加速。典型配置是 8B 目标模型配 1B 草稿模型,Medusa、Eagle 等改进还能让草稿模型并行采样或复用目标模型的高层特征。
投机解码的正确性保证值得单独说明。草稿模型生成的 token 并非直接采用,而是通过一个严格的接受-拒绝步骤过滤:对第 i 个草稿 token x,以概率 min(1, P_target(x)/P_draft(x)) 接受,否则从修正分布中重新采样。这一机制本质上等价于 Metropolis-Hastings 算法,保证最终输出的 token 序列在统计分布上与单独运行目标模型完全相同——这与知识蒸馏或量化不同,后者会改变模型输出分布,而投机解码是无损加速。加速效益取决于草稿模型的"命中率":如果草稿模型与目标模型足够相似(如同一系列的小/大版本),大部分 token 都能被接受,每次验证批次的平均接受长度可接近 K,从而趋近理论上限的 K 倍加速;如果两者差异大,频繁拒绝反而会引入额外开销。
系统层面的服务优化
真实服务场景中,请求在不同时间到达、不同时间结束、有的共享前缀、长度各异,非常异构。连续批处理(continuous batching)让新请求随时插入而不等待整批完成;选择性批处理(selective batching)对注意力单独处理、对 MLP 将不同长度张量展平后一起计算。
PageAttention(vLLM 背后的技术)借鉴操作系统的虚拟内存思想,将 KV 缓存切分为连续块并按需分配,解决内存碎片问题;对共享前缀还可用写时复制(copy-on-write)加引用计数来节省内存。
连续批处理(continuous batching)解决的是传统静态批处理的低效问题。静态批处理要求一批请求同时开始、同时结束,短请求需等待最长请求才能释放资源,GPU 利用率因此大打折扣。连续批处理将推理服务器视为流水线:每次迭代完成后立即检查是否有请求生成结束,将其移出批次,并将等待队列中的新请求填入,使 GPU 始终保持满负荷运行。PageAttention 将 KV 缓存切分为固定大小的"页"(page),类似操作系统管理物理内存页,不要求为每个请求预先分配连续的最大长度内存,从而消除内部碎片,并允许多个共享相同前缀(如 system prompt)的请求通过页表映射复用同一物理内存块,显著降低显存占用,这是 vLLM 能大幅提升吞吐量的核心原因。
结语
推理的世界远比"部署一个聊天机器人"要宽广。它内存受限、动态多变,带来一系列训练中不存在的挑战。真正的性能突破往往不来自系统优化本身,而来自架构层面的根本性变革——你关心的从来不是"如何运行这个特定模型",而是"在给定资源预算下交付最好的精度"。无论是缩减 KV 缓存、改造 Transformer,还是转向 SSM 和扩散模型,本质都是在规避推理的根本障碍。
相关推荐
Meta Muse为何爆红?AI创作工具新范式深度解析
Meta Muse为何爆红?AI创作工具新范式深度解析
Meta推出的AI创作工具Muse凭借多模态融合、低门槛交互和社交传播优势迅速走红。本文深度解析Muse爆红背后的产品逻辑、用户真实反馈,以及字节跳动、腾讯等国内玩家的竞争机会。
Claude Code 完全入门:非程序员也能一下午造出真实应用
非程序员如何用 Claude Code 一下午构建真实应用?本文完整拆解 theMITmonk 的入门教程,包括 BITE 四步框架、MVP 思路、模型分工技巧,以及从计时器到关系管理器 Orbit 的实战全过程。
Claude Code是什么?零基础程序员的AI编程新工具
Claude Code 是什么?本文解析这款 AI 编程工具如何让零基础程序员快速上手,从入门到构建企业级 Agent 的学习路径,以及如何理性看待训练营类课程。