生产级Agentic RAG实战课程:从检索到智能体的开源教程
一个聚焦生产级Agentic RAG工程实践的开源Python课程,已获近万Star,受AI社区广泛关注。
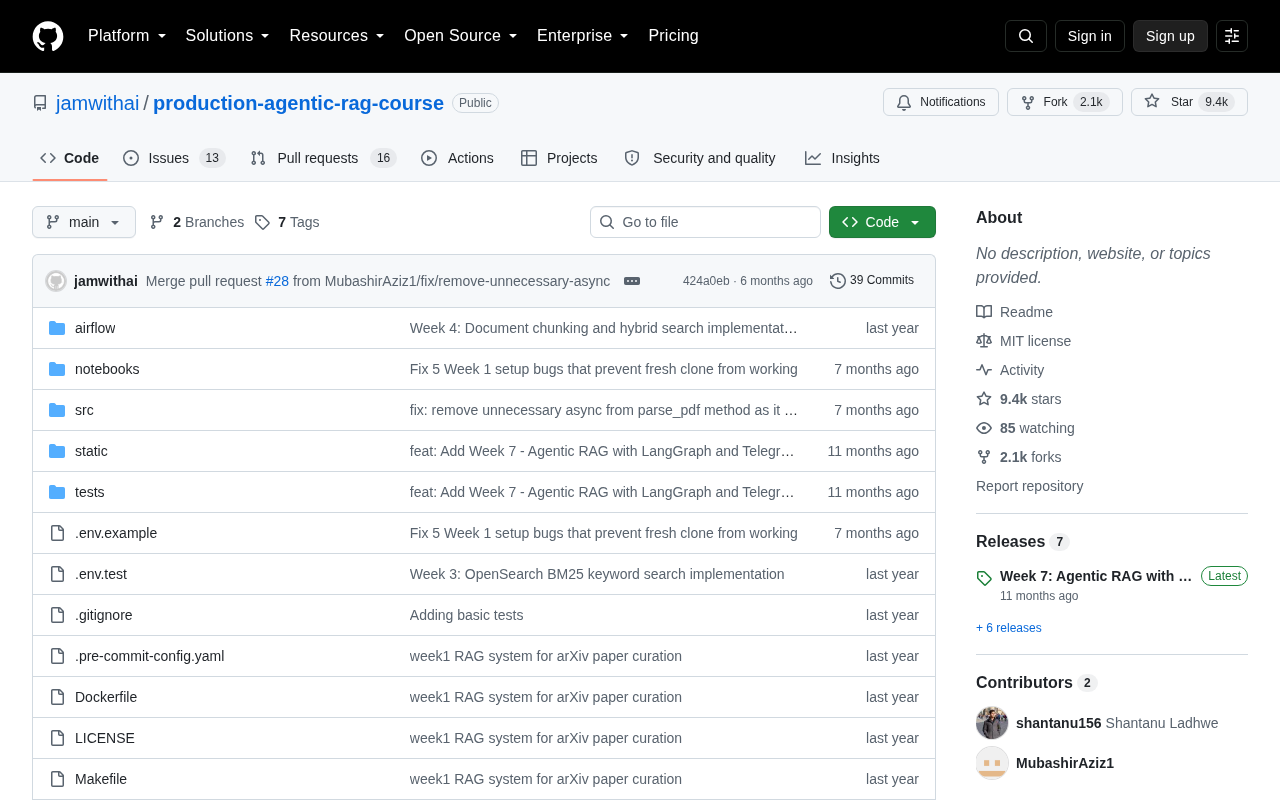
GitHub上的开源项目`production-agentic-rag-course`以9410个Star和2071个Fork迅速走红,反映出AI工程社区对「生产级Agentic RAG」的强烈需求。相较于传统线性RAG的「一次检索即生成」模式,Agentic RAG引入智能体决策机制,使系统能够自主判断检索时机、改写查询、调用外部工具,从而应对多步推理与复杂查询场景。该课程以Python为主力语言,重点不在概念演示,而在于补全检索质量评估、延迟控制、可观测性等生产环境必须面对的工程问题,适合已掌握基础RAG、希望将AI应用真正推向上线的工程师与团队。这一项目的走红,折射出整个行业从「能跑通的Demo」向「可上线的稳定系统」加速演进的趋势。
一个值得关注的开源RAG学习项目
在GitHub上,一个名为 jamwithai/production-agentic-rag-course 的开源项目正在快速积累人气。目前该仓库已收获 9410 个 Star 和 2071 个 Fork,并在单日内新增 193 个 Star,显示出社区对生产级 Agentic RAG这一主题的强烈兴趣。
这个项目以 Python 为主要语言,定位为一套面向工程落地的检索增强生成(RAG)教程,重点不在于概念演示,而在于把 RAG 系统推向真正可用于生产环境的工程实践。对于正在从 Demo 走向上线的开发者和团队来说,这类聚焦“生产级”的教程往往比零散的博客文章更具参考价值。
为什么是 Agentic RAG
传统 RAG 的流程相对线性:用户提问,系统检索相关文档,再把检索结果拼接进提示词交给大模型生成回答。这种模式在简单问答场景下表现尚可,但一旦遇到需要多步推理、跨多个数据源整合信息,或是需要根据中间结果动态调整检索策略的复杂任务,线性 RAG 就会显得力不从心。
Agentic RAG 的核心思路,是把“智能体(Agent)”的决策能力引入检索流程。系统不再是一次性检索后生成,而是能够自主判断何时检索、检索什么、是否需要重新检索或改写查询,甚至调用外部工具来补全信息。这种从“被动管道”到“主动决策”的转变,正是该课程命名中 Agentic 一词所强调的重点。
项目名称中的 production 则点出了另一层价值:许多 RAG 教程止步于能跑通的原型,而生产环境还需要考虑检索质量评估、延迟与成本控制、错误处理、可观测性等一系列工程问题。将 Agentic 架构与生产级要求结合,是这个课程区别于普通入门教程的关键定位。
从技术实现角度来看,Agentic RAG 通常依赖ReAct(Reasoning + Acting)框架或工具调用(Tool Use)机制,让大模型在生成回答之前能够循环执行「思考→行动→观察」的步骤。例如,模型可以先分析问题是否需要分解为多个子查询,对每个子查询分别检索,再综合多轮检索结果得出最终答案。与此同时,Agentic RAG 还常与查询改写(Query Rewriting)、**自我批判(Self-Critique)和路由(Routing)**等模块结合:当检索结果相关性不足时,系统可以自动改写查询词或切换到不同的向量数据库。这些机制虽然显著提升了系统的复杂查询能力,但也带来了更高的延迟和不确定性,如何在能力与工程稳定性之间取得平衡,正是生产级教程需要重点解决的问题。
项目热度与社区信号
从数据看,这个仓库的受欢迎程度相当可观。近万的 Star 数配合超过两千的 Fork,说明不仅有大量开发者收藏关注,还有相当比例的人选择 Fork 下来动手实践或二次开发。单日 193 Star 的增长速度,也反映出它正处于一个较强的上升期。
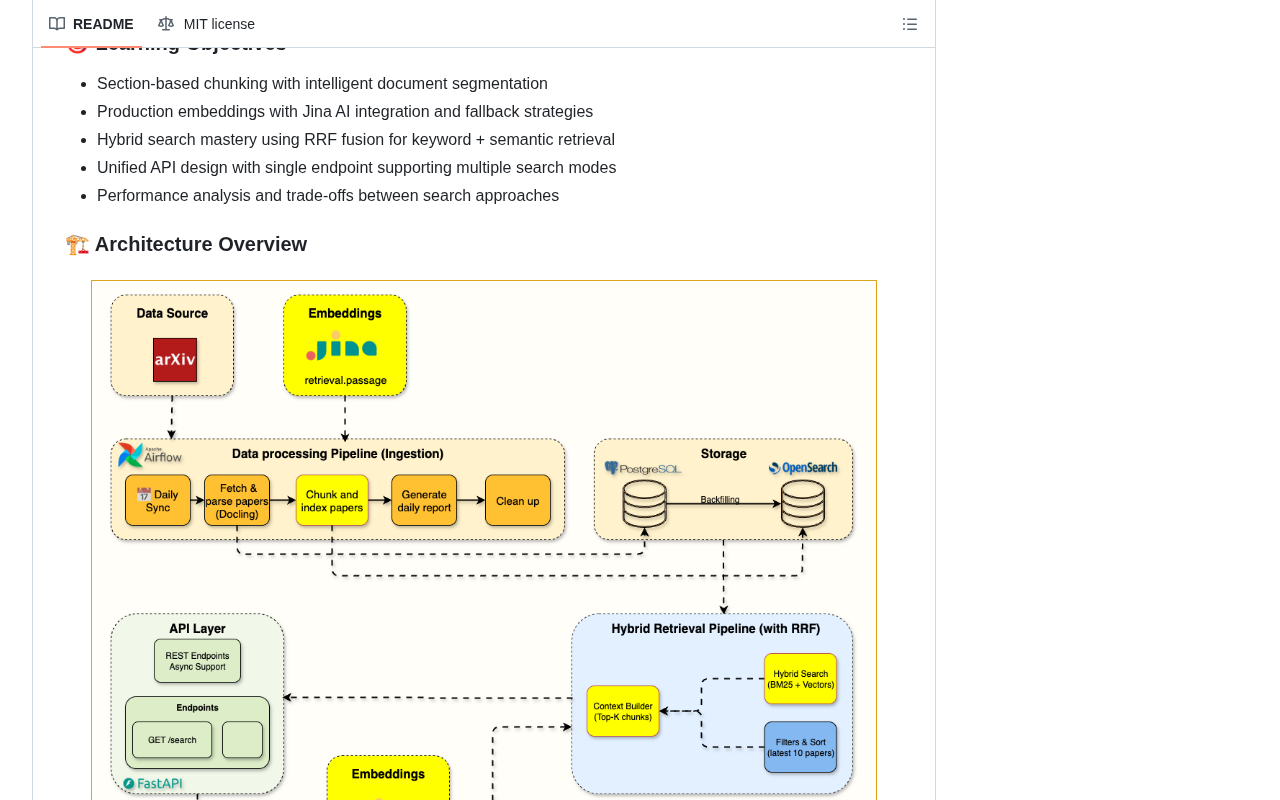
对于评估一个开源学习资源是否值得投入,社区活跃度是重要参考。较高的 Fork/Star 比例通常意味着内容的可操作性强——人们不是单纯点赞,而是真的把代码拉下来跑。以 Python 作为主力语言,也降低了 AI 工程领域从业者的上手门槛,因为当前主流的 RAG 与 LLM 生态(如 LangChain、LlamaIndex 等)大多以 Python 为核心。
适合哪些人学习
结合项目定位,这类课程比较适合以下几类读者:
- 已经了解基础 RAG、希望进阶的工程师:如果你已经能搭建一个简单的问答机器人,但不清楚如何让它在真实业务中稳定可靠,这类生产级教程能补齐工程短板。
- 正在构建 AI 应用的团队:需要把检索与智能体结合,处理复杂查询或多数据源场景的产品团队,可以从中获得架构参考。
- AI 领域的学习者与研究者:希望系统理解 Agentic RAG 工作机制、而非仅停留在概念层面的人。
需要说明的是,由于当前可获取的公开信息主要来自仓库的基础元数据(语言、Star、Fork 数量),课程的具体章节结构、依赖技术栈和配套实践内容还需进一步查阅仓库本身。建议感兴趣的读者直接访问该 GitHub 仓库,查看 README 与目录结构来判断是否契合自身需求。
从技术门槛来看,理解本课程内容通常需要具备以下基础:熟悉 Python 异步编程、有向量数据库(如 Pinecone、Weaviate、Chroma 等)的基本使用经验,以及对大模型 API 调用(如 OpenAI、Anthropic 等)有一定了解。向量数据库是 RAG 系统的核心组件之一,它将文本转化为高维向量后存储,并通过近似最近邻(ANN)搜索快速找到语义相近的文档片段,其检索效率和索引策略直接影响 RAG 系统的整体延迟与质量。对于尚未接触过向量检索的读者,建议在学习本课程前先补充相关基础,这样在进入 Agentic 决策层的内容时会更易上手。
小结
production-agentic-rag-course 的走红,折射出整个 AI 工程社区的一个明显趋势:从“能用的 Demo”转向“可上线的系统”,从“单次检索生成”转向“具备自主决策能力的智能体架构”。对于想要把 RAG 真正落地的开发者而言,这类聚焦生产实践的开源教程,正是当下稀缺且有价值的学习资源。
相关推荐

xAI的Agent优势:把X实时数据变成模型工具
解析xAI为Grok打造的Agent能力:将X实时数据与Web作为模型工具,支持服务端工具调用、OpenAI兼容API和Beta多Agent架构。深入剖析其作为实时工具层的优势与作为完整Agent操作系统的不足。

Agent Gateway 接入 Cloud Trace:AI智能体请求的端到端追踪
Google Cloud 的 Agent Gateway 现已集成 Cloud Trace(预览阶段),可将一次 AI 智能体请求的智能体、网关、工具与 MCP 服务器全部调用收拢到同一条端到端追踪链路,基于 OpenTelemetry 标准实现,帮助开发者精准定位性能瓶颈。
OpenAI遭遇黑客入侵 Altman面临法律风险累积
OpenAI在内部调查中发现系统遭黑客入侵,CEO奥特曼同时面临法律风险累积。本文梳理AI公司数据安全隐患、企业治理争议与合规挑战,分析事件背后的行业启示。